
U2.1 沿著人潮學會怎麼走
本篇重用3 篇
上一篇中,我們有了新的、想解決的問題:兩個 distribution 之間的搬運。
我們也聊到可以把它想成:把一堆沙子從一種分布形狀,慢慢搬成另一種形狀。要描述這個搬運,我們需要決定兩件事:中間怎麼走(path),以及每個地方要往哪裡走(velocity)。
接下來的問題便是:
要怎麼知道每一個時刻該往哪裡走?
如果知道起點和終點的話
我們先把沙子換成人群。想像跨年煙火剛結束,人群正從台北 101 周圍散場,大家紛紛走向捷運站:有人去市政府站,有人走向台北 101/世貿站,也有人往象山站。
先想一個比較簡單的情況:假設每個人都知道自己的起點 與終點 。那麼要從起點走到終點,只要選一條在 從 出發、在 抵達 的曲線,記成
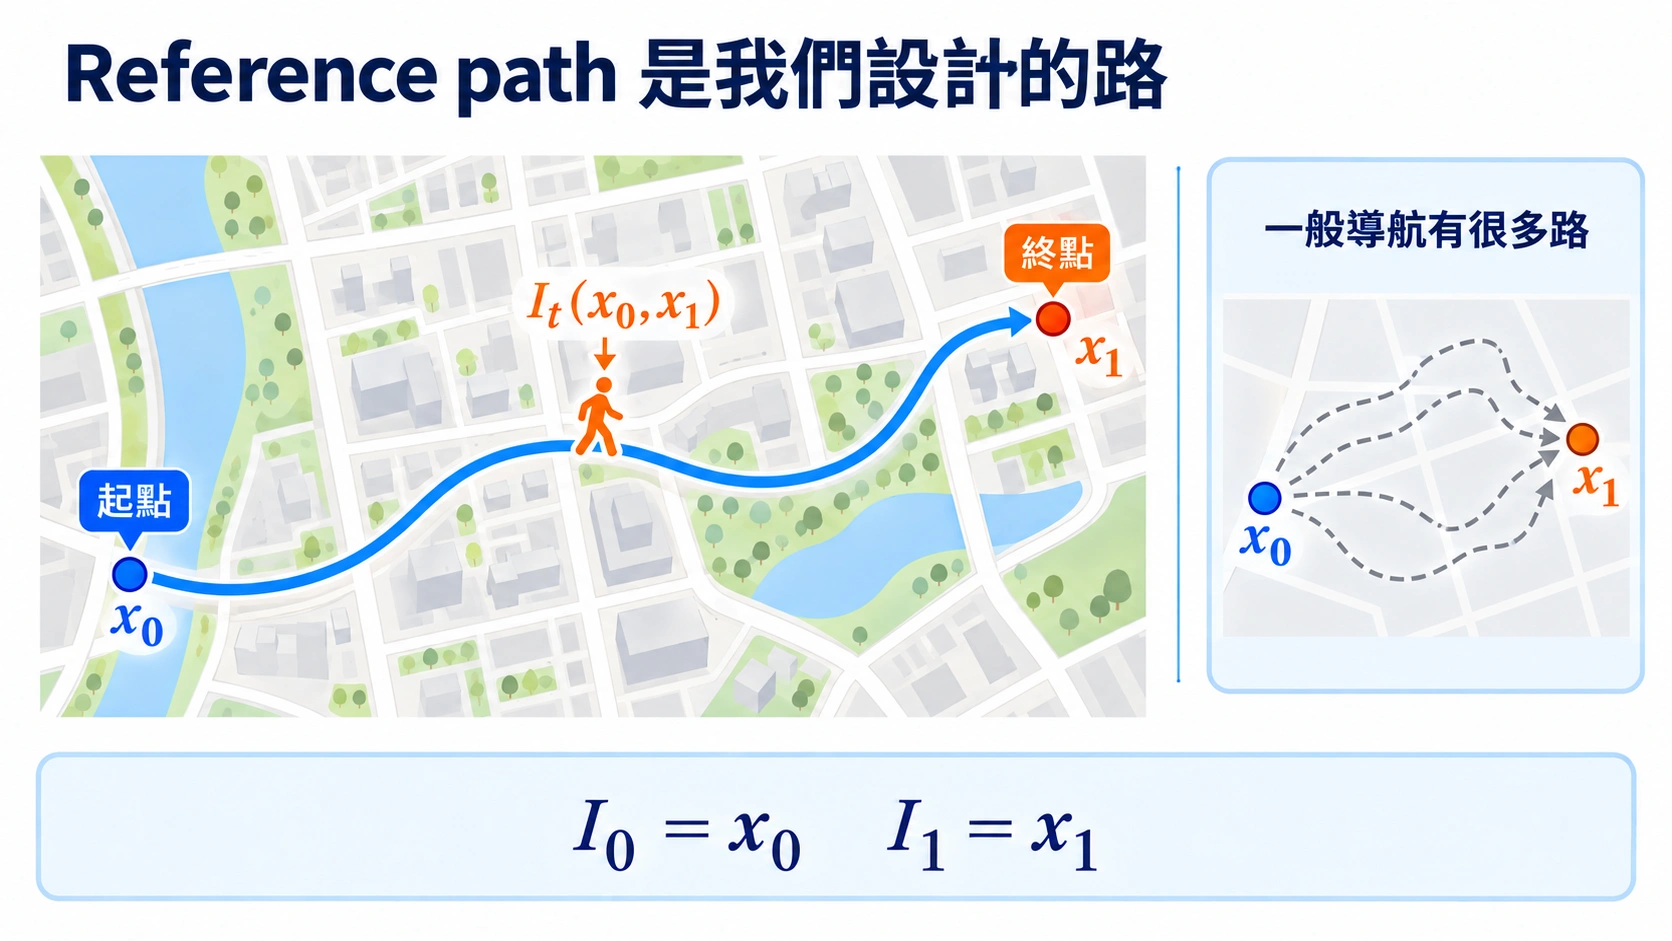
圖:先知道起點 與終點 ,才能替這一組端點畫出 ;路線可以彎,也可以直接選直線。
最簡單暴力的選擇,自然就是橫衝直撞地走直線:
只要給定一組 ,這條直線給出的位置變化和速度都可以直接算出來,不需要任何神經網路模型。
名稱端點也隨機之後,這個 construction 就是最簡單的 stochastic interpolant
固定 時, 是替這一組端點畫出的 reference path。訓練時改成抽隨機端點 後, 本身也成了 random variable;文獻把這種連接兩端 distributions 的 random process 稱為 stochastic interpolant。
這一篇先用 reference path 的說法,專心看單一路線怎麼產生 velocity label;U2.4 再正式展開 stochastic interpolant 的一般形式。
課堂提問Q1
雖然這個方法看起來超讚,但有一個問題藏在裡面。你看得出來嗎?
先想一想,再展開看整理後的答案
對生成模型來說,我們並不知道終點在哪裡;一開始只有起點。想像我們要轉換一張圖片的風格:給定的圖片是起點。如果終點圖片也已經知道了,直接回傳它就好,根本不需要再生成。
真正生成時,我們只會知道:
現在是時間 ,而我人在位置 。
我們並不知道自己對應到訓練資料裡的哪一組 。所以真正需要的,是一條所有人都能使用的規則:
可是,站在同一個街口,卻有人往三個不同的捷運站走。這個 velocity field 到底該聽誰的?
想像你就是那個不知道終點、手機沒電、也沒有地圖的迷路者。站在陌生的街口,你會怎麼做?
最自然的方法:隨人潮而動
想像一下,如果我們自己不知道該怎麼走,最自然的方法是什麼?答案很直覺:跟著人潮走。
站在時間 、位置 ,我們可以看看那些知道怎麼走的人——也就是前面已經畫好的 reference paths。看看哪些人的路徑剛好在時間 經過這裡,再參考他們當下的方向與速度。
我們也可以讓神經網路做一模一樣的事情。每一條 reference path 都告訴我們:在位置 、時間 時,應該有一個 reference velocity 。於是,我們把它當成 label,直接做 regression:
怎麼讓模型跟著這個人的速度走?
- 抽一組端點與時間 ,算出位置 ,得到輸入 。
- 讓模型在這個位置與時間,給出速度 。
- 這個人當下的速度是 ;拿它當 label,與模型的速度相減。
- 把速度差的長度取平方,衡量這一次跟得有多接近。
- 再對不同時間 與端點 的平方誤差取平均,也就是考慮所有我們能產生的 label,參考所有的速度作為學習目標。
也就是說,每次看到一條 reference path, 都會被要求:站在 這個位置時,盡量跟這個人的速度 一樣。
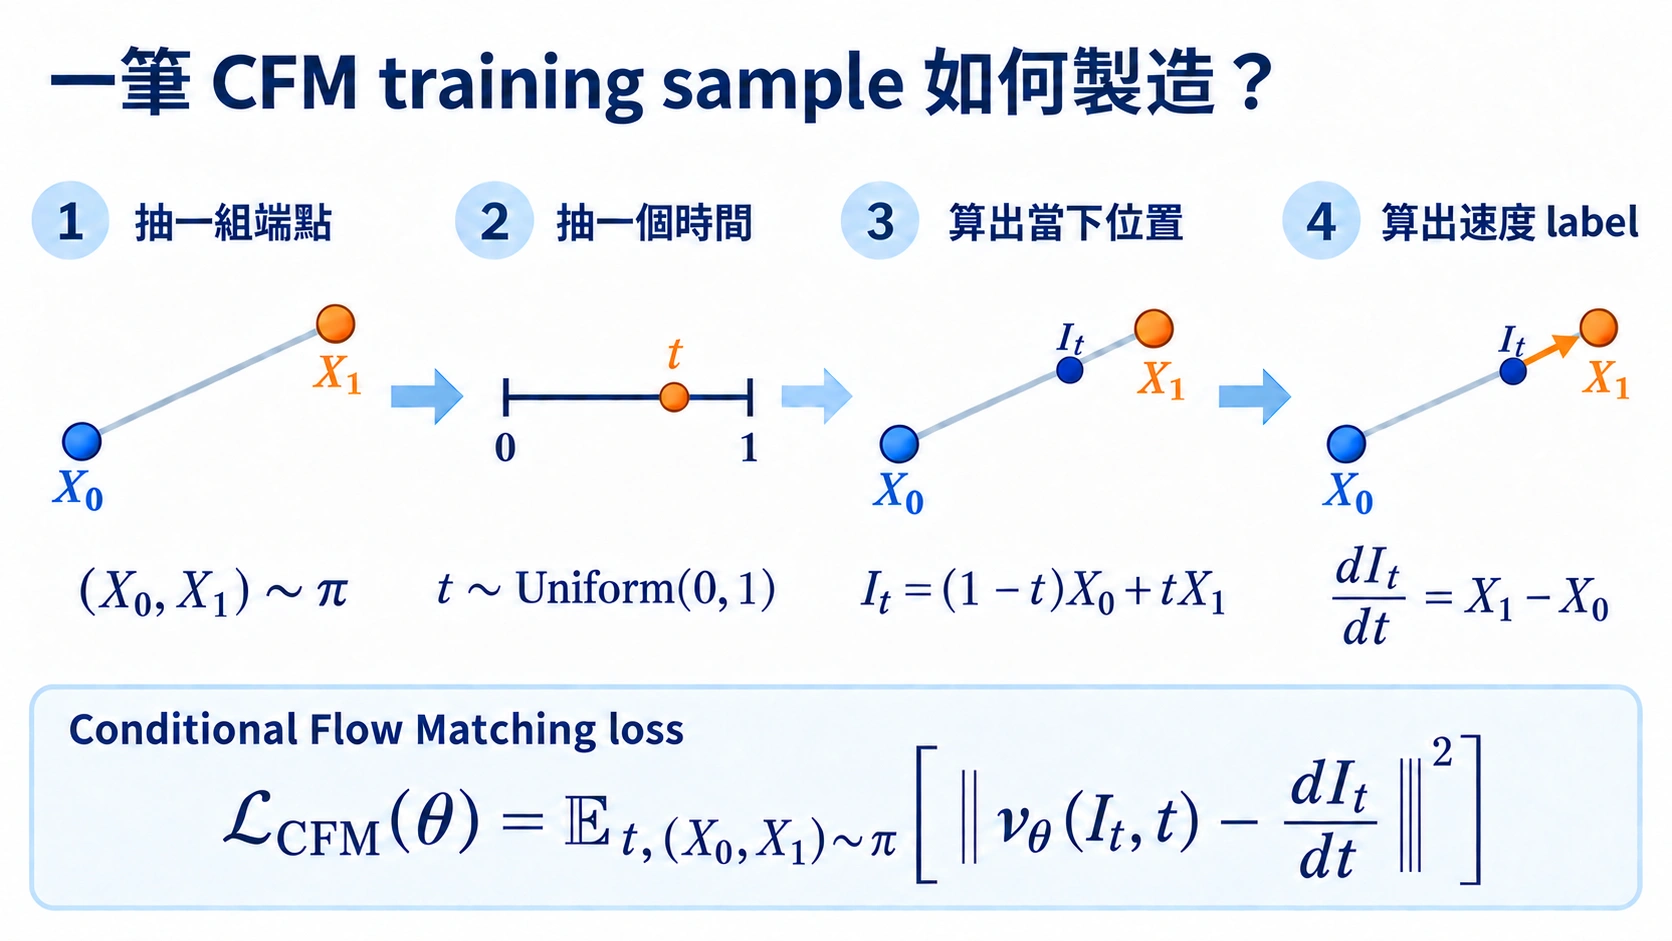
圖:一筆 training pair 的製造流程。直線只用來算出輸入 與速度 label ,不需要先跑一趟 ODE。
每次 training 時,我們只需要抽一組端點與時間 ,就能直接算出 與 ,不必先解 ODE、真的模擬一條 trajectory,才能製造這組 training pair。Lipman 等人的 Flow Matching 原論文 [1] 把這種訓練方式稱為 simulation-free training。
這裡的 simulation-free 只是在說訓練時不用解 ODE;模型訓練完成後,要沿著 learned velocity 生成資料,仍然需要 numerical solver。這件事會在〈訓練完之後,要怎麼真的沿著這個 field 走?〉再接著討論。
但還記得剛才的問題嗎?同一個時間 ,可能有很多條 reference paths 都經過同一個位置 。有人往市政府站,有人往 101/世貿站,也有人往象山站;可是 只能給出一個速度。那它到底該聽誰的?
L2 自己會完成「從眾」
咦?還記得我們在 U1 看過的事情嗎?當一個函數必須同時對很多不同的 target 最小化 L2 距離時,最好的選擇就是:取平均。
M1.2 已經證過:固定輸入之後,L2 regression 的最佳解就是 label 的 conditional mean。現在只要把輸入換成 ,把 label 換成 。先把 簡寫成 ,照剛才的想法,一部分一部分寫出來:
站在同一個街口,該聽誰的?
- 在時刻 、位置 ,該怎麼選速度?
- 先看此刻經過 的人:。
- 再看他們各自的方向與速度:。
- 依這個條件下的可能性,把這些速度取平均。
這條式子的意思,其實就是剛才的散場例子:
站在 ,看看所有可能在時間 經過這裡的人,再把他們的方向與速度取平均。
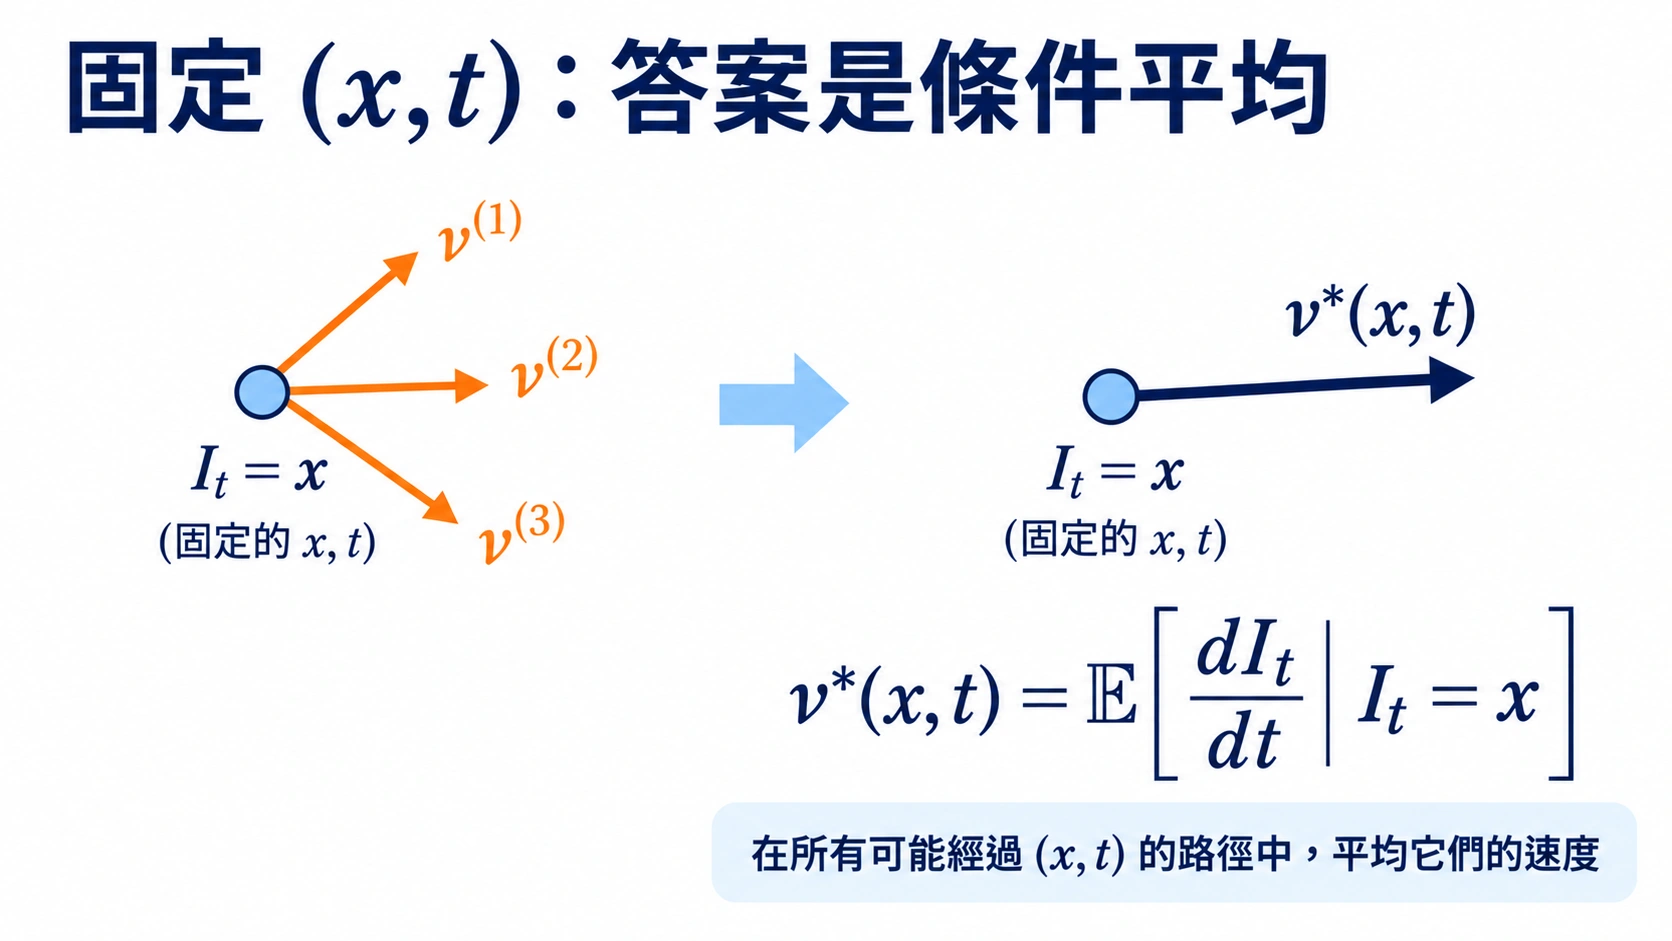
圖:固定 後,橘色箭頭表示相容的 reference velocities;深藍色箭頭是依它們的條件機率平均後得到的 。
所以,L2 objective 和 conditional expectation 並不是兩個分開的技巧。L2 objective 是我們實際拿來訓練的方法;conditional expectation,則是它在理想情況下學到的 velocity field。
你可以直接拖動黃色的迷路者,替它指定新的起點 。周圍的方向圓盤把相容的 reference velocities 依方向聚合:扇區越長、越亮,代表那個方向的 posterior signal 越強;黃色箭頭則是它們的 weighted average,也就是 。黃線記錄迷路者一路沿著 走出的 ODE trajectory:實線是已走過的部分,虛線是接下來的路。拖動時,時間會回到 ,再從新的起點向前計算整條軌跡;你也可以切換不同的 empirical target samples,看同一條公式如何產生不同的 flow。
這就是 Lipman 等人提出的 Flow Matching [1] 的核心做法:先製造容易監督的 reference paths,再讓 regression 把它們整理成一個共同的 velocity field。
訓練完之後,要怎麼真的沿著這個 field 走?
訓練完成後,模型給我們的是:站在任意位置 、時間 ,現在應該往哪裡走。要生成資料,我們先在 從起點 distribution 抽一個 ,再解
一般來說,這條 ODE 沒有 closed-form solution。所以實作時,我們會把 到 這個區間切成許多小段 ,再用 numerical solver 做近似迭代。沿用圖中的 notation,這一段用 記 sampler 在時間 算出的近似位置;若使用固定步長 ,最簡單的 Euler method 會採用
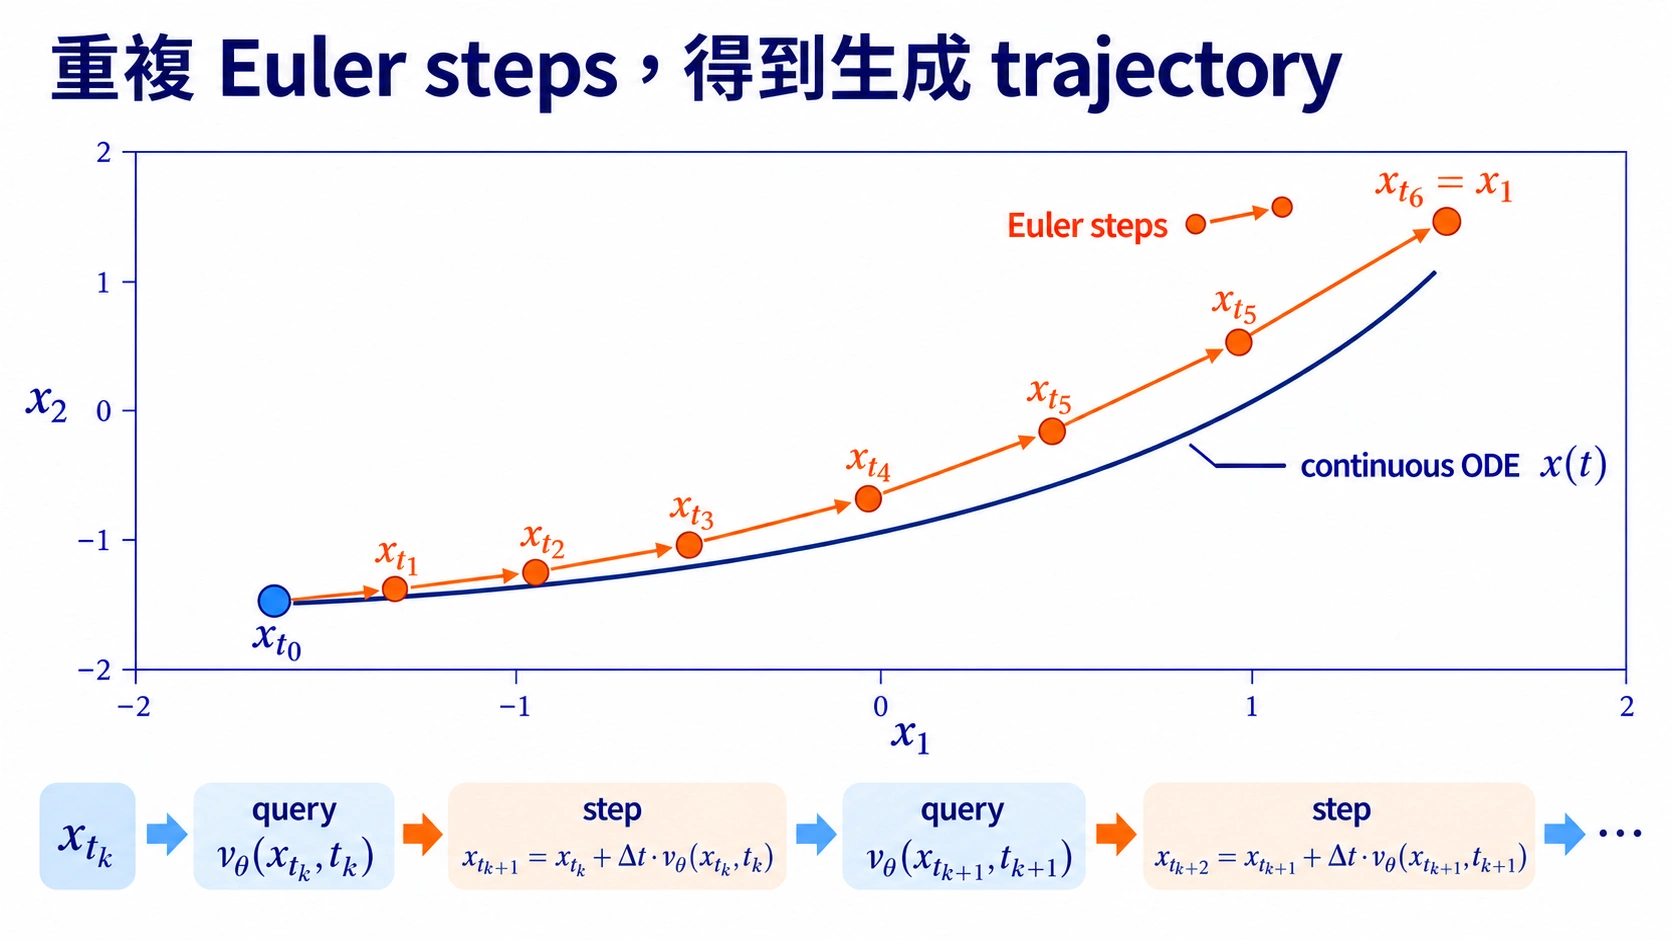
圖:在 詢問 ,再沿這個 velocity 走 ,得到 ;下一步從新位置重新詢問。
這條式子其實就很像迷路的人實際採用的做法:先問一次現在該往哪裡走,沿著這個方向走一小步,再從新的位置重新問一次。 每一步都要呼叫一次網路;而且就像黎曼積分一樣,通常切得越細,就走得越準,但生成也會越慢。
如果沿途的 velocity 幾乎不變,一大步也可能走得很好;如果方向或速度大小不斷改變,就必須頻繁確認。我們會在 U3 再回來看看:除了使用更準確的 numerical solver,能不能直接減少這些變化,讓少步 sampling 也能走得準。
快速回顧一下
參考文獻
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. ICLR 2023. (CFM objective 與 conditional vector fields。)