本篇重用2 篇
在 U2.2 的最後,我們留下了一個問題:如果把 X0 選成 U1 使用的 Gaussian noise,Flow Matching 學到的 velocity field,會不會和 DDIM 背後的 deterministic dynamics 有關?
在 U1,denoiser 從 noisy xt 預測 data 或 noise;到了 U2,Flow Matching 的 network 則要預測 velocity。它們的名字與輸出不同,但看到的都是同一個 xt。所以我們真正要確認的是:這些量能不能互相換算?
如果起點是 Gaussian,U1 的 denoiser
能不能直接給出 Flow ODE 需要的 velocity?
把 U1 中 forward process 決定的路徑,寫成 Flow Matching 的語言
我們沿用這個單元的時間方向:t=0 是 Gaussian、t=1 是資料。這和 U1 的 forward process 相反;U1 是從資料一路加 noise,這裡則要從 noise 走回資料。
為了分清兩邊的時間方向,這一段用 τ 表示 U1 從資料走向 noise 的時間,用 t 表示 Flow Matching 從 noise 走向資料的時間。U1.1 中的 noisy state 是
xτ=αˉτx0+στϵ.
現在反過來讀,並令 Flow Matching 的兩個端點為
X0=ϵ∼N(0,I),X1∼pdata,
用 Lipman 等人的 Flow Matching [3] 語言寫下來就是
It=αtX1+σtX0=αtX1+σtϵ,α0=0,σ0=1,α1=1,σ1=0.
其中:
- αt 是 data 的 signal amplitude,對應 U1.1 裡的 αˉ。注意,它不是 U1.1 中表示單一步保留率的 αs=1−βs;
- σt 是 noise amplitude,對應 U1.1 裡的 1−αˉ;
- 因為 U1 使用的是 variance-preserving path,兩者滿足 αt2+σt2=1。
只是現在時間反過來讀:αt 從 0 增加到 1,σt 則從 1 降到 0。U1 的 noise schedule 決定的,就是 data 與 noise 在這條路上交接的速度。
接下來,我們從這個由 DDPM 定義出來的 xτ 出發,看看反向讀取後的 It 所對應的 Flow Matching velocity 是什麼。
給定一組 (X1,ϵ),reference velocity 直接對 It 微分就可以得到:
I˙t=α˙tX1+σ˙tϵ.
此時,依照 U2.1 的結論,optimal velocity field 會等於
vt⋆(x)=E[I˙t∣It=x]=E[α˙tX1+σ˙tϵ∣It=x].
連結到 DDPM、DDIM 的 denoiser
接下來從條件 It=x 出發:
x=αtX1+σtϵ.
當 αt>0 時,可以把 X1 寫成 x 與 ϵ 的關係:
X1=αtx−σtϵ.
再代回 reference velocity:
I˙t=α˙tX1+σ˙tϵ=αtα˙tx+(σ˙t−αtα˙tσt)ϵ.
現在才對所有滿足 It=x 的可能來路取平均:
vt⋆(x)=αtα˙tx+(σ˙t−αtα˙tσt)E[ϵ∣It=x].
所以只要知道「在這個 x 裡平均含有多少 noise」,就能得到 optimal velocity。把 t 對回 U1 中相同的 noise level,DDPM、DDIM 的 denoiser 估計的正是
ϵθ(x,t)≈E[ϵ∣It=x]=−σt∇xlogpt(x),
其中最後一個等號就是 U1.3 的 Tweedie 公式。代回上式,就得到 denoiser 與 velocity 的轉換公式:
若改用 score 表示,同一條式子則是
vt⋆(x)=αtα˙tx−σt(σ˙t−αtα˙tσt)∇xlogpt(x).
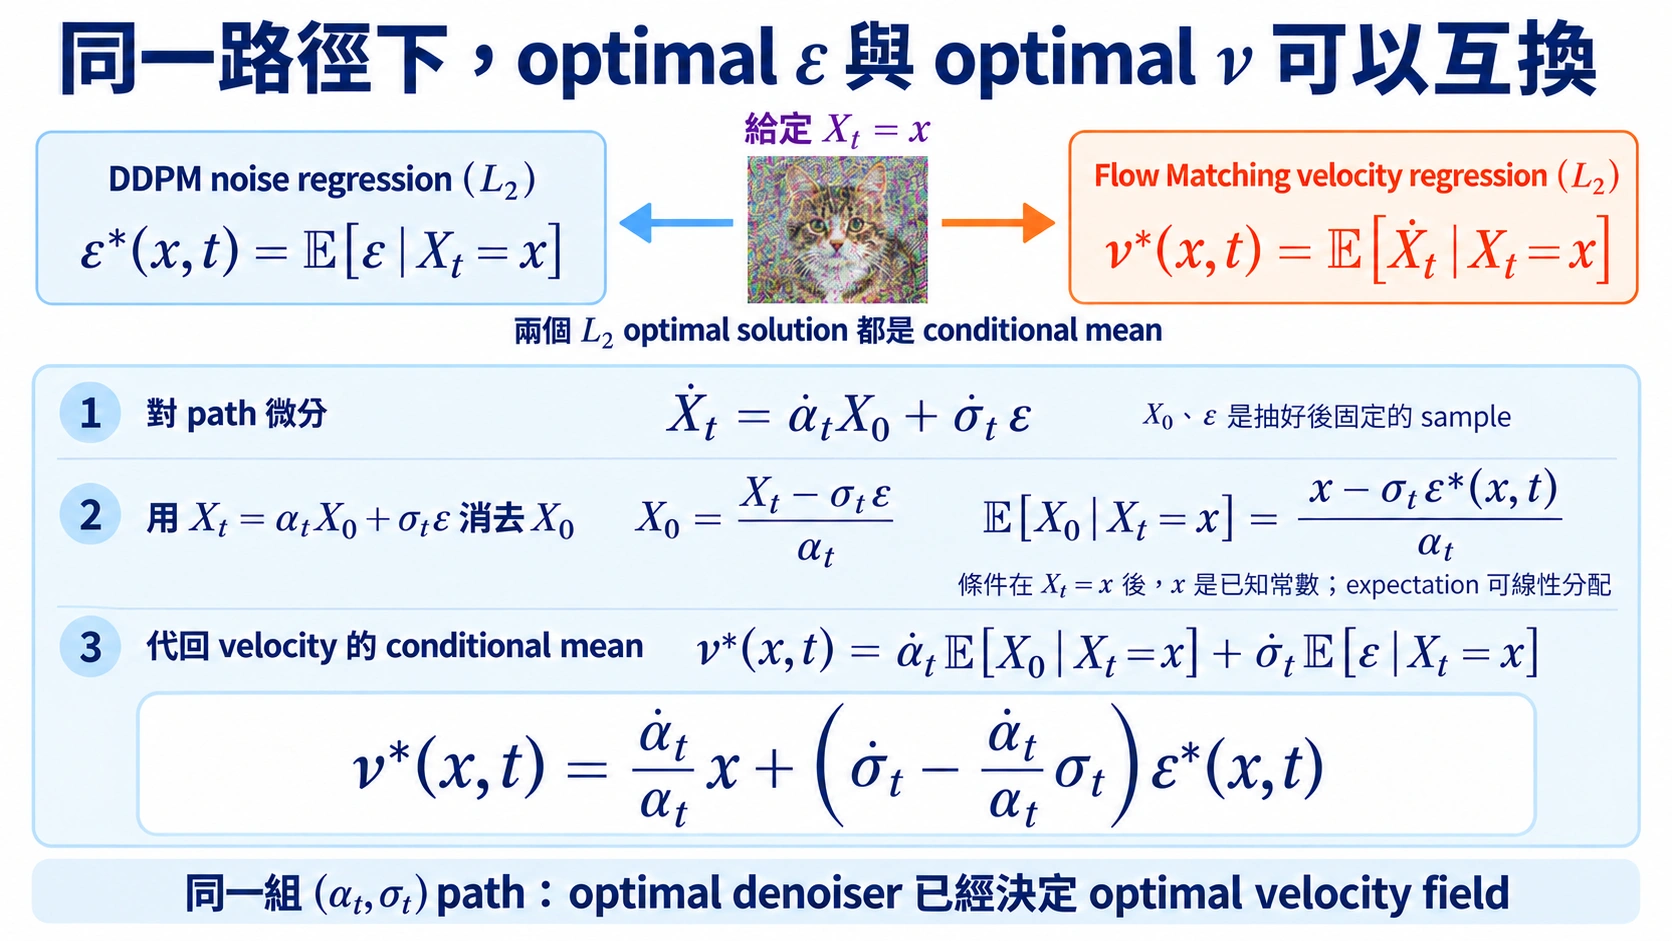
圖:固定同一個中間狀態,noise regression 平均的是 ϵ,velocity regression 平均的是路徑速度。圖中的 Xt 對應本篇的 It;兩者的換算必須使用同一條 interpolation。
Week 4 投影片 44 · 點圖查看原圖
這不是重新訓練另一個模型,只是把同一個 conditional mean 改寫成不同的形式。
Noise、score 與 velocity 不是三個互不相關的學習目標;在同一條由 DDPM forward process 定義的 VP interpolation 上,它們可以互相換算。
把 DDIM 的一步縮小,會看到什麼?
到這裡,我們只證明了 U1 的 denoiser 可以換算成 Flow Matching 的 velocity。但開頭問的問題還多了一步:這個 velocity 真的是 DDIM 背後的 deterministic dynamics 嗎?
回到 U1.4。在 U1 的時間方向裡,τ=0 是資料、τ=1 是 noise。當 η=0 時,Song、Meng 與 Ermon 的 DDIM [1] 不再加入新的 randomness,而是用同一組 x0 與 predicted noise,直接重建另一個 noise level:
xs=αˉsx0(xτ,τ)+σsϵθ(xτ,τ),s<τ.
其中
x0(xτ,τ)=αˉτxτ−στϵθ(xτ,τ).
所以目前的 xτ 也可以寫成
xτ=αˉτx0(xτ,τ)+στϵθ(xτ,τ).
把兩個時刻相減,就得到
xs−xτ=(αˉs−αˉτ)x0(xτ,τ)+(σs−στ)ϵθ(xτ,τ).
現在讓 s 越來越靠近 τ,再除以 s−τ:
dτdxτ=dτdαˉτx0(xτ,τ)+σ˙τϵθ(xτ,τ)=dτdlogαˉτxτ+(σ˙τ−dτdlogαˉτστ)ϵθ(xτ,τ).
這正是上一節得到的 velocity 轉換公式,只是現在沿用 U1 從 data 走向 noise 的時間方向。DDIM 的 deterministic update 一旦縮到連續時間,就會走向同一條 Flow ODE。
代入 VP schedule,就會得到哪一條 ODE?
接下來只差把 DDPM 的 schedule 代進去。由 αˉ˙τ=−β(τ)αˉτ,data 係數的變化率是
dτdlogαˉτ=−21β(τ).
而 στ2=1−αˉτ,所以
2στσ˙τ=β(τ)αˉτ.
再用 ϵθ(xτ,τ)≈−στ∇logpτ(xτ),score 前面的係數會變成
−στ(σ˙τ+21β(τ)στ)=−21β(τ)(αˉτ+στ2)=−21β(τ).
因此,DDIM 縮到連續時間後得到
dτdxτ=−21β(τ)xτ−21β(τ)∇logpτ(xτ).
這就是 Song 等人 [2] 寫下的 probability-flow ODE。生成時,DDIM 從 noise 端往回走,也就是沿著這條 ODE 把 τ 從大積到小。
所以這裡的關係是:DDPM 與 DDIM 用相同的 denoising objective 學 conditional mean;這個 conditional mean 可以換成 VP interpolation 上的 velocity;而 DDIM 的 η=0 update,則是這條 continuous dynamics 的一種有限步走法。
注意可以換座標,不代表可以偷換路徑
上面的 (αt,σt) 必須對應模型 training 時使用的 VP interpolation。把這條 interpolation 訓出的 ϵθ,直接配上 It=tX1+(1−t)X0 的係數,會把網路帶到它沒看過的 pt 上。
不用重訓能換的是 noise/score/velocity 的表示方式,不是中間的 probability path。
Flow Matching 多給了什麼?
到這裡,我們已經看到:DDIM 背後的 deterministic dynamics,其實和對應的 Flow Matching ODE 是同一件事。 兩者最後都可以寫成
dtdXt=vt(Xt),
只是從不同的角度得到 velocity field vt。既然 DDIM 已經是一條 flow,Flow Matching 真正多給我們的就不是另一種 ODE,而是可以直接設計:
- 起點 distribution p0;
- 中間的 reference path It;
- 起點與終點如何配成 (X0,X1)。
最自然的第一個嘗試,就是把每一組端點直接連成直線:
It=(1−t)X0+tX1,I˙t=X1−X0.
每個人的 reference velocity 都是常數;如果生成時真的沿著其中一條 reference path 前進,看起來只要一步 Euler 就能從起點走到終點。
| 設計 | DDPM/DDIM | Flow Matching |
|---|
| 起點 | Gaussian prior | 可以是任意 p0 |
| Reference path | 由 noise schedule 決定 | 可以自行選擇 It |
| 配對方式 | Gaussian noise 與資料獨立配對 | 可以自行決定起點與終點如何配對 |
| 網路輸出 | 常用 noise/score | 直接預測 velocity,也可換其他 parametrization |
同一條 VP interpolation 上,noise、score 與 velocity 可以互換;一旦改了 reference path 或端點的配對方式,中間的 pt 與 optimal velocity 就一起改變,不能只換公式而不重訓。
補充Velocity MSE 換成 noise MSE 時,權重也會改變
在線性 path It=tX1+(1−t)ϵ 上,
ϵ=It−tI˙t,vθ(x,t)=tx−ϵθ(x,t).因此
∥vθ−I˙t∥2=t21∥ϵθ−ϵ∥2.所以「同樣可以預測 noise」不代表 training objective 完全相同。線性 Flow Matching 若均勻抽 t,換到 noise 座標後會自然帶出 1/t2;DDPM 常用的 Lsimple 則是均勻 noise MSE。
快速回顧一下
參考文獻
- Song, J., Meng, C., Ermon, S. Denoising Diffusion Implicit Models. ICLR 2021. (Non-Markovian coupling、deterministic sampling 與 ODE form。)
- Song, Y., et al. Score-Based Generative Modeling through Stochastic Differential Equations. ICLR 2021. (Probability-flow ODE。)
- Lipman, Y., et al. Flow Matching for Generative Modeling. ICLR 2023. (Gaussian probability paths 與 velocity regression。)
