
U2.0 Forward Process 是必要的嗎?
DDPM、DDIM 的其中一端是 Gaussian
在 U1,我們從 Gaussian noise 出發,透過 denoising process 逐步生成資料。Gaussian 容易抽樣,線性組合後仍然是 Gaussian;這些性質讓 可以直接算,也讓 denoising 能化成簡單的 regression。
但如果今天的問題不是「從 noise 生成資料」,而是把一個指定的 distribution 搬到另一個 distribution 呢?
如果我們想把真實照片轉成卡通風格,
起點明明是真實照片,為什麼還要先把它變成 Gaussian?
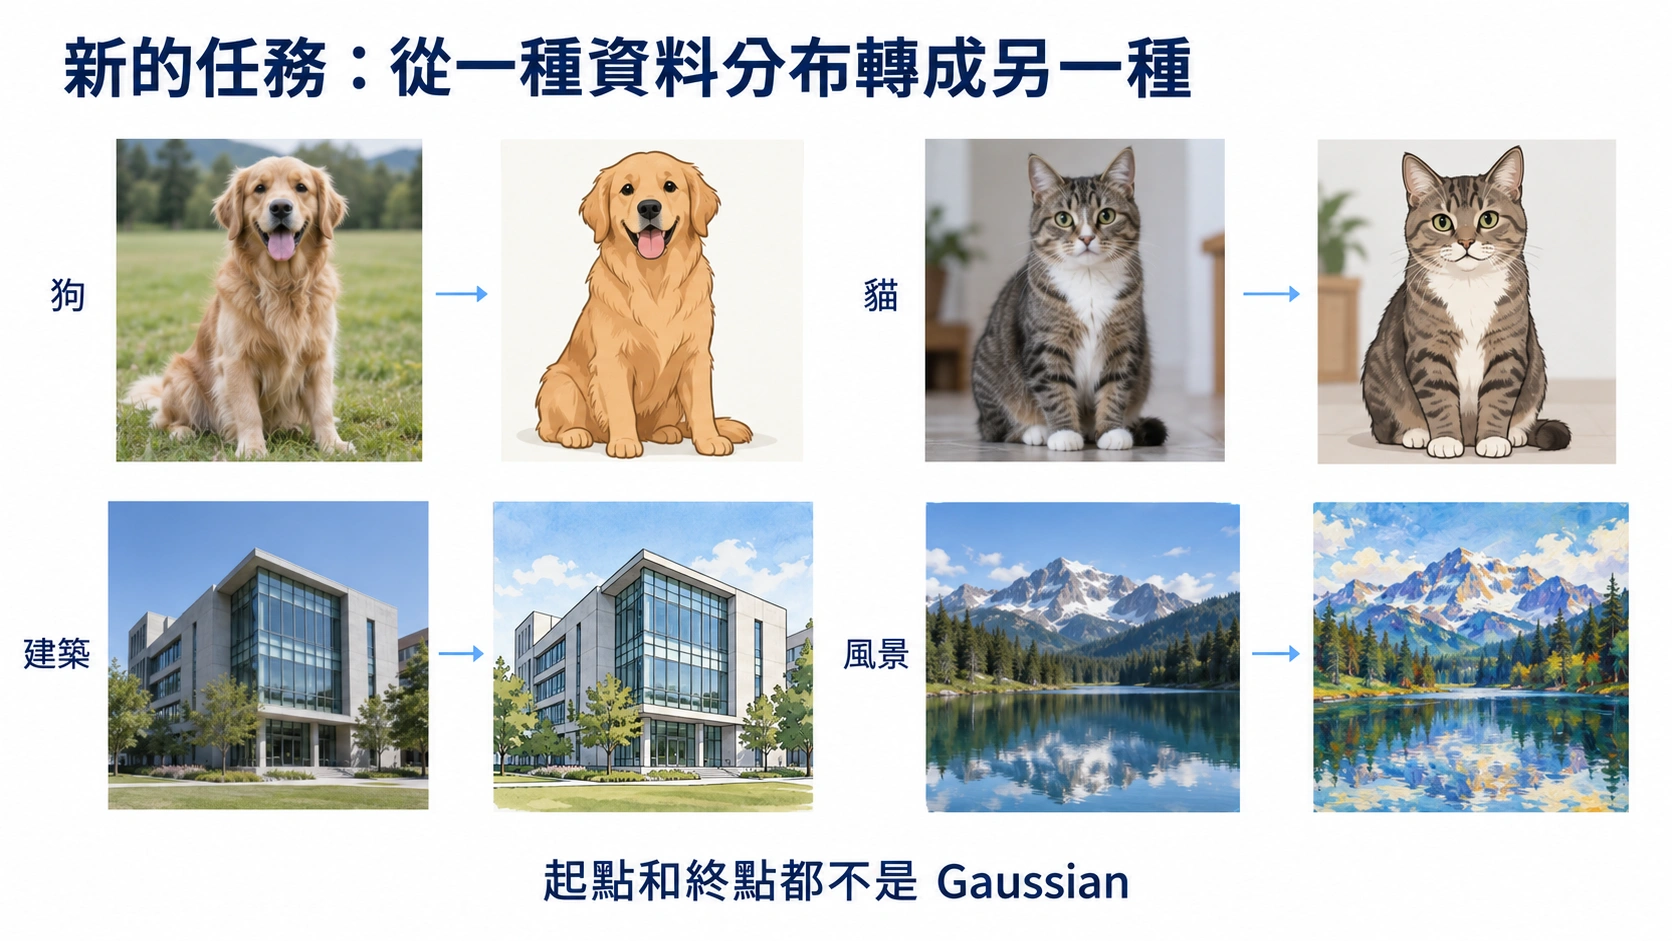
圖:從照片分布搬到卡通或繪畫分布,兩端都不是 Gaussian。這裡要放開的是 U1 生成設定中固定的 Gaussian 起點。
U1 中的生成設定是
而我們現在想直接處理
其中 、 都可能不是 Gaussian。
回頭看看 U1 的策略
U1 一開始想學一個複雜的 transport map ;後來透過 forward process 製造中間的 ,把「一次走完全程」改成「一步步修正」。DDIM 又讓我們看到,這些小步可以連成一條 deterministic flow。
那一個很自然的想法就出來了:
給定 與 ,我們能不能也先決定中間的 ,再學一個 flow,把 慢慢搬成 ?
想像 是海邊一堆沙現在的形狀, 是我們想堆成的形狀。搬運不是瞬間完成的:每一粒沙的位置 都會隨時間改變,而物理中描述位置如何改變的量就是速度。
所以我們要找的是一個 velocity field:
把局部速度接成一條路
- 用 記這粒沙在時間 的位置;它是我們要一路更新的量。
- 給出這個時間、這個位置的移動方向與速度大小。
- 讓位置的瞬間變化率等於剛才的速度,便得到 flow ODE。反覆照這個規則走,才形成整條 trajectory。
回答的是一個很局部的問題:時間 、位置 的這粒沙,現在該往哪裡走、走多快? 所有沙粒都反覆照這個規則移動,整個 distribution 就會被逐步搬運。
但 ODE 只告訴我們「拿到 之後怎麼走」,還沒有說 從哪裡來。
Lipman、Chen、Ben-Hamu、Nickel 與 Le [1] 提出的 Flow Matching,正是從這個缺口出發:先造出中間路徑,再讓網路學會推動它的 velocity field。
快速回顧一下
參考文獻
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. ICLR 2023.