學完這篇,你能
可以往回倒帶一格,為什麼不能直接快轉呢? Denoiser 告訴我們當下該怎麼往回走,但 DDPM 的 reverse Gaussian 是針對相鄰小步建立的近似;一步跨得越大,真正的 reverse distribution 越不像單一 Gaussian,近似誤差也會跟著放大。如果不能放大原本的一步,還有哪裡可以改? 回頭檢查 denoising loss 實際看見的資訊,從「marginals 被固定、跨時間的 joint 沒有」推出新的 generative process,最後才得到 deterministic 與跳步取樣。離散公式背後是哪一條運動規則? 寫出 forward SDE、reverse SDE 與 probability-flow ODE,並分清 score、dynamics 與數值步長各自決定什麼。
本篇重用 6 篇 會倒帶一格,還不等於能快轉
在 U1.2 中,我們已經提過要怎麼生成資料了:從 x T ∼ N ( 0 , I ) x_T\sim\mathcal N(0,I) x T ∼ N ( 0 , I ) x ^ 0 \hat x_0 x ^ 0 ϵ ^ \hat\epsilon ϵ ^ x t − 1 x_{t-1} x t − 1
我們已經知道怎麼倒帶一格;
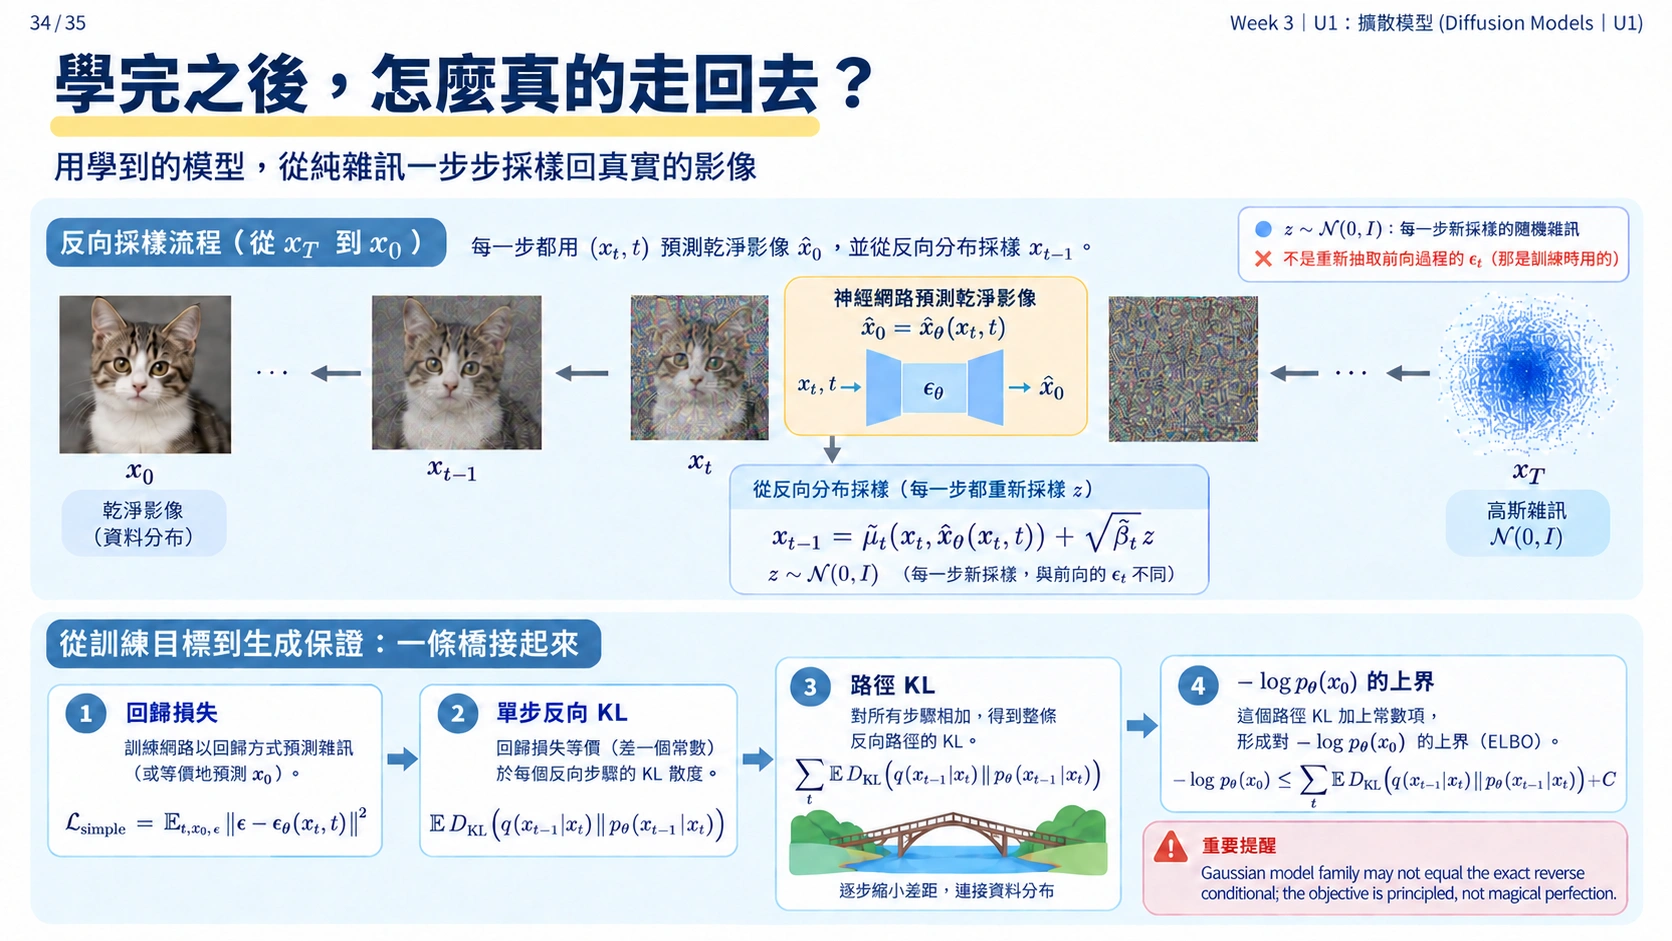
先回顧一下 Ho、Jain 與 Abbeel 的 DDPM [1] 在 U1.2 中使用的生成方式:
x t − 1 = μ ~ t ( x t , x ^ θ ( x t , t ) ) + β ~ t z , z ∼ N ( 0 , I ) . x_{t-1}=\tilde\mu_t\big(x_t,\ \hat x_\theta(x_t,t)\big)+\sqrt{\tilde\beta_t}\,z,
\qquad z\sim\mathcal N(0,I). x t − 1 = μ ~ t ( x t , x ^ θ ( x t , t ) ) + β ~ t z , z ∼ N ( 0 , I ) . 由右往左讀:從 x T ∼ N ( 0 , I ) x_T\sim\mathcal N(0,I) x T ∼ N ( 0 , I ) x t x_t x t ϵ θ \epsilon_\theta ϵ θ x ^ 0 = x ^ θ ( x t , t ) \hat x_0=\hat x_\theta(x_t,t) x ^ 0 = x ^ θ ( x t , t ) μ ~ t \tilde\mu_t μ ~ t z z z ϵ t \epsilon_t ϵ t
Week 3 投影片 44 · 點圖查看原圖
其中,真實的 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
課堂提問 Q1
既然一格一格走太慢,最直接的做法似乎是:把目標從 t − 1 t-1 t − 1 s ≪ t s\ll t s ≪ t x ^ 0 \hat x_0 x ^ 0 x s x_s x s
但真正的大步 reverse distribution 是
q ( x s ∣ x t ) = ∫ q ( x s ∣ x t , x 0 ) p ( x 0 ∣ x t ) d x 0 , q(x_s\mid x_t)
=\int q(x_s\mid x_t,x_0)\,p(x_0\mid x_t)\,\mathrm dx_0, q ( x s ∣ x t ) = ∫ q ( x s ∣ x t , x 0 ) p ( x 0 ∣ x t ) d x 0 , 仍然是許多 Gaussian 按照可能的 x 0 x_0 x 0
想像同一個模糊的 x t x_t x t x 0 x_0 x 0 x 0 x_0 x 0 x ^ 0 = E [ x 0 ∣ x t ] \hat x_0=\mathbb E[x_0\mid x_t] x ^ 0 = E [ x 0 ∣ x t ]
當我們只用一個以 x ^ 0 \hat x_0 x ^ 0
先想一想,再展開看整理後的答案 先把左右兩個可能來源想成在平均值兩側的 − a -a − a + a +a + a x 0 x_0 x 0 c t , s c_{t,s} c t , s s s s − c t , s a -c_{t,s}a − c t , s a + c t , s a +c_{t,s}a + c t , s a
( − c t , s a ) 2 + ( c t , s a ) 2 2 = c t , s 2 a 2 . \frac{(-c_{t,s}a)^2+(c_{t,s}a)^2}{2}=c_{t,s}^2a^2. 2 ( − c t , s a ) 2 + ( c t , s a ) 2 = c t , s 2 a 2 . 所以只退一小步時,c t , s c_{t,s} c t , s c t , s c_{t,s} c t , s
一般情況也是同一件事。對任意 s < t s<t s < t q ( x s ∣ x t , x 0 ) q(x_s\mid x_t,x_0) q ( x s ∣ x t , x 0 ) x 0 x_0 x 0 x 0 x_0 x 0 c t , s c_{t,s} c t , s β ~ t → s I \tilde\beta_{t\to s}I β ~ t → s I
E [ x s ∣ x t ] = μ ~ t → s ( x t , E [ x 0 ∣ x t ] ) , Var [ x s ∣ x t ] = β ~ t → s I + c t , s 2 Var [ x 0 ∣ x t ] . \mathbb E[x_s\mid x_t]
=\tilde\mu_{t\to s}\big(x_t,\mathbb E[x_0\mid x_t]\big),
\qquad
\operatorname{Var}[x_s\mid x_t]
=\tilde\beta_{t\to s}I
+c_{t,s}^2\operatorname{Var}[x_0\mid x_t]. E [ x s ∣ x t ] = μ ~ t → s ( x t , E [ x 0 ∣ x t ] ) , Var [ x s ∣ x t ] = β ~ t → s I + c t , s 2 Var [ x 0 ∣ x t ] . 第一式說明:把 x ^ 0 = E [ x 0 ∣ x t ] \hat x_0=\mathbb E[x_0\mid x_t] x ^ 0 = E [ x 0 ∣ x t ] β ~ t → s I \tilde\beta_{t\to s}I β ~ t → s I c t , s 2 Var [ x 0 ∣ x t ] c_{t,s}^2\operatorname{Var}[x_0\mid x_t] c t , s 2 Var [ x 0 ∣ x t ]
相鄰一步時,c t , t − 1 = O ( β t ) c_{t,t-1}=O(\beta_t) c t , t − 1 = O ( β t ) O ( β t ) O(\beta_t) O ( β t ) c t , s c_{t,s} c t , s β t \beta_t β t
小步時,漏掉的 variance 還小;大步時,不同來路被拉得更開,漏掉的 variance 就可能大到不能忽略。問題不是平均方向突然算錯,而是單一 Gaussian 把本來已經分開的多條路壓回了中間。
所以,想加速不能只是把 DDPM 的相鄰一步硬拉大。既然這條 sampling update 不能直接改,我們得回頭找:整個方法裡,還有什麼其實沒有被訓練固定?
訓練 denoiser 時,我們真的讓它看過那一千步怎麼連起來嗎?
訓練真的看過整條 Markov chain 嗎?
把 simple denoising loss 再寫一次:
L simple = E x 0 , t , ϵ [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] , x t = α ˉ t x 0 + 1 − α ˉ t ϵ . \mathcal L_{\text{simple}}
=\mathbb E_{x_0,t,\epsilon}
\left[\left\|\epsilon_\theta(x_t,t)-\epsilon\right\|^2\right],
\qquad
x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\,\epsilon. L simple = E x 0 , t , ϵ [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] , x t = α ˉ t x 0 + 1 − α ˉ t ϵ . 每次 training 只抽一張 x 0 x_0 x 0 t t t x t x_t x t x 1 , … , x t − 1 x_1,\ldots,x_{t-1} x 1 , … , x t − 1 x t x_t x t
q ( x t ∣ x 0 ) = N ( α ˉ t x 0 , ( 1 − α ˉ t ) I ) , q(x_t\mid x_0)=\mathcal N\!\left(\sqrt{\bar\alpha_t}x_0,(1-\bar\alpha_t)I\right), q ( x t ∣ x 0 ) = N ( α ˉ t x 0 , ( 1 − α ˉ t ) I ) , 而不是整條完整的路徑 q ( x 1 : T ∣ x 0 ) q(x_{1:T}\mid x_0) q ( x 1 : T ∣ x 0 )
想像我們只有散場後十分鐘、二十分鐘與三十分鐘的三張空拍照。每張照片都告訴我們各個街口有多少人,卻沒有替每個人畫線,標出他在三張照片裡分別站在哪裡。原本的 Markov chain 是一種連法,但只看這三張照片,還可能有很多種連法。
這就是可以改的地方:保留每個時刻的快照,重新決定不同時刻的人如何配對。
快照不變,來路可以重畫
我們想看的,是這些快照之間可以如何重新配對。真正生成時,我們手上只有 x t x_t x t
q λ ( x s ∣ x t ) = ∫ q λ ( x s ∣ x t , x 0 ) p ( x 0 ∣ x t ) d x 0 , q_\lambda(x_s\mid x_t)
=\int q_\lambda(x_s\mid x_t,x_0)\,p(x_0\mid x_t)\,\mathrm dx_0, q λ ( x s ∣ x t ) = ∫ q λ ( x s ∣ x t , x 0 ) p ( x 0 ∣ x t ) d x 0 , 其中,U1.2 與 U1.3 已經給了我們 denoiser:它能從 x t x_t x t E [ x 0 ∣ x t ] \mathbb E[x_0\mid x_t] E [ x 0 ∣ x t ] 假如已知 x t x_t x t x 0 x_0 x 0 x s x_s x s 這正是 q λ ( x s ∣ x t , x 0 ) q_\lambda(x_s\mid x_t,x_0) q λ ( x s ∣ x t , x 0 )
不同的 q λ ( x s ∣ x t , x 0 ) q_\lambda(x_s\mid x_t,x_0) q λ ( x s ∣ x t , x 0 )
不過配對不能亂配。要把「快照不變、重新配對」這個直覺化成具體方法,通常得先回頭看看:有哪些限制是我們必須遵守的?
首先,x s x_s x s p s ( x s ) p_s(x_s) p s ( x s ) p data ( x 0 ) p_{\text{data}}(x_0) p data ( x 0 )
p s ( x s ) = ∫ q ( x s ∣ x 0 ) p data ( x 0 ) d x 0 , p_s(x_s)
=\int q(x_s\mid x_0)\,p_{\text{data}}(x_0)\,\mathrm dx_0, p s ( x s ) = ∫ q ( x s ∣ x 0 ) p data ( x 0 ) d x 0 , 所以只要確保 q ( x s ∣ x 0 ) q(x_s\mid x_0) q ( x s ∣ x 0 ) p s ( x s ) p_s(x_s) p s ( x s ) x t x_t x t s s s
∫ q λ ( x s ∣ x t , x 0 ) q ( x t ∣ x 0 ) d x t = q ( x s ∣ x 0 ) . \int q_\lambda(x_s\mid x_t,x_0)\,q(x_t\mid x_0)\,\mathrm dx_t
=q(x_s\mid x_0). ∫ q λ ( x s ∣ x t , x 0 ) q ( x t ∣ x 0 ) d x t = q ( x s ∣ x 0 ) . 所以真正要設計的是:一個能滿足上式,而且給定 x 0 x_0 x 0 x t x_t x t x s x_s x s 否則只是把原本的問題換了一個名字。
要替不同空拍照中的人配對,最自然的做法是先替每個人找一個可以沿用的標記。給定他的原始位置 x 0 x_0 x 0 x t x_t x t
ϵ t : = x t − α ˉ t x 0 1 − α ˉ t . \epsilon_t:=\frac{x_t-\sqrt{\bar\alpha_t}x_0}{\sqrt{1-\bar\alpha_t}}. ϵ t := 1 − α ˉ t x t − α ˉ t x 0 . ϵ t \epsilon_t ϵ t ϵ t ∼ N ( 0 , I ) \epsilon_t\sim\mathcal N(0,I) ϵ t ∼ N ( 0 , I )
我們要讓 x s x_s x s 1 − α ˉ s 1-\bar\alpha_s 1 − α ˉ s ϵ t \epsilon_t ϵ t
令 λ t , s 2 \lambda_{t,s}^2 λ t , s 2 0 ≤ λ t , s 2 ≤ 1 − α ˉ s 0\leq\lambda_{t,s}^2\leq1-\bar\alpha_s 0 ≤ λ t , s 2 ≤ 1 − α ˉ s ϵ t \epsilon_t ϵ t z ∼ N ( 0 , I ) z\sim\mathcal N(0,I) z ∼ N ( 0 , I )
第二項用的是從 x t x_t x t ϵ s = ϵ t \epsilon_s=\epsilon_t ϵ s = ϵ t 重新定義 coupling 的方式。
因為 ϵ t \epsilon_t ϵ t z z z
( 1 − α ˉ s − λ t , s 2 ) I + λ t , s 2 I = ( 1 − α ˉ s ) I . \big(1-\bar\alpha_s-\lambda_{t,s}^2\big)I
+\lambda_{t,s}^2I
=(1-\bar\alpha_s)I. ( 1 − α ˉ s − λ t , s 2 ) I + λ t , s 2 I = ( 1 − α ˉ s ) I . mean 仍是 α ˉ s x 0 \sqrt{\bar\alpha_s}x_0 α ˉ s x 0 λ t , s \lambda_{t,s} λ t , s x t x_t x t
q λ ( x s ∣ x 0 ) = N ( α ˉ s x 0 , ( 1 − α ˉ s ) I ) . q_\lambda(x_s\mid x_0)
=\mathcal N\!\left(\sqrt{\bar\alpha_s}x_0,(1-\bar\alpha_s)I\right). q λ ( x s ∣ x 0 ) = N ( α ˉ s x 0 , ( 1 − α ˉ s ) I ) . 另一方面,給定 x 0 x_0 x 0 x t x_t x t ϵ t \epsilon_t ϵ t z z z
q λ ( x s ∣ x t , x 0 ) = N ( α ˉ s x 0 + 1 − α ˉ s − λ t , s 2 x t − α ˉ t x 0 1 − α ˉ t , λ t , s 2 I ) . q_\lambda(x_s\mid x_t,x_0)
=\mathcal N\!\left(
\sqrt{\bar\alpha_s}x_0
+\sqrt{1-\bar\alpha_s-\lambda_{t,s}^2}\,
\frac{x_t-\sqrt{\bar\alpha_t}x_0}{\sqrt{1-\bar\alpha_t}},
\ \lambda_{t,s}^2I
\right). q λ ( x s ∣ x t , x 0 ) = N ( α ˉ s x 0 + 1 − α ˉ s − λ t , s 2 1 − α ˉ t x t − α ˉ t x 0 , λ t , s 2 I ) . 這條新的 forward/inference joint 一般不再是 Markov chain:即使已知 x t x_t x t x s x_s x s x 0 x_0 x 0 non-Markovian 指的是我們改了快照之間的配對,不是說生成時網路必須記住全部歷史。
補充 換掉這樣的生成方式後,原本的 denoiser 還能用嗎?還有理論根據嗎? 能。先把 x 0 = ( x t − 1 − α ˉ t ϵ t ) / α ˉ t x_0=(x_t-\sqrt{1-\bar\alpha_t}\,\epsilon_t)/\sqrt{\bar\alpha_t} x 0 = ( x t − 1 − α ˉ t ϵ t ) / α ˉ t
c t , s : = 1 − α ˉ s − λ t , s 2 − α ˉ s α ˉ t 1 − α ˉ t . c_{t,s}
:=\sqrt{1-\bar\alpha_s-\lambda_{t,s}^2}
-\sqrt{\frac{\bar\alpha_s}{\bar\alpha_t}}\sqrt{1-\bar\alpha_t}. c t , s := 1 − α ˉ s − λ t , s 2 − α ˉ t α ˉ s 1 − α ˉ t . 那麼真實 conditional 與我們使用的 reverse model 分別是
q λ ( x s ∣ x t , x 0 ) = N ( α ˉ s α ˉ t x t + c t , s ϵ t , λ t , s 2 I ) , p θ ( x s ∣ x t ) : = N ( α ˉ s α ˉ t x t + c t , s ϵ θ ( x t , t ) , λ t , s 2 I ) . \begin{aligned}
q_\lambda(x_s\mid x_t,x_0)
&=\mathcal N\!\left(
\sqrt{\frac{\bar\alpha_s}{\bar\alpha_t}}x_t
+c_{t,s}\epsilon_t,
\lambda_{t,s}^2I
\right),\\
p_\theta(x_s\mid x_t)
&:=\mathcal N\!\left(
\sqrt{\frac{\bar\alpha_s}{\bar\alpha_t}}x_t
+c_{t,s}\epsilon_\theta(x_t,t),
\lambda_{t,s}^2I
\right).
\end{aligned} q λ ( x s ∣ x t , x 0 ) p θ ( x s ∣ x t ) = N ( α ˉ t α ˉ s x t + c t , s ϵ t , λ t , s 2 I ) , := N ( α ˉ t α ˉ s x t + c t , s ϵ θ ( x t , t ) , λ t , s 2 I ) . 把新的 variational objective 按時間拆開後,每一步和 U1.2 一樣是一個 KL;不含 θ \theta θ C C C
J λ ( θ ) = ∑ t → s E [ D K L ( q λ ( x s ∣ x t , x 0 ) ∥ p θ ( x s ∣ x t ) ) ] + C . J_\lambda(\theta)
=\sum_{t\to s}\mathbb E\!\left[
D_{\mathrm{KL}}\!\left(
q_\lambda(x_s\mid x_t,x_0)
\,\|\,
p_\theta(x_s\mid x_t)
\right)
\right]+C. J λ ( θ ) = t → s ∑ E [ D KL ( q λ ( x s ∣ x t , x 0 ) ∥ p θ ( x s ∣ x t ) ) ] + C . KL 兩邊的 Gaussian 有相同的 covariance λ t , s 2 I \lambda_{t,s}^2I λ t , s 2 I ϵ t \epsilon_t ϵ t ϵ θ ( x t , t ) \epsilon_\theta(x_t,t) ϵ θ ( x t , t )
D K L = c t , s 2 2 λ t , s 2 ∥ ϵ t − ϵ θ ( x t , t ) ∥ 2 = γ t , s ∥ ϵ t − ϵ θ ( x t , t ) ∥ 2 . D_{\mathrm{KL}}
=\frac{c_{t,s}^2}{2\lambda_{t,s}^2}
\left\|\epsilon_t-\epsilon_\theta(x_t,t)\right\|^2
=\gamma_{t,s}\left\|\epsilon_t-\epsilon_\theta(x_t,t)\right\|^2. D KL = 2 λ t , s 2 c t , s 2 ∥ ϵ t − ϵ θ ( x t , t ) ∥ 2 = γ t , s ∥ ϵ t − ϵ θ ( x t , t ) ∥ 2 . 其中 γ t , s > 0 \gamma_{t,s}>0 γ t , s > 0 λ t , s \lambda_{t,s} λ t , s
J λ ( θ ) = L γ ( θ ) + C . J_\lambda(\theta)=\mathcal L_\gamma(\theta)+C. J λ ( θ ) = L γ ( θ ) + C . 這就是「這一族 process 的 variational objective 都會化成某組加權 denoising MSE」的簡短證明。(嚴格的 Gaussian KL 證明先取 λ t , s > 0 \lambda_{t,s}>0 λ t , s > 0 λ t , s = 0 \lambda_{t,s}=0 λ t , s = 0
而 U1.3 已經看過,在理想函數層級,正的 timestep weights 不會改變每個 t t t
訓練固定了每張 noisy snapshot 上的最佳 denoiser,沒有把跨時間的連法一起固定。 所以只要 q ( x t ∣ x 0 ) q(x_t\mid x_0) q ( x t ∣ x 0 )
把新的來路倒著走
到目前為止,我們都還在偷看 x 0 x_0 x 0 x t x_t x t U1.3 告訴我們,denoiser 可以從目前的 ( x t , t ) (x_t,t) ( x t , t )
ϵ ^ t : = ϵ θ ( x t , t ) ≈ E [ ϵ t ∣ x t ] = − 1 − α ˉ t ∇ log p t ( x t ) . \hat\epsilon_t:=\epsilon_\theta(x_t,t)
\approx\mathbb E[\epsilon_t\mid x_t]
=-\sqrt{1-\bar\alpha_t}\,\nabla\log p_t(x_t). ϵ ^ t := ϵ θ ( x t , t ) ≈ E [ ϵ t ∣ x t ] = − 1 − α ˉ t ∇ log p t ( x t ) . 把 x 0 = ( x t − 1 − α ˉ t ϵ t ) / α ˉ t x_0=(x_t-\sqrt{1-\bar\alpha_t}\,\epsilon_t)/\sqrt{\bar\alpha_t} x 0 = ( x t − 1 − α ˉ t ϵ t ) / α ˉ t ϵ ^ t \hat\epsilon_t ϵ ^ t ϵ t \epsilon_t ϵ t
x s = α ˉ s α ˉ t x t + ( 1 − α ˉ s − λ t , s 2 − α ˉ s α ˉ t 1 − α ˉ t ) ϵ ^ t + λ t , s z , z ∼ N ( 0 , I ) . x_s
=\sqrt{\frac{\bar\alpha_s}{\bar\alpha_t}}x_t
+\left(
\sqrt{1-\bar\alpha_s-\lambda_{t,s}^2}
-\sqrt{\frac{\bar\alpha_s}{\bar\alpha_t}}\sqrt{1-\bar\alpha_t}
\right)\hat\epsilon_t
+\lambda_{t,s}z,
\qquad z\sim\mathcal N(0,I). x s = α ˉ t α ˉ s x t + ( 1 − α ˉ s − λ t , s 2 − α ˉ t α ˉ s 1 − α ˉ t ) ϵ ^ t + λ t , s z , z ∼ N ( 0 , I ) . 現在看得很清楚:每一步只需要目前的 x t x_t x t ϵ ^ t \hat\epsilon_t ϵ ^ t x 0 x_0 x 0
這條式子留給我們一個選擇:每一步要加入多少新的 randomness?先確認它確實包含原本的 DDPM。令 s = t − 1 s=t-1 s = t − 1
λ t , t − 1 2 = β ~ t = 1 − α ˉ t − 1 1 − α ˉ t β t . \lambda_{t,t-1}^2=\tilde\beta_t
=\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\,\beta_t. λ t , t − 1 2 = β ~ t = 1 − α ˉ t 1 − α ˉ t − 1 β t . 利用 α ˉ t = α t α ˉ t − 1 \bar\alpha_t=\alpha_t\bar\alpha_{t-1} α ˉ t = α t α ˉ t − 1 β t = 1 − α t \beta_t=1-\alpha_t β t = 1 − α t
α ˉ t − 1 α ˉ t = 1 α t , 1 − α ˉ t − 1 − β ~ t − 1 − α ˉ t α t = − β t α t 1 − α ˉ t . \begin{aligned}
\sqrt{\frac{\bar\alpha_{t-1}}{\bar\alpha_t}}
&=\frac{1}{\sqrt{\alpha_t}},\\[2pt]
\sqrt{1-\bar\alpha_{t-1}-\tilde\beta_t}
-\frac{\sqrt{1-\bar\alpha_t}}{\sqrt{\alpha_t}}
&=-\frac{\beta_t}{\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}}.
\end{aligned} α ˉ t α ˉ t − 1 1 − α ˉ t − 1 − β ~ t − α t 1 − α ˉ t = α t 1 , = − α t 1 − α ˉ t β t . 因此一般式變成
x t − 1 = 1 α t ( x t − β t 1 − α ˉ t ϵ ^ t ) + β ~ t z , x_{t-1}
=\frac{1}{\sqrt{\alpha_t}}
\left(
x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\,\hat\epsilon_t
\right)
+\sqrt{\tilde\beta_t}\,z, x t − 1 = α t 1 ( x t − 1 − α ˉ t β t ϵ ^ t ) + β ~ t z , 正是 U1.2 的 DDPM update。DDPM 的確是這一族配對中的一種,但維持 marginals 並沒有要求我們只能選它。
那如果完全不加入新的 noise 呢?令 λ t , s = 0 \lambda_{t,s}=0 λ t , s = 0
x s = α ˉ s α ˉ t x t + ( 1 − α ˉ s − α ˉ s α ˉ t 1 − α ˉ t ) ϵ ^ t . x_s
=\sqrt{\frac{\bar\alpha_s}{\bar\alpha_t}}x_t
+\left(
\sqrt{1-\bar\alpha_s}
-\sqrt{\frac{\bar\alpha_s}{\bar\alpha_t}}\sqrt{1-\bar\alpha_t}
\right)\hat\epsilon_t. x s = α ˉ t α ˉ s x t + ( 1 − α ˉ s − α ˉ t α ˉ s 1 − α ˉ t ) ϵ ^ t . 因為 ϵ ^ t ≈ − 1 − α ˉ t ∇ log p t ( x t ) \hat\epsilon_t\approx-\sqrt{1-\bar\alpha_t}\,\nabla\log p_t(x_t) ϵ ^ t ≈ − 1 − α ˉ t ∇ log p t ( x t ) x t x_t x t s s s t t t x s − x t x_s-x_t x s − x t
這裡不是在用「t t t s s s 定義 同一條 trajectory 在 s s s x s x_s x s ϵ ^ s \hat\epsilon_s ϵ ^ s
此時給定起點 x T x_T x T x T x_T x T 到這一步,Song、Meng 與 Ermon [2] 才把它取名為 Denoising Diffusion Implicit Model,也就是 DDIM。
有了上面的架構,我們就可以從原本的 1 , … , T 1,\ldots,T 1 , … , T
0 = τ 0 < τ 1 < ⋯ < τ S = T , 0=\tau_0<\tau_1<\cdots<\tau_S=T, 0 = τ 0 < τ 1 < ⋯ < τ S = T , 再沿著 τ S → τ S − 1 → ⋯ → τ 0 \tau_S\to\tau_{S-1}\to\cdots\to\tau_0 τ S → τ S − 1 → ⋯ → τ 0
符號 DDIM 的一般式(含 η)長什麼樣? 文獻常把上面的 λ t , s \lambda_{t,s} λ t , s
λ t , s = η 1 − α ˉ s 1 − α ˉ t 1 − α ˉ t α ˉ s . \lambda_{t,s}
=\eta\sqrt{\frac{1-\bar\alpha_s}{1-\bar\alpha_t}}
\sqrt{1-\frac{\bar\alpha_t}{\bar\alpha_s}}. λ t , s = η 1 − α ˉ t 1 − α ˉ s 1 − α ˉ s α ˉ t . η = 0 \eta=0 η = 0 η = 1 \eta=1 η = 1 η \eta η
兩種走法,看得見
互動 demo:DDPM 與 DDIM 的軌跡。 兩邊用同一個 score(這裡直接用資料算出精確的 score,相當於一個訓到最佳的網路)、同一組起點 ,只有 η \eta η η \eta η 終點都落在資料上 ——這就是「邊際相同」看起來的樣子。把步數從 200 降到 50、25、10,終點離資料會越來越遠,而 η = 0 \eta=0 η = 0 η = 0 \eta=0 η = 0 彎的 ,這件事 U2 會再拿出來講。
(要提醒的是:這個 demo 的 score 是精確的,所以看不到「網路有誤差時,加回噪聲能把樣本拉回 p t p_t p t U1.5 。)
從固定格子走向連續時間
上面的做法雖然已經可以跳步,但走的仍是原本 schedule 上的格子。若想不再受這些格點限制,就得把「distribution 怎麼演化」與「計算時切成幾步」真正分開。
做法就是把 timestep 切得越來越細,讓步長縮到 0 0 0
Forward dynamics:把加噪寫成連續運動
想像把一秒鐘的影片切成 T T T Δ t = 1 / T \Delta t=1/T Δ t = 1/ T β t \beta_t β t β ( t ) Δ t \beta(t)\Delta t β ( t ) Δ t
U1.1 的一步 forward transition 就變成
x t + Δ t = 1 − β ( t ) Δ t x t + β ( t ) Δ t ξ t , ξ t ∼ N ( 0 , I ) , x_{t+\Delta t}
=\sqrt{1-\beta(t)\Delta t}\,x_t
+\sqrt{\beta(t)\Delta t}\,\xi_t,
\qquad \xi_t\sim\mathcal N(0,I), x t + Δ t = 1 − β ( t ) Δ t x t + β ( t ) Δ t ξ t , ξ t ∼ N ( 0 , I ) , 其中 ξ t \xi_t ξ t Δ t \Delta t Δ t
1 − β ( t ) Δ t = 1 − 1 2 β ( t ) Δ t + O ( Δ t 2 ) , \sqrt{1-\beta(t)\Delta t}
=1-\tfrac12\beta(t)\Delta t+O(\Delta t^2), 1 − β ( t ) Δ t = 1 − 2 1 β ( t ) Δ t + O ( Δ t 2 ) , 把 x t x_t x t
x t + Δ t − x t = − 1 2 β ( t ) x t Δ t + β ( t ) ( Δ t ξ t ) + O ( Δ t 2 ) . x_{t+\Delta t}-x_t
=-\tfrac12\beta(t)x_t\,\Delta t
+\sqrt{\beta(t)}\big(\sqrt{\Delta t}\,\xi_t\big)
+O(\Delta t^2). x t + Δ t − x t = − 2 1 β ( t ) x t Δ t + β ( t ) ( Δ t ξ t ) + O ( Δ t 2 ) . 這裡的 noise 為什麼是 Δ t \sqrt{\Delta t} Δ t Δ t \Delta t Δ t variance 相加:每一步的 variance 是 Δ t \Delta t Δ t 1 / Δ t 1/\Delta t 1/Δ t 1 1 1 Δ t \Delta t Δ t 0 0 0
現在把
Δ W t : = Δ t ξ t , Δ W t ∼ N ( 0 , Δ t I ) . \Delta W_t:=\sqrt{\Delta t}\,\xi_t,
\qquad \Delta W_t\sim\mathcal N(0,\Delta t\,I). Δ W t := Δ t ξ t , Δ W t ∼ N ( 0 , Δ t I ) . 這就是 Brownian motion 在這一小段時間裡的增量。讓 Δ t → 0 \Delta t\to0 Δ t → 0 Δ W t \Delta W_t Δ W t d W t dW_t d W t
d x = − 1 2 β ( t ) x d t + β ( t ) d W t , t : 0 → 1. dx=-\tfrac12\beta(t)\,x\,dt+\sqrt{\beta(t)}\,dW_t,\qquad t:0\to1 . d x = − 2 1 β ( t ) x d t + β ( t ) d W t , t : 0 → 1. 第一項是每一小段時間把樣本往原點縮一點,第二項則灌入相應大小的 Gaussian noise。它做的仍是原本的 forward process,只是不再綁在某一組 timestep 上。
一般來說,一條 forward dynamics 會告訴我們兩件事:drift f t f_t f t g t g_t g t
f t = − 1 2 β ( t ) , g t = β ( t ) . f_t=-\tfrac12\beta(t),\qquad g_t=\sqrt{\beta(t)}. f t = − 2 1 β ( t ) , g t = β ( t ) . 這裡也看得到為什麼 score 本身還不夠決定 reverse dynamics 。Score 只告訴我們同一個時刻裡,density 往哪個方向增加;它沒有單獨告訴我們 forward process 每單位時間加入多少 noise。反向修正的大小必須同時知道 g t g_t g t
Reverse dynamics:score 怎麼把時間倒過來?
Anderson(1982)[3] 證明了一件很漂亮的事:把時間倒過來,它仍然是一條 SDE ,而且 drift 裡多出一個 score 項:
這條式子把前面缺的兩塊拼在一起了:forward dynamics 提供原本的 drift 與 noise 強度,U1.3 學到的 score 則告訴反向過程,樣本要往哪裡修正。兩者缺一不可。
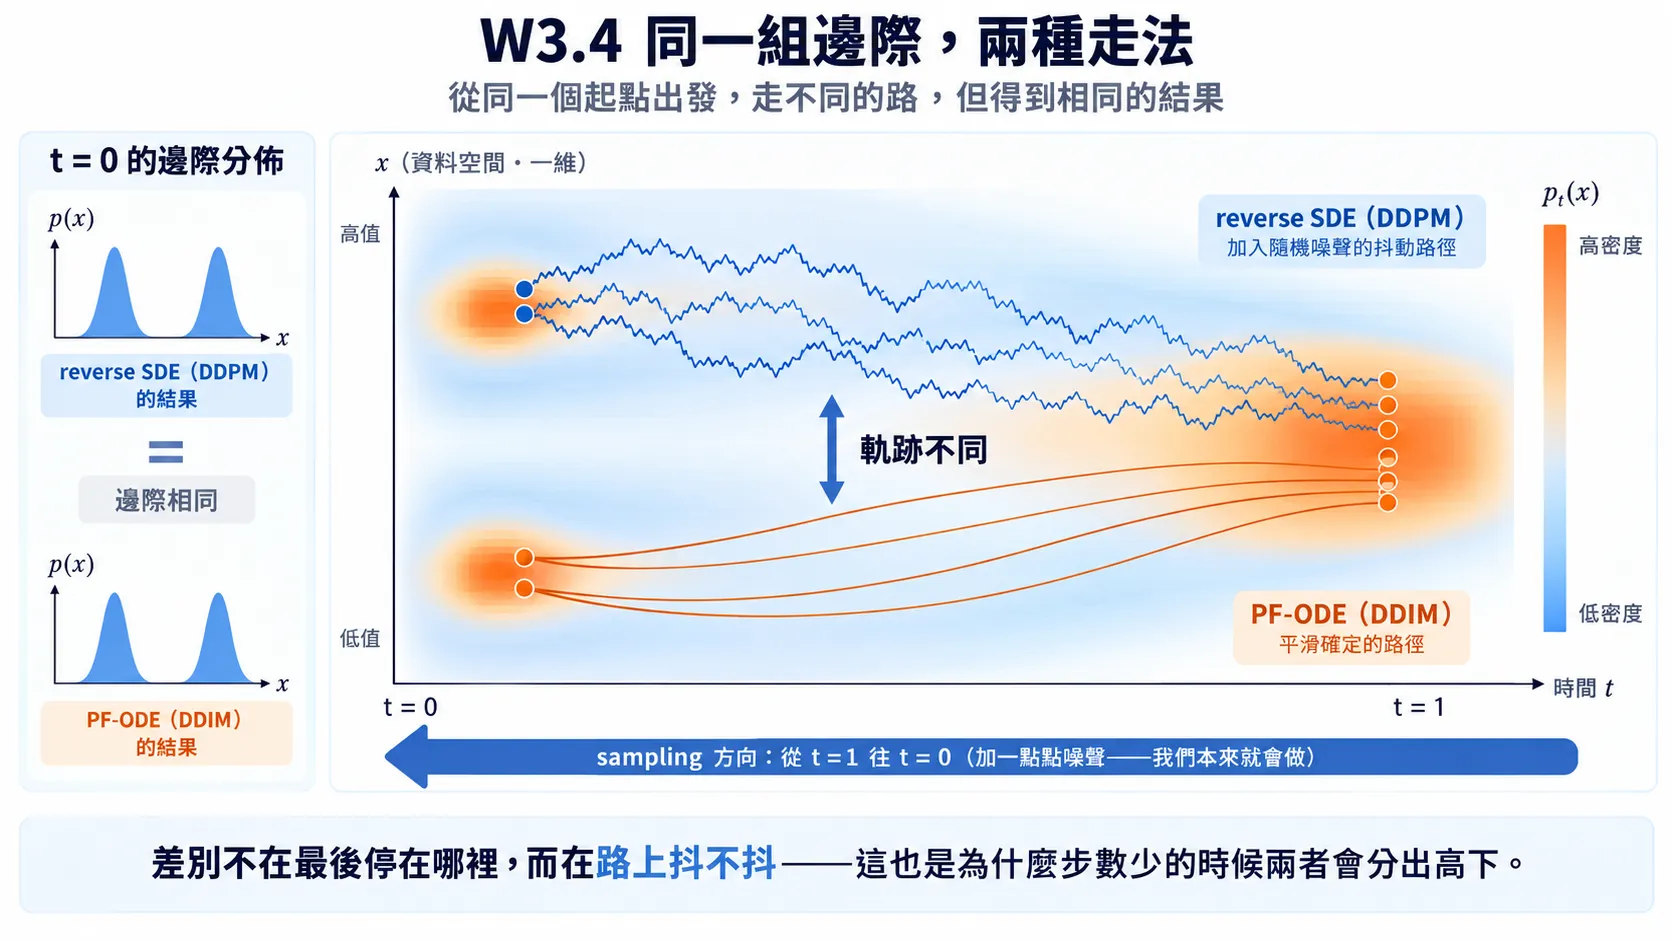
Song 等人(2021)[4] 進一步指出:同一條邊際分布路徑還可以由一條完全沒有隨機項 的 ODE 推動,而且它與上面的 reverse SDE 在每個 t t t p t p_t p t
d x d t = − 1 2 β ( t ) x − 1 2 β ( t ) ∇ log p t ( x ) (probability-flow ODE) . \frac{dx}{dt}=-\tfrac12\beta(t)\,x-\tfrac12\beta(t)\,\nabla\log p_t(x)
\qquad\text{(probability-flow ODE)} . d t d x = − 2 1 β ( t ) x − 2 1 β ( t ) ∇ log p t ( x ) (probability-flow ODE) . 注意 score 前面的係數:SDE 是 β \beta β 1 2 β \tfrac12\beta 2 1 β
符號 文獻上寫的是通式:d y t = [ f t y t − g t 2 s θ ] d t + g t d W ˉ t dy_t=[f_t y_t-g_t^2 s_\theta]dt+g_t d\bar W_t d y t = [ f t y t − g t 2 s θ ] d t + g t d W ˉ t 上面三條式子把 DDPM 的 schedule 直接代進去了,所以長得很具體。文獻上(Song 等人 [4]、以及本課主要參考 [5] 的 §4.1)通常寫的是通式 ——forward 只要寫成
d x = f t x d t + g t d W t , dx=f_t\,x\,dt+g_t\,dW_t , d x = f t x d t + g t d W t , Anderson 的結果就給出對應的反向兩條:
d y t = [ f t y t − g t 2 s θ ( y t , t ) ] d t + g t d W ˉ t , d y t d t = f t y t − 1 2 g t 2 s θ ( y t , t ) (PF-ODE) . \begin{aligned}
dy_t&=\big[f_t\,y_t-g_t^2\,s_\theta(y_t,t)\big]dt+g_t\,d\bar W_t ,\\[2pt]
\frac{dy_t}{dt}&=f_t\,y_t-\tfrac12\,g_t^2\,s_\theta(y_t,t)\qquad\text{(PF-ODE)} .
\end{aligned} d y t d t d y t = [ f t y t − g t 2 s θ ( y t , t ) ] d t + g t d W ˉ t , = f t y t − 2 1 g t 2 s θ ( y t , t ) (PF-ODE) . 字母對照:y t y_t y t x ˉ ( t ) \bar x(t) x ˉ ( t ) s θ s_\theta s θ U1.3 定義的 − ϵ θ / σ t -\epsilon_\theta/\sigma_t − ϵ θ / σ t W ˉ \bar W W ˉ f ( x , t ) f(x,t) f ( x , t ) x x x f t x f_t\,x f t x
代回我們的情形 :DDPM 的 forward 是 f t = − 1 2 β ( t ) f_t=-\tfrac12\beta(t) f t = − 2 1 β ( t ) g t = β ( t ) g_t=\sqrt{\beta(t)} g t = β ( t ) g t 2 = β ( t ) g_t^2=\beta(t) g t 2 = β ( t ) 換一個 schedule、甚至換一整族 forward process,變的只有 f t f_t f t g t g_t g t U2.4 會把這些 choices 放進 stochastic interpolant 的共同架構。
補充 少掉的那一半 score 去哪了? 關鍵在 Fokker–Planck 方程(M3.2 ):噪聲項對分布造成的擴散 1 2 β Δ p t \tfrac12\beta\,\Delta p_t 2 1 β Δ p t
1 2 β Δ p t = ∇ ⋅ ( 1 2 β p t ∇ log p t ) , \tfrac12\beta\,\Delta p_t=\nabla\cdot\Big(\tfrac12\beta\,p_t\,\nabla\log p_t\Big), 2 1 β Δ p t = ∇ ⋅ ( 2 1 β p t ∇ log p t ) , 也就是「擴散」可以被吸進 drift 裡 ,變成一個沿著 ∇ log p t \nabla\log p_t ∇ log p t
把這個改寫代回 Fokker–Planck,drift 項與擴散項就併成一項:
∂ t p t + ∇ ⋅ ( p t u t ) = 0 , u t ( x ) = − 1 2 β ( t ) x − 1 2 β ( t ) ∇ log p t ( x ) . \partial_t p_t+\nabla\cdot\big(p_t\,u_t\big)=0,\qquad
u_t(x)=-\tfrac12\beta(t)\,x-\tfrac12\beta(t)\,\nabla\log p_t(x) . ∂ t p t + ∇ ⋅ ( p t u t ) = 0 , u t ( x ) = − 2 1 β ( t ) x − 2 1 β ( t ) ∇ log p t ( x ) . 那個 u t u_t u t continuity equation (M2.2 )。它說的只是東西不會憑空出現或消失 ——p t u t p_t u_t p t u t
所以「SDE 與 ODE 的邊際相同」不是巧合:把擴散吸進 drift 之後,兩邊滿足的是同一條 continuity equation。U2.1 會把它反過來用——先指定想要的 p t p_t p t u t u_t u t
這件事之後會被推廣成一整族取樣器(U2.4 ):噪聲要注入多少,其實是一個可以調的設定 。
三者的關係整理成一張表:
forward SDE reverse SDE PF-ODE 時間方向 p 0 → p T p_0\to p_T p 0 → p T p T → p 0 p_T\to p_0 p T → p 0 p T → p 0 p_T\to p_0 p T → p 0 經過的邊際 p t p_t p t 同一組 p t p_t p t 同一組 p t p_t p t 單條軌跡 隨機 隨機 確定 離散對應 forward 加噪步驟 DDPM reverse update deterministic DDIM update
圖:同一組邊際,兩種走法。 兩組軌跡從同一批起點 出發,上面是 reverse SDE(抖動)、下面是 PF-ODE(光滑);左側兩個 t = 0 t=0 t = 0
在 variance-preserving diffusion 的連續極限下,可以把 DDPM 的 reverse update 看成 reverse SDE 的一階離散對應;deterministic DDIM 則對應 PF-ODE。精確的數值格式會隨時間與狀態的 parametrization 改變,但概念上的分工不變:網路提供 score,dynamics 指定怎麼走,數值方法決定用哪些 timestep 把它算出來。
Sampler = dynamics + 數值求解
想改變步數,不能只放大相鄰的 DDPM 公式;得先選 reverse dynamics,再選 timestep 與 solver。這時「五十步或一千步」才是數值求解的選擇。
步數減少仍有兩筆不同的誤差:Q1 的 Gaussian approximation error 是單一 reverse kernel 對 mixture posterior 的近似,由 β t \beta_t β t numerical discretization error 則來自用有限步近似一條連續 dynamics,由 Δ t \Delta t Δ t
DDPM 與 DDIM 在理想的連續極限可以經過同一組 marginals,不代表有限步品質一定相同。ODE 的 Euler update 會把一步內的 velocity 當成不變;SDE 還有 drift 的離散誤差與隨機擾動,但 score drift 也可能把偏掉的樣本拉回。哪一端較好,要看模型誤差與離散化誤差誰佔上風;U1.5 會直接比較。
DDPM 選 Gaussian noise、Gaussian prior 與特定 schedule,是為了讓 q ( x t ∣ x 0 ) q(x_t\mid x_0) q ( x t ∣ x 0 ) U2.0 會接著問:若不想讓路徑與起點都被這些選擇綁住,還能怎麼做?
消化一下
參考文獻
Ho, J., Jain, A., Abbeel, P. Denoising Diffusion Probabilistic Models.
Song, J., Meng, C., Ermon, S. Denoising Diffusion Implicit Models. η \eta η
Anderson, B. D. O. Reverse-time diffusion equation models.
Song, Y., Sohl-Dickstein, J., Kingma, D. P., Kumar, A., Ermon, S., Poole, B. Score-Based Generative Modeling through Stochastic Differential Equations.
Lai, C.-H., Song, Y., Kim, D., Mitsufuji, Y., Ermon, S. The Principles of Diffusion Models.