
U2.2 平均人潮為什麼能搬動整個分布?
本篇重用3 篇
我們要怎麼確定 真的做了對的搬運呢?
在 U2.1 裡,我們設計的 reference paths 很明顯會把 ( 的 distribution)一路搬成 ( 的 distribution)。但真正生成時,用的並不是這些 reference paths,而是剛剛從它們學出來的 velocity field 。
那我們怎麼知道,沿著這個 走,最後真的還是會把 搬成 ?換句話說:
一個 velocity field,到底會怎麼改變一個 distribution?
要回答這個問題,我們不能只盯著某一個人,看他最後走到了哪裡。因為 描述的不是「某一個人在哪裡」,而是某個位置附近現在有多少人、有多擠;它描述的是密度。
所以真正該問的是:對一小塊區域來說,當人群隨著 移動,裡面的人數、密度會增加還是減少?
Divergence 描述流進流出的量
要描述一個 velocity field 在某個位置附近,是把空間往外拉開,還是往內壓縮,最自然的量就是它的 divergence。不過,這描述的是 velocity field 本身;要知道人潮的 density 如何改變,還得把這裡原本有多少人算進去。
補充Divergence 為什麼是各方向的變化量加總?
直覺上,divergence 做的事情很簡單:看看每一個方向上,速度往外增加了多少,再把這些變化量全部加起來。
例如在二維裡,
第一項看水平方向有多「往外拉開」,第二項看垂直方向有多「往外拉開」,最後把它們加總。因此:
- :附近的空間整體在膨脹;
- :附近的空間整體在壓縮;
- :velocity field 在局部沒有淨膨脹或壓縮。
到了 維,只要把每一個方向的 都加進來。更完整的直覺、flux 與 Gauss 定理請看 M0.1。
要回答這個問題,先想像一條很窄的走道。如果某個位置的人很多,但大家走得很慢,每秒通過這裡的人不一定很多;反過來,如果大家走得很快,但這裡根本沒什麼人,通過的人也不會很多。所以「每秒有多少人通過這裡」,同時取決於兩件事:這裡有多擠,以及大家走多快。
時間 、位置 的 density 是 ,速度是 ,兩者相乘,記成
就是 probability flux。在一維裡尤其直觀:如果 表示「每公尺有多少 probability」,而 表示「每秒走幾公尺」,那麼
也就是:每秒有多少 probability 從這裡通過。
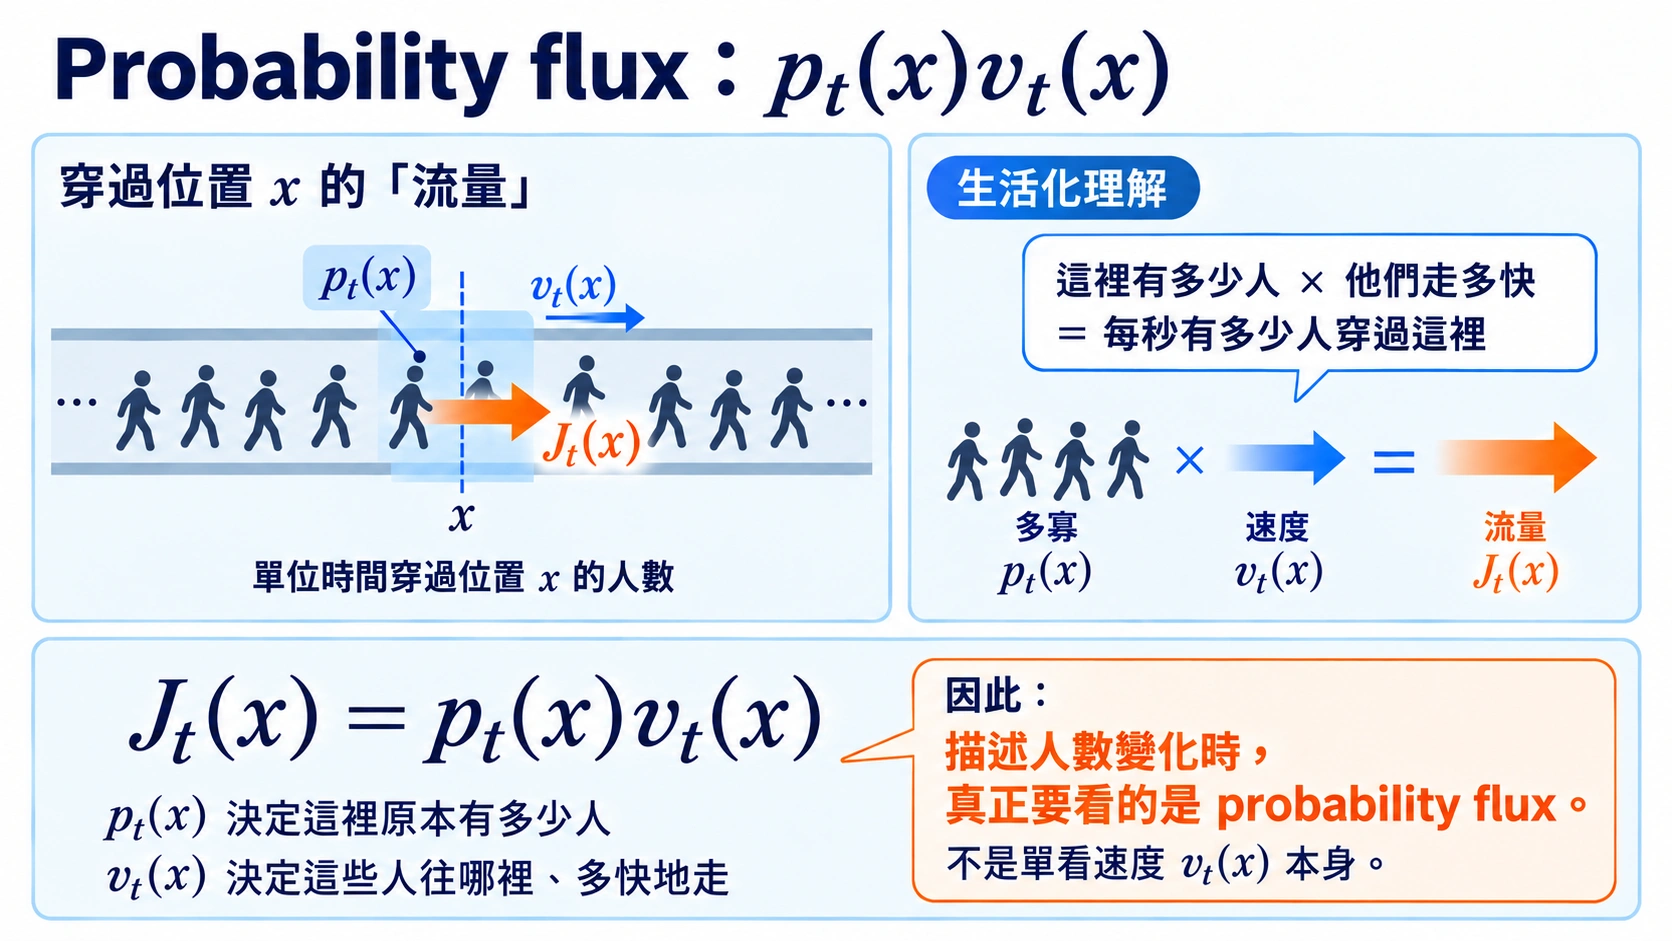
圖: 描述多擠, 描述走多快;兩者相乘,才得到每單位時間通過這裡的流量 。左圖標出它們在走道上的位置,右圖與下方公式說明三者的關係。
先固定一小段走道,數流進來與流出去的人
但知道某一個位置的 flux 還不夠。我們真正關心的是一小段固定的區域 :左邊流進來多少,右邊又流出去多少? 這裡固定的是地面上的兩個位置,不跟著任何一個人移動。
例如每秒有 人從左端走進來、 人從右端走出去,區間內就每秒多 人;如果兩端的流量反過來,區間內就每秒少 人。所以決定人數變化的,是兩端流量的差,而不只是區間裡的人走得多快。
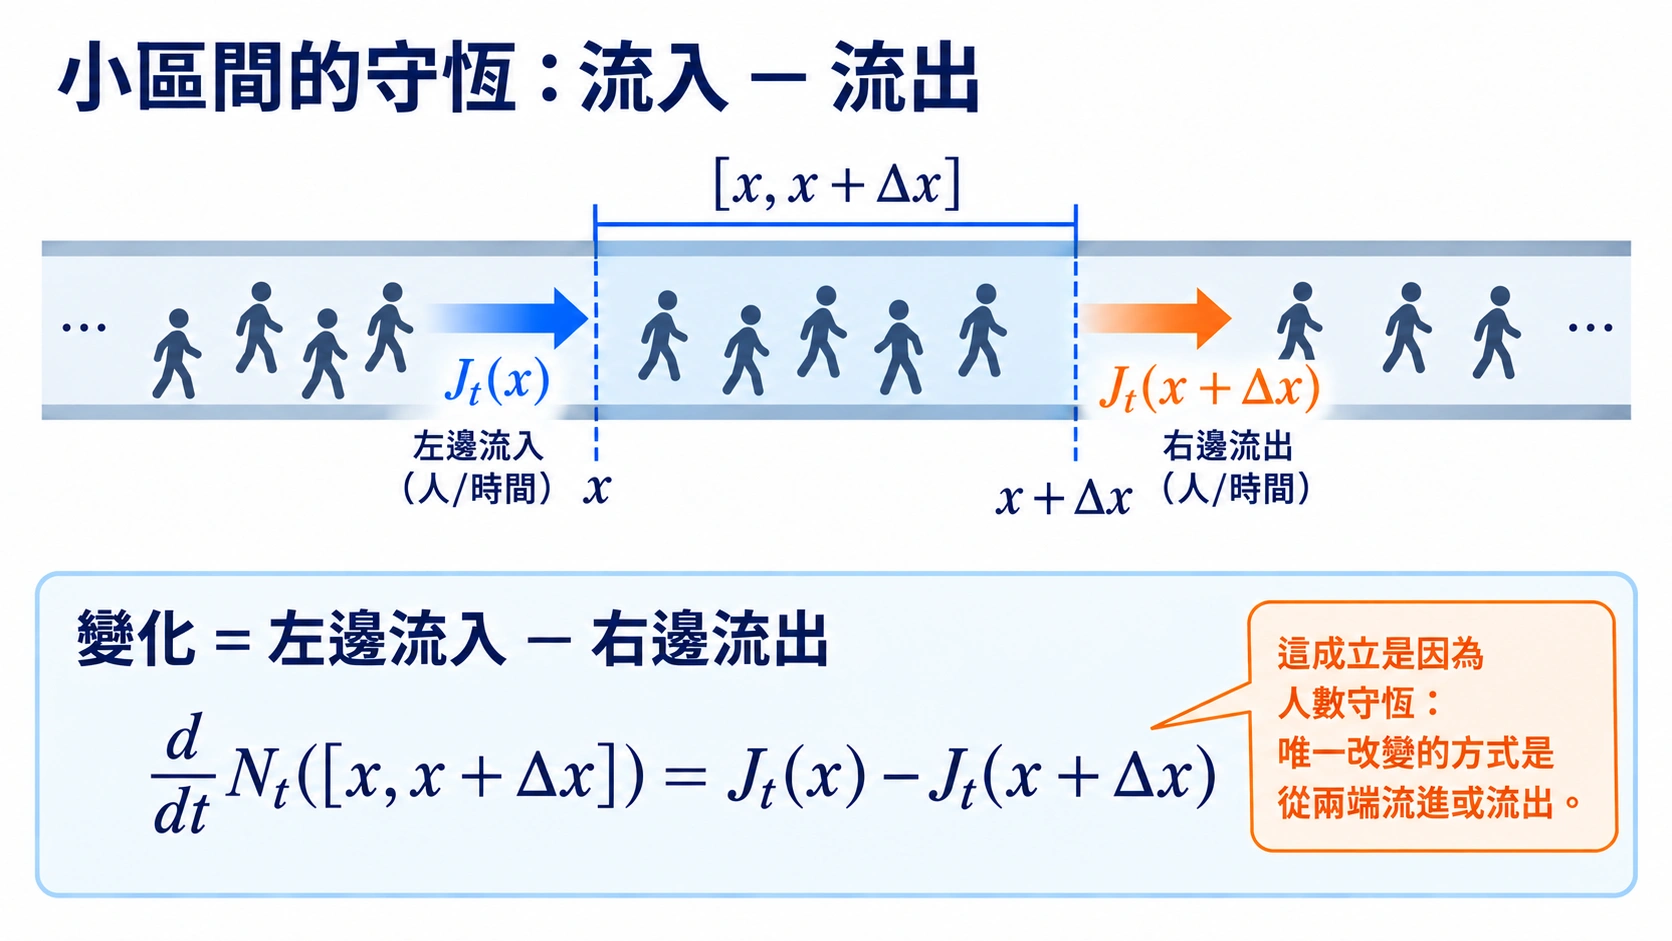
圖: 表示圖中區間內的人數。把總人數正規化為 後,對應的就是該區間的 probability mass;兩種讀法都遵守「變化量=流入-流出」。
把人數換成 probability,區間內的質量就是 density 的積分。因此質量守恆寫成
從流入減流出寫出守恆
- 固定地面上的區間 。把裡面的 density 積分起來,就是區間內的 probability mass。
- 是左端每單位時間流入的 probability;先把這份流量加進來。
- 右端流出去的 要扣掉。留下的是流入減流出。
- 區間內的質量不能憑空增加或消失,所以它的時間變化率,就等於剛才算出的流入減流出。
左邊是固定區間內的 probability mass 每秒改變多少;右邊則是左端流入減去右端流出。這裡先沿用圖中向右流動的情景;若 為負,表示流動方向向左,同一個帶正負號的公式仍然成立。
把區間縮小,才得到 density 的變化率
剛才算的是整個小區間的質量,現在想知道的是位置 附近的 density 如何改變。我們把守恆式兩邊除以區間長度 ,再令 。當 density 與 flux 足夠平滑時,左邊趨近 ,右邊則成為 flux 的空間導數:
這個負號就來自「流入減流出」:如果右端的 比左端的 大,flux 的空間變化率是正的,區間內卻在失去質量,所以 density 的時間變化率必須是負的。
在多維空間,小區域可以從各個方向流入或流出;把各方向的淨流出加總,就把一維的 換成 flux 的 divergence,得到
把局部守恆寫成 continuity equation
- 問的是:站在固定的位置看,這裡的 density 隨時間改變多少?
- 這裡有多擠,乘上大家走多快,得到 。只看速度,還不知道有多少 probability 通過。
- 對 flux 取 divergence,把附近各方向的淨流出加起來。這是前面一維「右端減左端」的多維版本。
- 淨流出越多,當地 density 就下降得越快。因此 density 的時間變化,加上 flux 的淨流出,必須等於零。
這就是 continuity equation。 看的是「固定位置的 density 隨時間改變多少」; 看的是「附近的 probability flux 有多少淨流出」。一個地方的質量會改變,是因為有人流進來、有人流出去;因此這裡要看的是 ,不能只看 的 divergence。
把每一群人的守恆式加起來
令 表示一組起終點。給定 ,我們替這群人設計一條 conditional probability path ,並知道推動它的 conditional velocity 。
把所有配對混合起來,就得到真正想要的 marginal path:
U2.1 的「從眾平均」可以寫成
第二式的權重正是 posterior:只有可能在時間 經過 的人,才會影響這裡的平均速度。
現在把 與 代進 continuity equation:
最後等於零,是因為每一條 conditional path 本來就各自守恆。把它們加起來之後,整群人仍然守恆。
Reference paths 可以被平均掉;只要平均的是 flux,得到的 velocity 就會推動正確的 marginal distribution。
這正是 Lipman 等人的 Conditional Flow Matching [1] 能成立的理由。生成時,粒子不必重走 training 中某一個人的 reference path;它們只需要沿著學到的 解 ODE。這裡使用的 neural ODE 觀點來自 Chen、Rubanova、Bettencourt 與 Duvenaud [2]:
最後的 就會服從我們設計的 。
補充用 test function 直接證明,不需要假設每條 conditional path 都有 density
上一段先替每一群人寫 continuity equation,再把 probability flux 加總。也可以從 random reference path 本身直接證明。
令 、,並定義
對任意 smooth test function ,
第一行是 chain rule,第二行使用 conditional expectation。最後做 integration by parts,就得到 continuity equation 的 weak form:
這個證明不要求固定 後的 conditional path 本身具有一般的 density;即使它只是一條曲線、對應到 Dirac measure,也仍然成立。當 夠 regular、使 ODE 有唯一解時,從同一個 出發的 ODE marginals 就必須等於這條 。
補充CFM loss 與理想 FM loss 差在哪裡?
如果我們真的拿得到 marginal velocity,可以寫
實際訓練的 CFM 則用 conditional velocity 當 label。把 L2 展開,或直接用 conditional variance decomposition,就有
多出來的項不含 ,所以兩者的梯度與最佳解相同;它只表示同一位置可能同時出現多少種不同的 reference velocities。
補充同一條 density path 只有一個 velocity 嗎?
不一定。如果 滿足 ,那麼 也生成同一個 。例如圓形人群可以整團繞圈,density 完全不變。
所以 continuity equation 保證「走到哪個 distribution」,不保證每個人走哪一條軌跡。這份自由會在下一個單元變成取樣效率的問題。
快速回顧一下
參考文獻
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. ICLR 2023. (Theorem 1 與 Theorem 2。)
- Chen, R. T. Q., Rubanova, Y., Bettencourt, J., Duvenaud, D. Neural Ordinary Differential Equations. NeurIPS 2018. (以 neural ODE 定義 continuous normalizing flow。)