學完這篇,你能
倒著走一步,怎麼變成一個可以訓練的 regression? 真正的 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) x 0 x_0 x 0 模型學完後,怎麼真的從 x T x_T x T x 0 x_0 x 0 網路可以預測 x 0 x_0 x 0 ϵ \epsilon ϵ v v v
本篇重用 7 篇 倒著走一步,如何從 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
上一篇我們已經把前進的路 forward process 給設計好了:知道怎麼從 x t − 1 x_{t-1} x t − 1 x t x_t x t x t x_t x t x 0 x_0 x 0 x t x_t x t x t − 1 x_{t-1} x t − 1 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
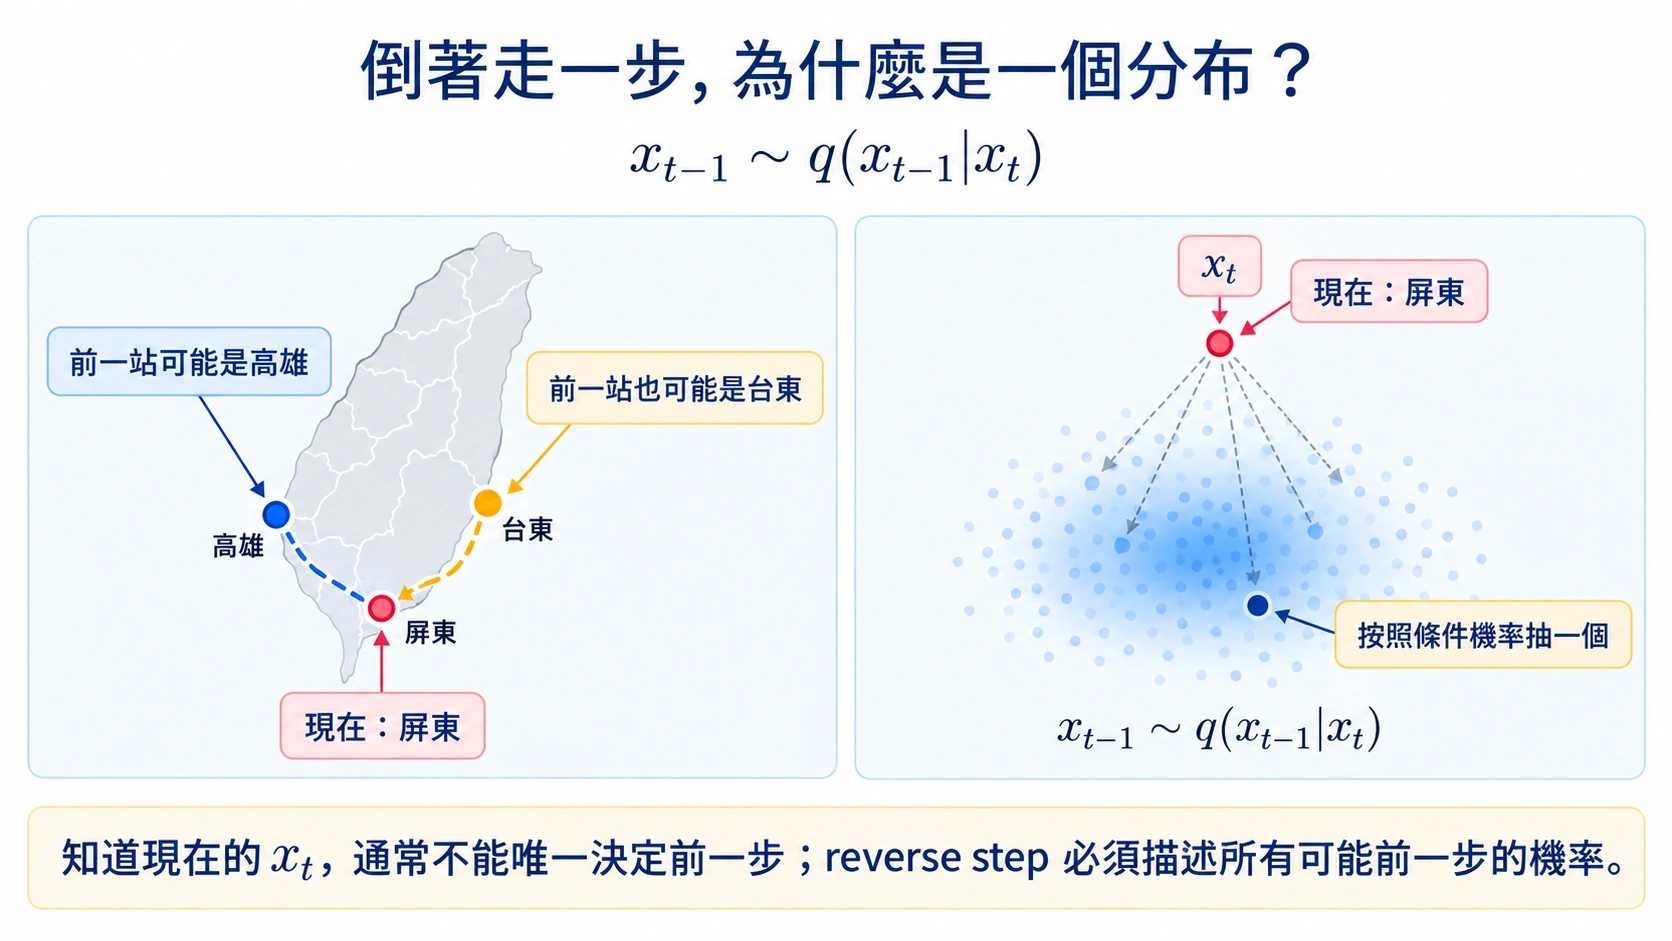
複習 為什麼是「從 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) 先複習 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) 給定現在的 x t x_t x t x t − 1 x_{t-1} x t − 1
用上一篇那條從台大到屏東的路線來說:給定現在人在屏東 ,前一站是高雄 (走西部)還是台東 (繞東部)?機率會告訴我們每一種可能性有多大,我們就照著它抽一個——抽到高雄或台東都是合理的答案。
左圖固定現在的位置,仍留下不同的可能來路;右圖的紅點是已知的 x t x_t x t q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) x t − 1 x_{t-1} x t − 1
Week 3 投影片 27 · 點圖查看原圖 為什麼要寫成「分布」而不是「一個答案」?因為加噪那一步真的把資訊丟掉了:很多不同的 x t − 1 x_{t-1} x t − 1 x t x_t x t 要怎麼用 ——每一步真的抽一個,還是每一步都走一個確定的方向——那是另一個問題,U1.4 會看到兩種做法都成立。
首先我們知道,x t x_t x t x t − 1 x_{t-1} x t − 1 x t x_t x t x t − 1 x_{t-1} x t − 1 一整個範圍的可能 。我們要的就是那個範圍上的機率密度。
課堂提問 Q1
最直覺的想法是把加噪那一步直接反解。既然
x t = α t x t − 1 + β t ϵ t , x_t=\sqrt{\alpha_t}\,x_{t-1}+\sqrt{\beta_t}\,\epsilon_t , x t = α t x t − 1 + β t ϵ t , 那我就抽一個 ϵ t ∼ N ( 0 , I ) \epsilon_t\sim\mathcal N(0,I) ϵ t ∼ N ( 0 , I )
x t − 1 = ( x t − β t ϵ t ) / α t x_{t-1}=\big(x_t-\sqrt{\beta_t}\,\epsilon_t\big)\big/\sqrt{\alpha_t} x t − 1 = ( x t − β t ϵ t ) / α t 不就好了嗎?反正 noise 本來就是隨機抽的。
這樣為什麼不行?
先想一想,再展開看整理後的答案 問題出在「ϵ t \epsilon_t ϵ t 加噪的時候 成立,在取樣的時候 不成立。
加噪時,我們先有 x t − 1 x_{t-1} x t − 1 ϵ t \epsilon_t ϵ t x t x_t x t ϵ t \epsilon_t ϵ t x t − 1 x_{t-1} x t − 1 x t x_t x t ϵ t \epsilon_t ϵ t ϵ t \epsilon_t ϵ t x t x_t x t 不是獨立的 :看到 x t x_t x t ϵ t \epsilon_t ϵ t ϵ t \epsilon_t ϵ t
我們可以透過計算兩者之間的共變數 (covariance)來證明不獨立這件事。因為 ϵ t \epsilon_t ϵ t x t − 1 x_{t-1} x t − 1
Cov ( ϵ t , x t ) = Cov ( ϵ t , α t x t − 1 + β t ϵ t ) = β t I ≠ 0. \operatorname{Cov}(\epsilon_t,\,x_t)
=\operatorname{Cov}\big(\epsilon_t,\ \sqrt{\alpha_t}\,x_{t-1}+\sqrt{\beta_t}\,\epsilon_t\big)
=\sqrt{\beta_t}\,I\;\ne\;0 . Cov ( ϵ t , x t ) = Cov ( ϵ t , α t x t − 1 + β t ϵ t ) = β t I = 0. covariance 不是零,就代表有相關;有相關,就不能另外抽一個與 x t x_t x t ϵ t \epsilon_t ϵ t
那「不獨立」到底改變了什麼?ϵ t \epsilon_t ϵ t marginal distribution 仍然是 N ( 0 , I ) \mathcal N(0,I) N ( 0 , I ) x t x_t x t ϵ t \epsilon_t ϵ t N ( 0 , I ) \mathcal N(0,I) N ( 0 , I ) x t x_t x t ϵ t \epsilon_t ϵ t
回到上一篇的洗牌。你把一副排好的牌洗了一次,然後只看到洗完的樣子——沒看到洗之前。洗牌當然是隨機的,但你看到的那個結果,本身就透露了那一次是怎麼洗的 :如果洗完之後有幾張還連在一起,那一次顯然沒把那一段拆開。
所以你不能說「反正洗牌是隨機的」,就自己隨便洗一次、再宣稱這樣就把它倒回去了——那樣只會回到一個錯的順序。ϵ t \epsilon_t ϵ t x t x_t x t
所以反解這條路是行不通的。那如果我們老老實實去算 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
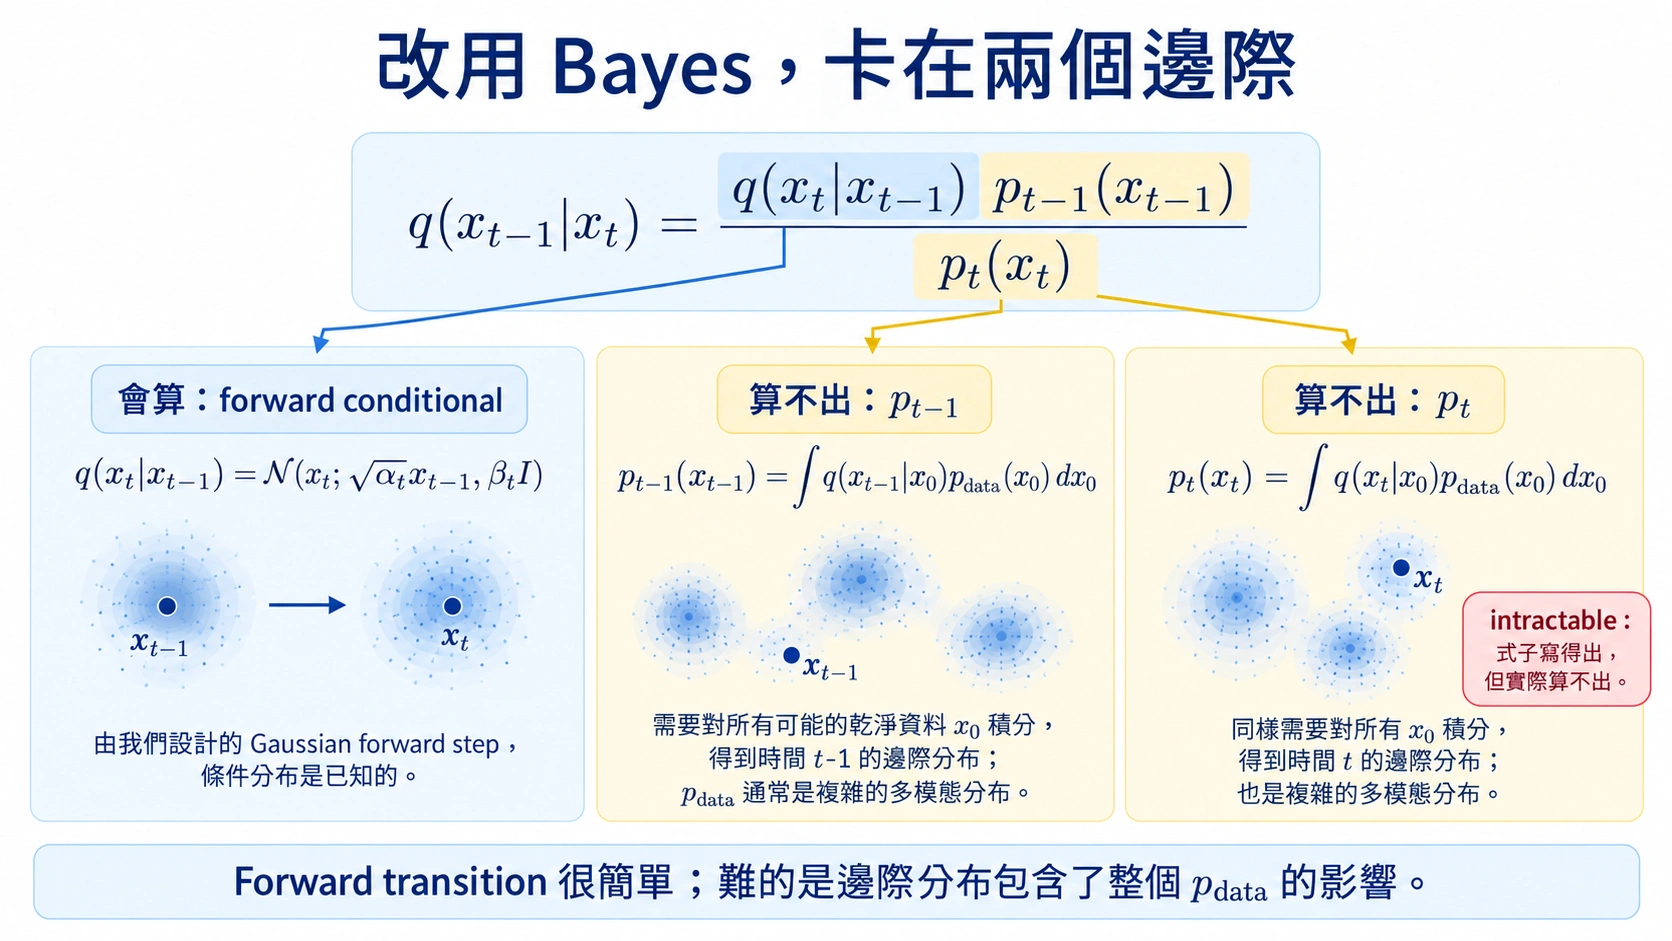
因為我們是知道 q ( x t ∣ x t − 1 ) q(x_t\mid x_{t-1}) q ( x t ∣ x t − 1 ) q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) M1.3 ):
分子的 q ( x t ∣ x t − 1 ) q(x_t\mid x_{t-1}) q ( x t ∣ x t − 1 ) U1.1 )。但右邊還有 p t − 1 ( x t − 1 ) p_{t-1}(x_{t-1}) p t − 1 ( x t − 1 ) p t ( x t ) p_t(x_t) p t ( x t ) 資料經過加噪之後的 marginal distribution ,也就是「所有真實圖片加噪 t t t x t x_t x t p t p_t p t p data p_{\text{data}} p data 不可算(intractable) 。
藍色框是我們設計的 q ( x t ∣ x t − 1 ) q(x_t\mid x_{t-1}) q ( x t ∣ x t − 1 ) p t ( x t ) = ∫ q ( x t ∣ x 0 ) p data ( x 0 ) d x 0 p_t(x_t)=\int q(x_t\mid x_0)p_{\text{data}}(x_0)\,\mathrm dx_0 p t ( x t ) = ∫ q ( x t ∣ x 0 ) p data ( x 0 ) d x 0
Week 3 投影片 32 · 點圖查看原圖
如果算不出來,那可不可以用「學」的?那要怎麼學?
我們先換一個角度想。其實我們本來就沒有打算把所有東西都直接算出來——如果每一個 quantity 都可以直接算,那我們根本就不需要 learning。
所以現在既然真正的 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) 學一個東西來逼近它 ?例如,用一個 neural network 來參數化一個 conditional distribution p θ ( x t − 1 ∣ x t ) p_\theta(x_{t-1}\mid x_t) p θ ( x t − 1 ∣ x t ) 想辦法調整 θ \theta θ p θ ( x t − 1 ∣ x t ) p_\theta(x_{t-1}\mid x_t) p θ ( x t − 1 ∣ x t ) q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
如果這件事做得到,那我們是不是就不需要真的把 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
問題就從:
「這個 distribution 要怎麼算?」
變成:
「我要怎麼設計一個 learning problem,讓 neural network 把它學出來?」
那就來設計這個 learning problem。第一件事是把「接近」說清楚——也就是寫下一個 loss function。兩個分布之間最常用的那個 loss function 是 Kullback–Leibler divergence (M5.1 ),以下都簡稱 KL ;而 x t x_t x t x t x_t x t
J ( θ ) = E p t ( x t ) [ D K L ( q ( x t − 1 ∣ x t ) ∥ p θ ( x t − 1 ∣ x t ) ) ] . \mathcal J(\theta)=\mathbb E_{p_t(x_t)}\Big[D_{\mathrm{KL}}\big(q(x_{t-1}\mid x_t)\,\big\|\,p_\theta(x_{t-1}\mid x_t)\big)\Big]. J ( θ ) = E p t ( x t ) [ D KL ( q ( x t − 1 ∣ x t ) p θ ( x t − 1 ∣ x t ) ) ] . 這一行就是最直覺、我們真正想要最小化的東西。好消息是 learning objective 有了,壞消息是裡面那個 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
課堂提問 Q2
我們常常在想一個方法的時候、遇到問題就會忘記靜下心來看看我們有什麼?能做什麼?這時不如回頭看一下我們一開始到底有什麼資訊是可以用的——forward process 給了我們什麼?
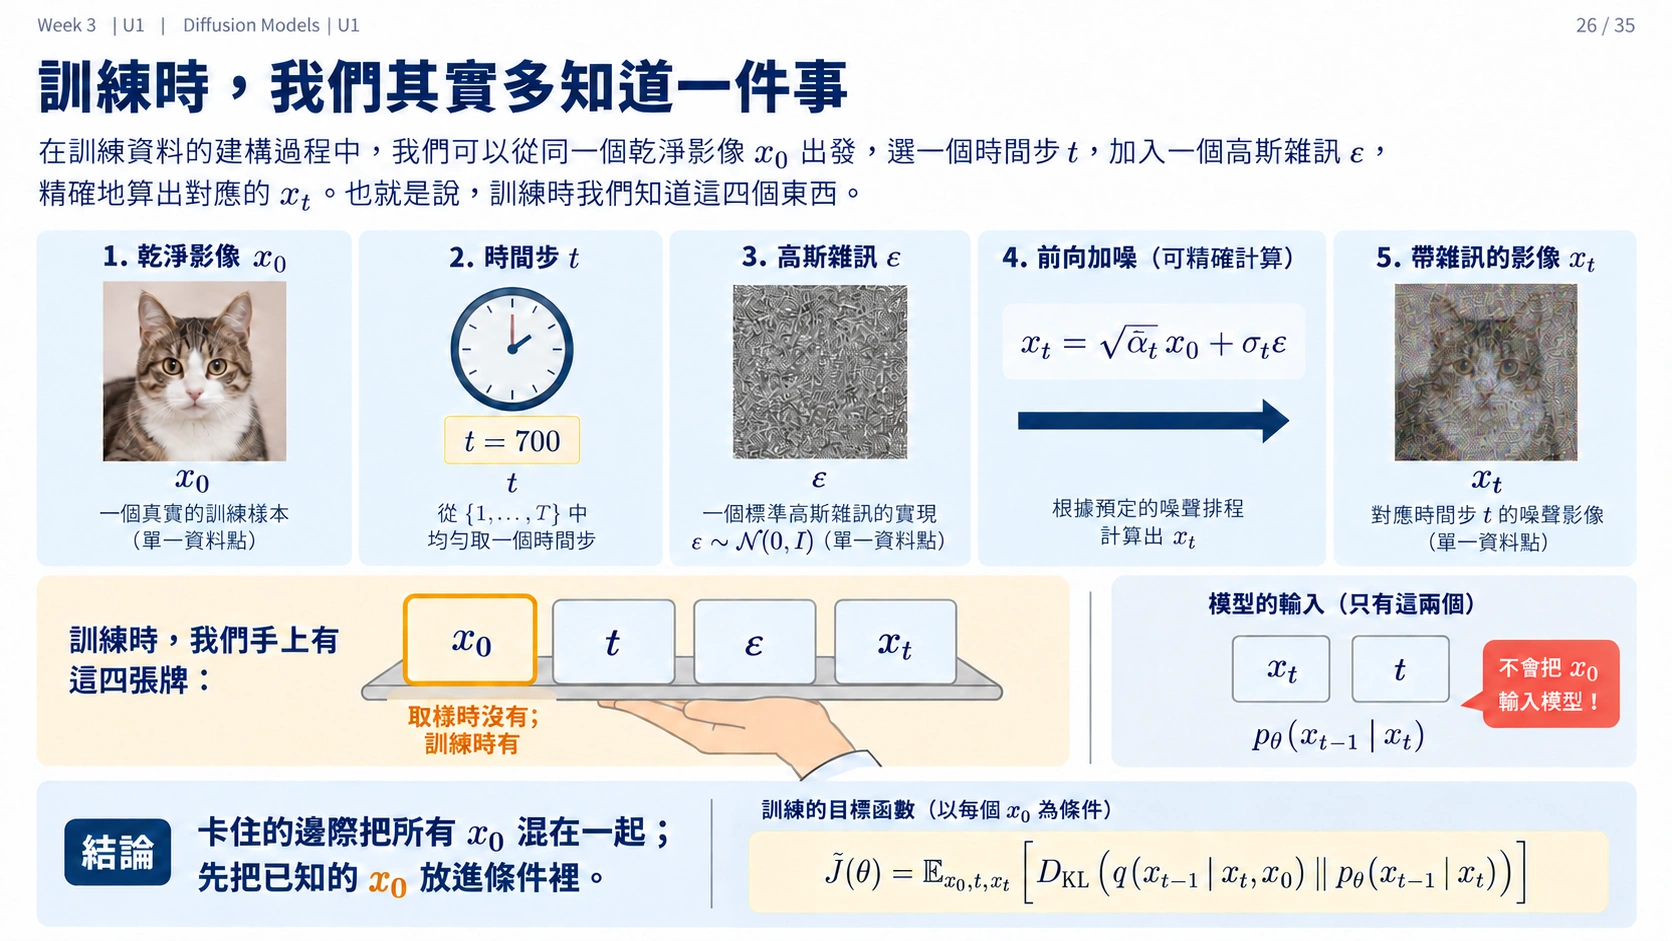
我們在 forward process 建立的是一筆要拿來訓練的資料,我們做的是:抽一張資料集裡的真實圖片 x 0 x_0 x 0 t t t ϵ \epsilon ϵ x t x_t x t x t x_t x t ( x 0 , ϵ , t ) (x_0,\epsilon,t) ( x 0 , ϵ , t )
那這其中有誰可以幫助我們算出 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
先想一想,再展開看整理後的答案 x 0 x_0 x 0
寫 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) x t x_t x t x 0 x_0 x 0 p t − 1 ( x t − 1 ) p_{t-1}(x_{t-1}) p t − 1 ( x t − 1 ) p t ( x t ) p_t(x_t) p t ( x t ) 所有可能的 x 0 x_0 x 0 。
既然算不動的原因是「要考慮所有的 x 0 x_0 x 0 把 x 0 x_0 x 0 看看。
訓練的時候,我們其實多知道一件事
先不要急著看公式。想一下 x t x_t x t
訓練的時候,我們先從 dataset 拿一張真正的資料 x 0 x_0 x 0 x t x_t x t x t x_t x t x 0 x_0 x 0 x t x_t x t x 0 x_0 x 0
那問題來了:如果 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) x 0 x_0 x 0
q ( x t − 1 ∣ x t ) , 而是問 q ( x t − 1 ∣ x t , x 0 ) . q(x_{t-1}\mid x_t),\qquad\text{而是問}\qquad q(x_{t-1}\mid x_t,x_0). q ( x t − 1 ∣ x t ) , 而是問 q ( x t − 1 ∣ x t , x 0 ) . 答案是:會,而且它可以直接算出來。那我們可不可以拿這個「算得出來的東西」來教模型?於是把 training objective 改寫成
J ~ ( θ ) = E p data ( x 0 ) E q ( x t ∣ x 0 ) [ D K L ( q ( x t − 1 ∣ x t , x 0 ) ∥ p θ ( x t − 1 ∣ x t ) ) ] . \widetilde{\mathcal J}(\theta)=\mathbb E_{p_{\text{data}}(x_0)}\ \mathbb E_{q(x_t\mid x_0)}
\Big[D_{\mathrm{KL}}\big(q(x_{t-1}\mid x_t,x_0)\,\big\|\,p_\theta(x_{t-1}\mid x_t)\big)\Big]. J ( θ ) = E p data ( x 0 ) E q ( x t ∣ x 0 ) [ D KL ( q ( x t − 1 ∣ x t , x 0 ) p θ ( x t − 1 ∣ x t ) ) ] . 這裡有一個看起來很奇怪的地方:左邊那個拿來當 target 的 q ( x t − 1 ∣ x t , x 0 ) q(x_{t-1}\mid x_t,x_0) q ( x t − 1 ∣ x t , x 0 ) 看得到 x 0 x_0 x 0 ,但右邊我們真正要學的 p θ ( x t − 1 ∣ x t ) p_\theta(x_{t-1}\mid x_t) p θ ( x t − 1 ∣ x t ) 看不到 。
為什麼?因為 generation 的時候我們根本沒有 x 0 x_0 x 0 x t x_t x t x 0 x_0 x 0 x t x_t x t
Training 時,我們掌握 ( x 0 , t , ϵ , x t ) (x_0,t,\epsilon,x_t) ( x 0 , t , ϵ , x t ) x 0 x_0 x 0 q ( x t − 1 ∣ x t , x 0 ) q(x_{t-1}\mid x_t,x_0) q ( x t − 1 ∣ x t , x 0 ) ( x t , t ) (x_t,t) ( x t , t ) p θ ( x t − 1 ∣ x t ) p_\theta(x_{t-1}\mid x_t) p θ ( x t − 1 ∣ x t ) x 0 x_0 x 0
Week 3 投影片 37 · 點圖查看原圖
這看起來有點像作弊,甚至更嚴重:兩邊條件的東西根本不一樣。我們真的還是在學原本那個 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
是。而且這裡不是 approximation。
在看證明之前,先想一下為什麼它會成立。固定一個 x t x_t x t 很多張不同的 x 0 x_0 x 0 給造出來。而每一筆訓練資料都拿出一個不一樣的 x 0 x_0 x 0 x t x_t x t x 0 x_0 x 0 就是把所有 x 0 x_0 x 0 ,而那個平均就會是 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
也就是這個意思:
E p ( x 0 ∣ x t ) [ q ( x t − 1 ∣ x t , x 0 ) ] = q ( x t − 1 ∣ x t ) . \mathbb E_{p(x_0\mid x_t)}\big[q(x_{t-1}\mid x_t,x_0)\big]=q(x_{t-1}\mid x_t). E p ( x 0 ∣ x t ) [ q ( x t − 1 ∣ x t , x 0 ) ] = q ( x t − 1 ∣ x t ) . 所以兩個 objective 分別是:直接對齊那個算不出來的 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) q ( x t − 1 ∣ x t , x 0 ) q(x_{t-1}\mid x_t,x_0) q ( x t − 1 ∣ x t , x 0 ) E p ( x 0 ∣ x t ) [ ⋅ ] \mathbb E_{p(x_0\mid x_t)}[\,\cdot\,] E p ( x 0 ∣ x t ) [ ⋅ ] q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
這裡用的雖然是 KL,但和 L2 那種把差距平方起來的距離有類似的性質;以 L2 舉一個 toy example,寫 a ˉ = a 1 + a 2 + a 3 3 \bar a=\frac{a_1+a_2+a_3}{3} a ˉ = 3 a 1 + a 2 + a 3 1 3 [ ( x − a 1 ) 2 + ( x − a 2 ) 2 + ( x − a 3 ) 2 ] \frac13\big[(x-a_1)^2+(x-a_2)^2+(x-a_3)^2\big] 3 1 [ ( x − a 1 ) 2 + ( x − a 2 ) 2 + ( x − a 3 ) 2 ] ( x − a ˉ ) 2 (x-\bar a)^2 ( x − a ˉ ) 2 x x x
1 3 [ ( x − a 1 ) 2 + ( x − a 2 ) 2 + ( x − a 3 ) 2 ] = ( x − a ˉ ) 2 + ( a 1 − a ˉ ) 2 + ( a 2 − a ˉ ) 2 + ( a 3 − a ˉ ) 2 3 ⏟ 不含 x . \frac13\big[(x-a_1)^2+(x-a_2)^2+(x-a_3)^2\big]
=(x-\bar a)^2
+\underbrace{\frac{(a_1-\bar a)^2+(a_2-\bar a)^2+(a_3-\bar a)^2}{3}}_{\text{不含 }x} . 3 1 [ ( x − a 1 ) 2 + ( x − a 2 ) 2 + ( x − a 3 ) 2 ] = ( x − a ˉ ) 2 + 不含 x 3 ( a 1 − a ˉ ) 2 + ( a 2 − a ˉ ) 2 + ( a 3 − a ˉ ) 2 . 根據這樣的性質,我們預測會有:
J ~ ( θ ) = J ( θ ) + C ⟹ arg min θ J ~ ( θ ) = arg min θ J ( θ ) , \widetilde{\mathcal J}(\theta)=\mathcal J(\theta)+C
\quad\Longrightarrow\quad
\arg\min_\theta\ \widetilde{\mathcal J}(\theta)=\arg\min_\theta\ \mathcal J(\theta), J ( θ ) = J ( θ ) + C ⟹ arg θ min J ( θ ) = arg θ min J ( θ ) , 其中 C C C θ \theta θ p θ p_\theta p θ p ⋆ ( x t − 1 ∣ x t ) p^\star(x_{t-1}\mid x_t) p ⋆ ( x t − 1 ∣ x t ) E p ( x 0 ∣ x t ) [ q ( x t − 1 ∣ x t , x 0 ) ] \mathbb E_{p(x_0\mid x_t)}\big[q(x_{t-1}\mid x_t,x_0)\big] E p ( x 0 ∣ x t ) [ q ( x t − 1 ∣ x t , x 0 ) ] q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
所以我們只是把一個算不出來的 learning objective,換成一個算得出來、但最佳解完全相同的 objective。模型從來沒有直接拿那個算不出來的 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) x 0 x_0 x 0
動手 自己實際推一次:為什麼 J ~ ( θ ) = J ( θ ) + C \widetilde{\mathcal J}(\theta)=\mathcal J(\theta)+C J ( θ ) = J ( θ ) + C 我們想證明的是:雖然 training 時改用 q ( x t − 1 ∣ x t , x 0 ) q(x_{t-1}\mid x_t,x_0) q ( x t − 1 ∣ x t , x 0 ) q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t )
先固定一個 x t x_t x t
D K L ( q ( x t − 1 ∣ x t , x 0 ) ∥ p θ ( x t − 1 ∣ x t ) ) . D_{\mathrm{KL}}\big(q(x_{t-1}\mid x_t,x_0)\,\big\|\,p_\theta(x_{t-1}\mid x_t)\big). D KL ( q ( x t − 1 ∣ x t , x 0 ) p θ ( x t − 1 ∣ x t ) ) . 把 KL 的定義展開:
D K L ( q ( x t − 1 ∣ x t , x 0 ) ∥ p θ ( x t − 1 ∣ x t ) ) = ∫ q ( x t − 1 ∣ x t , x 0 ) log q ( x t − 1 ∣ x t , x 0 ) d x t − 1 − ∫ q ( x t − 1 ∣ x t , x 0 ) log p θ ( x t − 1 ∣ x t ) d x t − 1 . \begin{aligned}
&D_{\mathrm{KL}}\big(q(x_{t-1}\mid x_t,x_0)\,\big\|\,p_\theta(x_{t-1}\mid x_t)\big)\\[4pt]
&=\int q(x_{t-1}\mid x_t,x_0)\log q(x_{t-1}\mid x_t,x_0)\,\mathrm dx_{t-1}\\[2pt]
&\quad-\int q(x_{t-1}\mid x_t,x_0)\log p_\theta(x_{t-1}\mid x_t)\,\mathrm dx_{t-1}.
\end{aligned} D KL ( q ( x t − 1 ∣ x t , x 0 ) p θ ( x t − 1 ∣ x t ) ) = ∫ q ( x t − 1 ∣ x t , x 0 ) log q ( x t − 1 ∣ x t , x 0 ) d x t − 1 − ∫ q ( x t − 1 ∣ x t , x 0 ) log p θ ( x t − 1 ∣ x t ) d x t − 1 . 先看第一項:
∫ q ( x t − 1 ∣ x t , x 0 ) log q ( x t − 1 ∣ x t , x 0 ) d x t − 1 . \int q(x_{t-1}\mid x_t,x_0)\log q(x_{t-1}\mid x_t,x_0)\,\mathrm dx_{t-1}. ∫ q ( x t − 1 ∣ x t , x 0 ) log q ( x t − 1 ∣ x t , x 0 ) d x t − 1 . 這裡完全沒有 θ \theta θ x 0 x_0 x 0 x t x_t x t θ \theta θ
因此真正會影響 learning 的,是第二項:
− ∫ q ( x t − 1 ∣ x t , x 0 ) log p θ ( x t − 1 ∣ x t ) d x t − 1 . -\int q(x_{t-1}\mid x_t,x_0)\log p_\theta(x_{t-1}\mid x_t)\,\mathrm dx_{t-1}. − ∫ q ( x t − 1 ∣ x t , x 0 ) log p θ ( x t − 1 ∣ x t ) d x t − 1 . 現在對「有可能造出這個 x t x_t x t x 0 x_0 x 0
− E p ( x 0 ∣ x t ) [ ∫ q ( x t − 1 ∣ x t , x 0 ) log p θ ( x t − 1 ∣ x t ) d x t − 1 ] . -\,\mathbb E_{p(x_0\mid x_t)}\Big[\int q(x_{t-1}\mid x_t,x_0)\log p_\theta(x_{t-1}\mid x_t)\,\mathrm dx_{t-1}\Big]. − E p ( x 0 ∣ x t ) [ ∫ q ( x t − 1 ∣ x t , x 0 ) log p θ ( x t − 1 ∣ x t ) d x t − 1 ] . 注意 log p θ ( x t − 1 ∣ x t ) \log p_\theta(x_{t-1}\mid x_t) log p θ ( x t − 1 ∣ x t ) x t x_t x t x t − 1 x_{t-1} x t − 1 x 0 x_0 x 0 x 0 x_0 x 0
− ∫ [ ∫ q ( x t − 1 ∣ x t , x 0 ) p ( x 0 ∣ x t ) d x 0 ] log p θ ( x t − 1 ∣ x t ) d x t − 1 . -\int\Big[\int q(x_{t-1}\mid x_t,x_0)\,p(x_0\mid x_t)\,\mathrm dx_0\Big]\log p_\theta(x_{t-1}\mid x_t)\,\mathrm dx_{t-1}. − ∫ [ ∫ q ( x t − 1 ∣ x t , x 0 ) p ( x 0 ∣ x t ) d x 0 ] log p θ ( x t − 1 ∣ x t ) d x t − 1 . 那中括號裡是什麼?
∫ q ( x t − 1 ∣ x t , x 0 ) p ( x 0 ∣ x t ) d x 0 . \int q(x_{t-1}\mid x_t,x_0)\,p(x_0\mid x_t)\,\mathrm dx_0 . ∫ q ( x t − 1 ∣ x t , x 0 ) p ( x 0 ∣ x t ) d x 0 . 它的意思就是:已知現在的 x t x_t x t x 0 x_0 x 0 p ( x 0 ∣ x t ) p(x_0\mid x_t) p ( x 0 ∣ x t )
q ( x t − 1 ∣ x t ) . q(x_{t-1}\mid x_t). q ( x t − 1 ∣ x t ) . 因此第二項變成
− ∫ q ( x t − 1 ∣ x t ) log p θ ( x t − 1 ∣ x t ) d x t − 1 , -\int q(x_{t-1}\mid x_t)\log p_\theta(x_{t-1}\mid x_t)\,\mathrm dx_{t-1}, − ∫ q ( x t − 1 ∣ x t ) log p θ ( x t − 1 ∣ x t ) d x t − 1 , 也就是 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) p θ p_\theta p θ
而原本的 D K L ( q ( x t − 1 ∣ x t ) ∥ p θ ( x t − 1 ∣ x t ) ) D_{\mathrm{KL}}\big(q(x_{t-1}\mid x_t)\,\big\|\,p_\theta(x_{t-1}\mid x_t)\big) D KL ( q ( x t − 1 ∣ x t ) p θ ( x t − 1 ∣ x t ) ) θ \theta θ q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) θ \theta θ
因此兩個 objective 最後只差一個與 θ \theta θ
J ~ ( θ ) = J ( θ ) + C ⟹ arg min θ J ~ ( θ ) = arg min θ J ( θ ) . \widetilde{\mathcal J}(\theta)=\mathcal J(\theta)+C
\quad\Longrightarrow\quad
\arg\min_\theta\ \widetilde{\mathcal J}(\theta)=\arg\min_\theta\ \mathcal J(\theta). J ( θ ) = J ( θ ) + C ⟹ arg θ min J ( θ ) = arg θ min J ( θ ) . 而當模型夠有表達能力的時候,最佳的情況就是
p θ ( x t − 1 ∣ x t ) = q ( x t − 1 ∣ x t ) . p_\theta(x_{t-1}\mid x_t)=q(x_{t-1}\mid x_t). p θ ( x t − 1 ∣ x t ) = q ( x t − 1 ∣ x t ) . 所以 training 時雖然用了額外知道的 x 0 x_0 x 0
這個「取平均」的、將不可算變成可以算的技巧,這門課中會反覆看到,以下都叫它 conditional trick 。Lai、Song、Kim、Mitsufuji 與 Ermon [2] 系統性地整理了它在 diffusion models 裡的不同版本。它每一次出現的形狀都一樣:不可算的目標是一個邊際量,而把某個東西放進條件裡之後就算得出來,剩下的平均交給 loss 自己做。 這一篇用的是 KL 版本;U1.3 會用到 MSE 版本,而 U2 的 conditional flow matching 是速度版本。
把 q ( x t − 1 ∣ x t , x 0 ) q(x_{t-1}\mid x_t,x_0) q ( x t − 1 ∣ x t , x 0 )
知道了 learning objective 是可行的之後,我們回過頭來算 q ( x t − 1 ∣ x t , x 0 ) q(x_{t-1}\mid x_t,x_0) q ( x t − 1 ∣ x t , x 0 )
q ( x t − 1 ∣ x t , x 0 ) = q ( x t ∣ x t − 1 , x 0 ) q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) = q ( x t ∣ x t − 1 ) q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) . q(x_{t-1}\mid x_t,x_0)
=\frac{q(x_t\mid x_{t-1},x_0)\,q(x_{t-1}\mid x_0)}{q(x_t\mid x_0)}
=\frac{q(x_t\mid x_{t-1})\,q(x_{t-1}\mid x_0)}{q(x_t\mid x_0)} . q ( x t − 1 ∣ x t , x 0 ) = q ( x t ∣ x 0 ) q ( x t ∣ x t − 1 , x 0 ) q ( x t − 1 ∣ x 0 ) = q ( x t ∣ x 0 ) q ( x t ∣ x t − 1 ) q ( x t − 1 ∣ x 0 ) . 第二個等號用的是 Markov property :q ( x t ∣ x t − 1 , x 0 ) = q ( x t ∣ x t − 1 ) q(x_t\mid x_{t-1},x_0)=q(x_t\mid x_{t-1}) q ( x t ∣ x t − 1 , x 0 ) = q ( x t ∣ x t − 1 ) x 0 x_0 x 0 q ( x t − 1 ∣ x 0 ) q(x_{t-1}\mid x_0) q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) q(x_t\mid x_0) q ( x t ∣ x 0 ) x 0 x_0 x 0 這三項全部都是 forward process 裡設計出來的 Gaussian 。
q ( x t ∣ x t − 1 ) q(x_t\mid x_{t-1}) q ( x t ∣ x t − 1 ) q ( x t − 1 ∣ x 0 ) q(x_{t-1}\mid x_0) q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) q(x_t\mid x_0) q ( x t ∣ x 0 ) U1.1 最後得到的 closed form(把 t t t t − 1 t-1 t − 1
q ( x t ∣ x t − 1 ) = N ( α t x t − 1 , β t I ) , 每一步的設計 q ( x t − 1 ∣ x 0 ) = N ( α ˉ t − 1 x 0 , ( 1 − α ˉ t − 1 ) I ) , closed form q ( x t ∣ x 0 ) = N ( α ˉ t x 0 , ( 1 − α ˉ t ) I ) . closed form \begin{aligned}
q(x_t\mid x_{t-1})&=\mathcal N\big(\sqrt{\alpha_t}\,x_{t-1},\ \beta_t I\big), &&\text{每一步的設計}\\[2pt]
q(x_{t-1}\mid x_0)&=\mathcal N\big(\sqrt{\bar\alpha_{t-1}}\,x_0,\ (1-\bar\alpha_{t-1})I\big), &&\text{closed form}\\[2pt]
q(x_t\mid x_0)&=\mathcal N\big(\sqrt{\bar\alpha_t}\,x_0,\ (1-\bar\alpha_t)I\big). &&\text{closed form}
\end{aligned} q ( x t ∣ x t − 1 ) q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) = N ( α t x t − 1 , β t I ) , = N ( α ˉ t − 1 x 0 , ( 1 − α ˉ t − 1 ) I ) , = N ( α ˉ t x 0 , ( 1 − α ˉ t ) I ) . 每一步的設計 closed form closed form Bayes 右邊在乘除的是三個機率密度 ,不是三個隨機變數。而 Gaussian 的密度是「exp \exp exp x x x
動手算一下:配出來的這個 Gaussian q ( x t − 1 ∣ x t , x 0 ) = N ( μ ~ t , β ~ t I ) q(x_{t-1}\mid x_t,x_0)=\mathcal N(\tilde\mu_t,\ \tilde\beta_t I) q ( x t − 1 ∣ x t , x 0 ) = N ( μ ~ t , β ~ t I ) x 0 x_0 x 0
動手 自己配一次方:μ ~ t \tilde\mu_t μ ~ t β ~ t \tilde\beta_t β ~ t 首先 q ( x t − 1 ∣ x t , x 0 ) q(x_{t-1}\mid x_t,x_0) q ( x t − 1 ∣ x t , x 0 ) x t − 1 x_{t-1} x t − 1 q ( x t − 1 ∣ x 0 ) q(x_{t-1}\mid x_0) q ( x t − 1 ∣ x 0 ) q ( x t ∣ x t − 1 ) q(x_t\mid x_{t-1}) q ( x t ∣ x t − 1 ) q ( x t ∣ x 0 ) q(x_t\mid x_0) q ( x t ∣ x 0 )
q ( x t − 1 ∣ x t , x 0 ) ∝ q ( x t − 1 ∣ x 0 ) q ( x t ∣ x t − 1 ) ∝ exp [ − ∥ x t − α t x t − 1 ∥ 2 2 β t − ∥ x t − 1 − α ˉ t − 1 x 0 ∥ 2 2 ( 1 − α ˉ t − 1 ) ] . q(x_{t-1}\mid x_t,x_0)\ \propto\ q(x_{t-1}\mid x_0)\,q(x_t\mid x_{t-1})
\ \propto\ \exp\Big[-\frac{\|x_t-\sqrt{\alpha_t}\,x_{t-1}\|^2}{2\beta_t}
-\frac{\|x_{t-1}-\sqrt{\bar\alpha_{t-1}}\,x_0\|^2}{2(1-\bar\alpha_{t-1})}\Big]. q ( x t − 1 ∣ x t , x 0 ) ∝ q ( x t − 1 ∣ x 0 ) q ( x t ∣ x t − 1 ) ∝ exp [ − 2 β t ∥ x t − α t x t − 1 ∥ 2 − 2 ( 1 − α ˉ t − 1 ) ∥ x t − 1 − α ˉ t − 1 x 0 ∥ 2 ] . 方括號裡是 x t − 1 x_{t-1} x t − 1
A = α t β t + 1 1 − α ˉ t − 1 , A=\frac{\alpha_t}{\beta_t}+\frac{1}{1-\bar\alpha_{t-1}}, A = β t α t + 1 − α ˉ t − 1 1 , 一次項寫成 − 2 b ⊤ x t − 1 -2\,b^\top x_{t-1} − 2 b ⊤ x t − 1
b = α t β t x t + α ˉ t − 1 1 − α ˉ t − 1 x 0 . b=\frac{\sqrt{\alpha_t}}{\beta_t}\,x_t+\frac{\sqrt{\bar\alpha_{t-1}}}{1-\bar\alpha_{t-1}}\,x_0 . b = β t α t x t + 1 − α ˉ t − 1 α ˉ t − 1 x 0 . 於是整個指數是 − A 2 ∥ x t − 1 − b / A ∥ 2 -\tfrac{A}{2}\big\|x_{t-1}-b/A\big\|^2 − 2 A x t − 1 − b / A 2 x t − 1 x_{t-1} x t − 1 β ~ t = 1 / A \tilde\beta_t=1/A β ~ t = 1/ A μ ~ t = b / A \tilde\mu_t=b/A μ ~ t = b / A
剩下的只是化簡。A A A α t ( 1 − α ˉ t − 1 ) + β t \alpha_t(1-\bar\alpha_{t-1})+\beta_t α t ( 1 − α ˉ t − 1 ) + β t U1.1 定義 α t \alpha_t α t α ˉ t \bar\alpha_t α ˉ t α t + β t = 1 \alpha_t+\beta_t=1 α t + β t = 1 α t α ˉ t − 1 = α ˉ t \alpha_t\bar\alpha_{t-1}=\bar\alpha_t α t α ˉ t − 1 = α ˉ t
α t − α t α ˉ t − 1 + β t = ( α t + β t ) − α ˉ t = 1 − α ˉ t , \alpha_t-\alpha_t\bar\alpha_{t-1}+\beta_t=(\alpha_t+\beta_t)-\bar\alpha_t=1-\bar\alpha_t , α t − α t α ˉ t − 1 + β t = ( α t + β t ) − α ˉ t = 1 − α ˉ t , 所以 β ~ t = ( 1 − α ˉ t − 1 ) β t 1 − α ˉ t \tilde\beta_t=\dfrac{(1-\bar\alpha_{t-1})\,\beta_t}{1-\bar\alpha_t} β ~ t = 1 − α ˉ t ( 1 − α ˉ t − 1 ) β t b b b
代進去,我們可以推出
q ( x t − 1 ∣ x t , x 0 ) = N ( μ ~ t ( x t , x 0 ) , β ~ t I ) , q(x_{t-1}\mid x_t,x_0)=\mathcal N\big(\tilde\mu_t(x_t,x_0),\ \tilde\beta_t I\big), q ( x t − 1 ∣ x t , x 0 ) = N ( μ ~ t ( x t , x 0 ) , β ~ t I ) , 且
μ ~ t = α ˉ t − 1 β t 1 − α ˉ t x 0 + α t ( 1 − α ˉ t − 1 ) 1 − α ˉ t x t , β ~ t = 1 − α ˉ t − 1 1 − α ˉ t β t . \tilde\mu_t=\frac{\sqrt{\bar\alpha_{t-1}}\,\beta_t}{1-\bar\alpha_t}\,x_0
+\frac{\sqrt{\alpha_t}\,(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}\,x_t,
\qquad
\tilde\beta_t=\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\,\beta_t . μ ~ t = 1 − α ˉ t α ˉ t − 1 β t x 0 + 1 − α ˉ t α t ( 1 − α ˉ t − 1 ) x t , β ~ t = 1 − α ˉ t 1 − α ˉ t − 1 β t . 這個分布的平均 μ ~ t \tilde\mu_t μ ~ t x 0 x_0 x 0 x t x_t x t 加權平均 ——一邊拉向起點、一邊留在原地,權重只由 forward process 設計的 schedule 決定。變異數 β ~ t \tilde\beta_t β ~ t 完全不含 x 0 x_0 x 0 x t x_t x t ,只是 schedule 的一個數字。
DDPM 的訓練
現在 learning objective 中的 target q ( x t − 1 ∣ x t , x 0 ) q(x_{t-1}\mid x_t,x_0) q ( x t − 1 ∣ x t , x 0 )
q ( x t − 1 ∣ x t , x 0 ) = N ( μ ~ t ( x t , x 0 ) , β ~ t I ) q(x_{t-1}\mid x_t,x_0)=\mathcal N\big(\tilde\mu_t(x_t,x_0),\ \tilde\beta_t I\big) q ( x t − 1 ∣ x t , x 0 ) = N ( μ ~ t ( x t , x 0 ) , β ~ t I ) 之中只有 μ ~ t ( x t , x 0 ) \tilde\mu_t(x_t,x_0) μ ~ t ( x t , x 0 ) x t x_t x t x 0 x_0 x 0 β ~ t \tilde\beta_t β ~ t μ ~ t ( x t , x 0 ) \tilde\mu_t(x_t,x_0) μ ~ t ( x t , x 0 ) x 0 x_0 x 0 x ^ θ ( x t , t ) \hat x_\theta(x_t,t) x ^ θ ( x t , t )
p θ ( x t − 1 ∣ x t ) = N ( μ ~ t ( x t , x ^ θ ( x t , t ) ) , β ~ t I ) . p_\theta(x_{t-1}\mid x_t)=\mathcal N\Big(\tilde\mu_t\big(x_t,\ \hat x_\theta(x_t,t)\big),\ \tilde\beta_t I\Big). p θ ( x t − 1 ∣ x t ) = N ( μ ~ t ( x t , x ^ θ ( x t , t ) ) , β ~ t I ) . 可以特別留意到這個神經網路的 input 是合理的:當下的狀態 x t x_t x t t t t U1.4 我們會討論這樣的假設帶來什麼代價,我們可不可以接受?)
這個選擇讓 learning objective 中的 KL 變成只剩兩個平均之間的距離:
D K L ( q ( x t − 1 ∣ x t , x 0 ) ∥ p θ ( x t − 1 ∣ x t ) ) = 1 2 β ~ t ∥ μ ~ t ( x t , x 0 ) − μ ~ t ( x t , x ^ θ ( x t , t ) ) ∥ 2 . \begin{aligned}
D_{\mathrm{KL}}\big(q(x_{t-1}\mid x_t,x_0)\,\big\|\,p_\theta(x_{t-1}\mid x_t)\big)
&=\frac{1}{2\tilde\beta_t}\Big\|\tilde\mu_t(x_t,x_0)-\tilde\mu_t\big(x_t,\hat x_\theta(x_t,t)\big)\Big\|^2 .
\end{aligned} D KL ( q ( x t − 1 ∣ x t , x 0 ) p θ ( x t − 1 ∣ x t ) ) = 2 β ~ t 1 μ ~ t ( x t , x 0 ) − μ ~ t ( x t , x ^ θ ( x t , t ) ) 2 . 最後得到 L 2 L_2 L 2 x t − 1 x_{t-1} x t − 1
而 μ ~ t \tilde\mu_t μ ~ t x 0 x_0 x 0 x 0 x_0 x 0 α ˉ t − 1 β t 1 − α ˉ t \frac{\sqrt{\bar\alpha_{t-1}}\,\beta_t}{1-\bar\alpha_t} 1 − α ˉ t α ˉ t − 1 β t
∥ μ ~ t ( x t , x 0 ) − μ ~ t ( x t , x ^ θ ) ∥ 2 = ( α ˉ t − 1 β t 1 − α ˉ t ) 2 ∥ x 0 − x ^ θ ∥ 2 . \Big\|\tilde\mu_t(x_t,x_0)-\tilde\mu_t\big(x_t,\hat x_\theta\big)\Big\|^2=\Big(\frac{\sqrt{\bar\alpha_{t-1}}\,\beta_t}{1-\bar\alpha_t}\Big)^{2}\big\|x_0-\hat x_\theta\big\|^2 . μ ~ t ( x t , x 0 ) − μ ~ t ( x t , x ^ θ ) 2 = ( 1 − α ˉ t α ˉ t − 1 β t ) 2 x 0 − x ^ θ 2 . 把它代回去,整個訓練目標就是一個加權的平方誤差 :
其中 x t = α ˉ t x 0 + σ t ϵ x_t=\sqrt{\bar\alpha_t}\,x_0+\sigma_t\epsilon x t = α ˉ t x 0 + σ t ϵ U1.0 說「路徑自己定,每一步就變成回歸」,指的就是這一行。
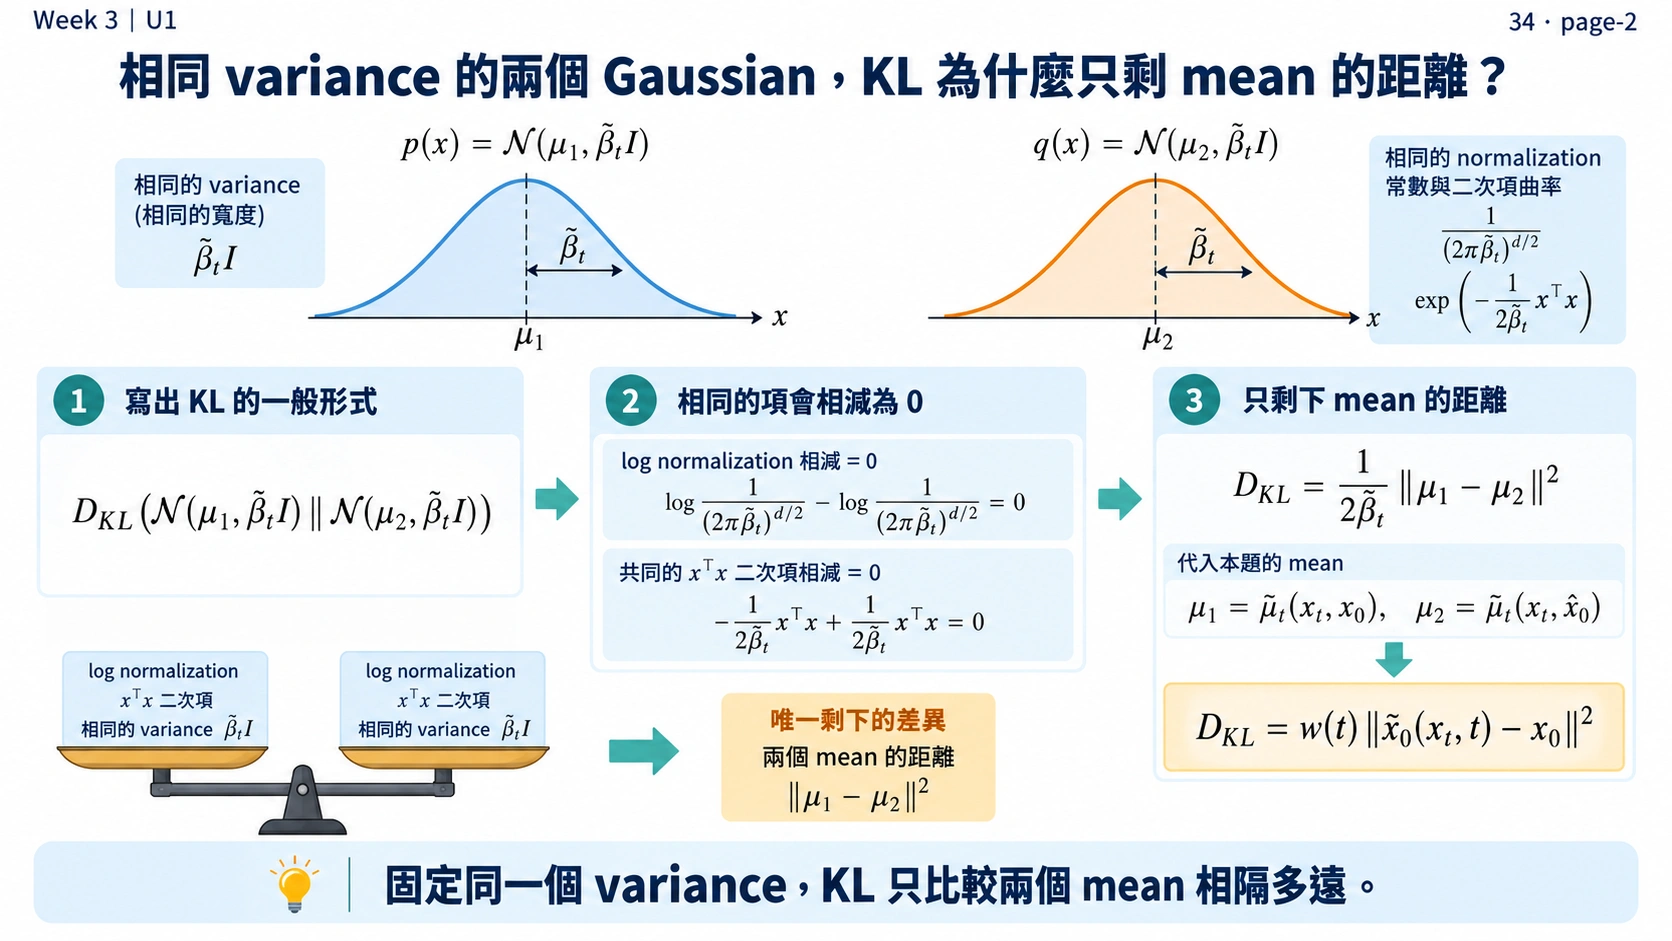
這裡的 μ 1 = μ ~ t ( x t , x 0 ) \mu_1=\tilde\mu_t(x_t,x_0) μ 1 = μ ~ t ( x t , x 0 ) μ 2 = μ ~ t ( x t , x ^ θ ( x t , t ) ) \mu_2=\tilde\mu_t(x_t,\hat x_\theta(x_t,t)) μ 2 = μ ~ t ( x t , x ^ θ ( x t , t )) β ~ t I \tilde\beta_t I β ~ t I ∥ μ 1 − μ 2 ∥ 2 / ( 2 β ~ t ) \|\mu_1-\mu_2\|^2/(2\tilde\beta_t) ∥ μ 1 − μ 2 ∥ 2 / ( 2 β ~ t ) μ ~ t \tilde\mu_t μ ~ t x 0 x_0 x 0 w ( t ) ∥ x ^ θ − x 0 ∥ 2 w(t)\|\hat x_\theta-x_0\|^2 w ( t ) ∥ x ^ θ − x 0 ∥ 2 x ^ 0 \hat x_0 x ^ 0 x ^ θ ( x t , t ) \hat x_\theta(x_t,t) x ^ θ ( x t , t )
Week 3 投影片 41 · 點圖查看原圖
在討論 w ( t ) w(t) w ( t )
L 2 L_2 L 2
課堂提問 Q3
在 U1.0 我們算過:拿 L 2 L_2 L 2 x 0 x_0 x 0 G θ ( z ) G_\theta(z) G θ ( z ) 一張所有訓練圖片的平均 ,模型會直接往它學習。現在這個 loss 也是 L 2 L_2 L 2 x ^ θ ( x t , t ) \hat x_\theta(x_t,t) x ^ θ ( x t , t ) x 0 x_0 x 0
為什麼這一次不會出問題?
先想一想,再展開看整理後的答案 差別只有一個字:配對 。
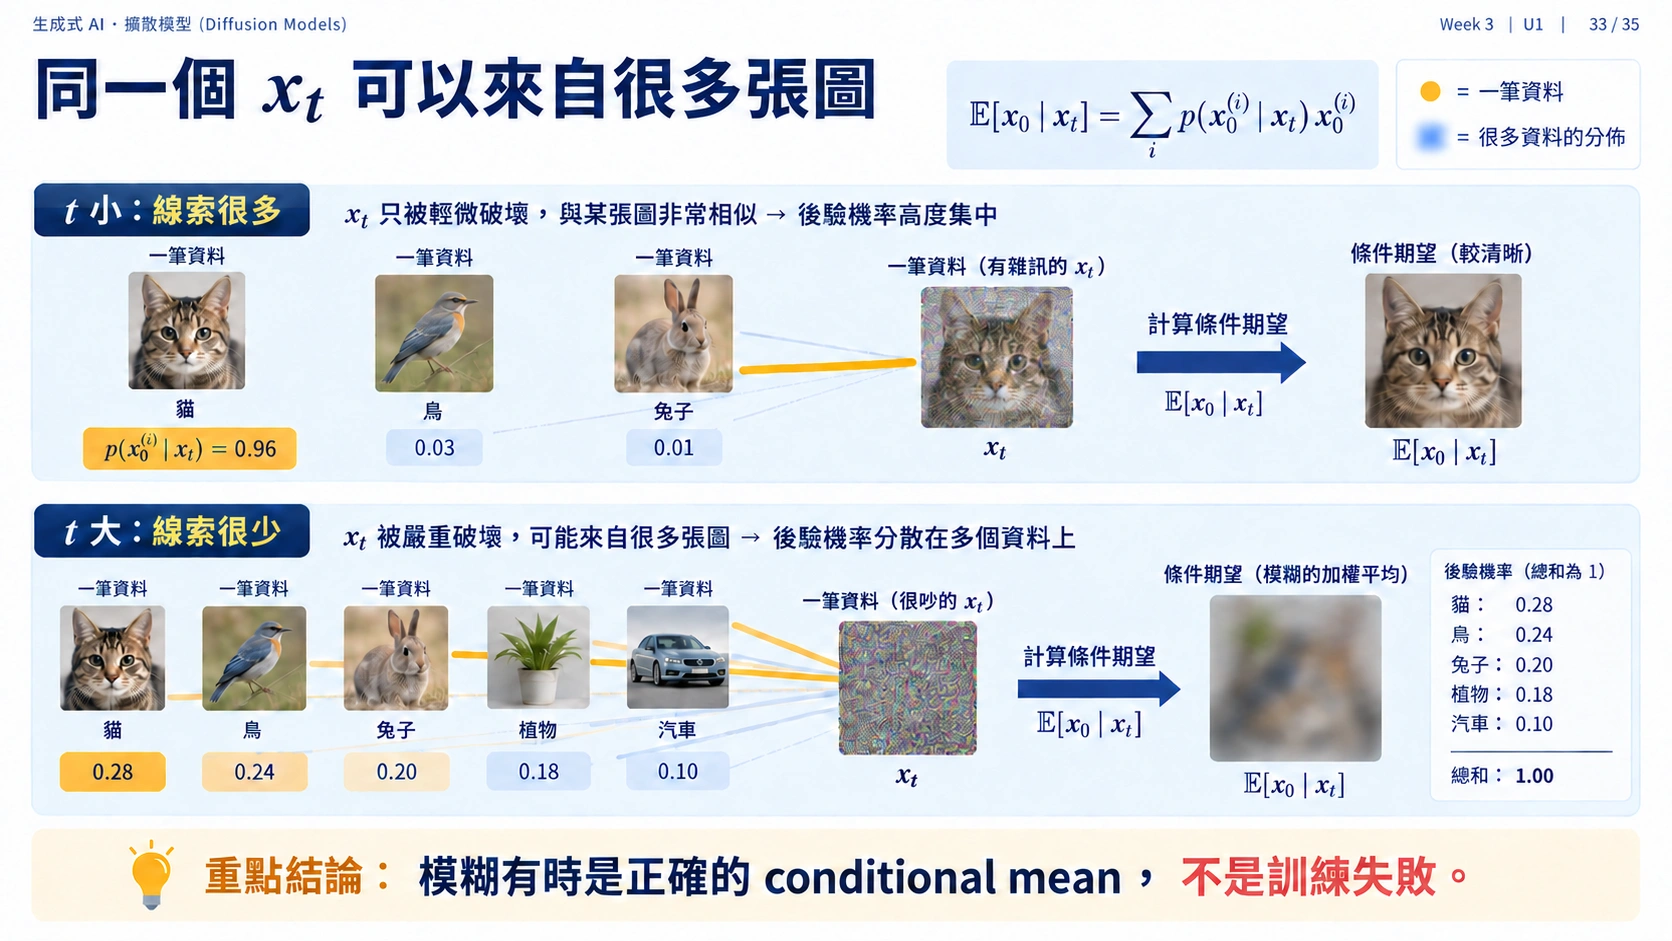
上一次 z z z x 0 x_0 x 0 z z z x 0 x_0 x 0 E p data [ x 0 ] \mathbb E_{p_{\text{data}}}[x_0] E p data [ x 0 ] x t x_t x t x 0 x_0 x 0 L 2 L_2 L 2 條件期望 (M1.2 ):
x ^ ⋆ ( x t , t ) = E [ x 0 ∣ x t ] . \hat x^{\star}(x_t,t)=\mathbb E\big[x_0\mid x_t\big]. x ^ ⋆ ( x t , t ) = E [ x 0 ∣ x t ] . 它是一個隨 x t x_t x t 的函數,不是常數。t t t x t x_t x t x 0 x_0 x 0 t t t x t x_t x t 本來就該 是模糊的。(這件事看下面那張圖會更清楚。)
雖然同樣是做 L 2 L_2 L 2 x t x_t x t
其中的差別就來自於模型的輸入和目標 x 0 x_0 x 0 1 / 4 1/4 1/4
(注意 w ( t ) w(t) w ( t ) t t t x ^ θ \hat x_\theta x ^ θ t t t
把這個最佳解代回 p θ p_\theta p θ μ ⋆ \mu^\star μ ⋆
μ ⋆ ( x t , t ) = μ ~ t ( x t , E [ x 0 ∣ x t ] ) , \mu^\star(x_t,t)=\tilde\mu_t\big(x_t,\ \mathbb E[x_0\mid x_t]\big), μ ⋆ ( x t , t ) = μ ~ t ( x t , E [ x 0 ∣ x t ] ) , 也就是真正那個邊際 q ( x t − 1 ∣ x t ) q(x_{t-1}\mid x_t) q ( x t − 1 ∣ x t ) 散布是 schedule 給的,中心由 E [ x 0 ∣ x t ] \mathbb E[x_0\mid x_t] E [ x 0 ∣ x t ]
(要說清楚的是:「L 2 L_2 L 2 提到 ,並沒有證明——上面是靠和前一個情境對照得到的。這個結論的證明與它真正的份量,U1.3 會好好討論。)
把可能原圖離散成 x 0 ( i ) x_0^{(i)} x 0 ( i ) E [ x 0 ∣ x t ] = ∑ i p ( x 0 ( i ) ∣ x t ) x 0 ( i ) \mathbb E[x_0\mid x_t]=\sum_i p(x_0^{(i)}\mid x_t)x_0^{(i)} E [ x 0 ∣ x t ] = ∑ i p ( x 0 ( i ) ∣ x t ) x 0 ( i ) ( 0.96 , 0.03 , 0.01 ) (0.96,0.03,0.01) ( 0.96 , 0.03 , 0.01 ) ( 0.28 , 0.24 , 0.20 , 0.18 , 0.10 ) (0.28,0.24,0.20,0.18,0.10) ( 0.28 , 0.24 , 0.20 , 0.18 , 0.10 ) 1 1 1
Week 3 投影片 43 · 點圖查看原圖
看一個點怎麼被去噪
互動 demo:去噪一個點。 在平面上點一個位置當成 x t x_t x t t t t p ( x 0 ∣ x t ) ∝ exp ( − ∥ x t − α ˉ t x 0 ∥ 2 / 2 σ t 2 ) p(x_0\mid x_t)\propto\exp\big(-\|x_t-\sqrt{\bar\alpha_t}x_0\|^2/2\sigma_t^2\big) p ( x 0 ∣ x t ) ∝ exp ( − ∥ x t − α ˉ t x 0 ∥ 2 /2 σ t 2 ) E [ x 0 ∣ x t ] \mathbb E[x_0\mid x_t] E [ x 0 ∣ x t ] t t t t t t 平均 的位置。
學完之後,怎麼真的走回去?
前面我們已經把模型訓練好了。現在假設手上有一個 x t x_t x t x t − 1 x_{t-1} x t − 1
我們前面把 reverse distribution 寫成
p θ ( x t − 1 ∣ x t ) , p_\theta(x_{t-1}\mid x_t), p θ ( x t − 1 ∣ x t ) , 而且選擇用 Gaussian 來 parametrize 它。網路負責預測 x ^ θ ( x t , t ) \hat x_\theta(x_t,t) x ^ θ ( x t , t )
這樣就完成一次 x t → x t − 1 x_t\to x_{t-1} x t → x t − 1
接下來沒有新的東西:從
x T ∼ N ( 0 , I ) x_T\sim\mathcal N(0,I) x T ∼ N ( 0 , I ) 開始,重複同樣的步驟,
x T → x T − 1 → ⋯ → x 1 → x 0 , x_T\to x_{T-1}\to\cdots\to x_1\to x_0, x T → x T − 1 → ⋯ → x 1 → x 0 , 最後就得到一個 sample。
到這裡,我們已經知道 DDPM 怎麼訓練,也知道訓練完之後怎麼拿來生成 。
這樣的 regression,憑什麼保證生成出來的東西是好的?
前面一路做下來,我們最後得到的只是一個 regression loss。但我們真正關心的是:把這個 loss 壓低,真的會讓模型生成的 data distribution 更接近資料實際的分布嗎?
根據其實是有的,我們可以沿著三個步驟去解釋、證明。
第一步:從 likelihood 出發。 我們希望模型對真實資料給高 likelihood,也就是讓 − log p θ ( x 0 ) -\log p_\theta(x_0) − log p θ ( x 0 ) p θ ( x 0 ) p_\theta(x_0) p θ ( x 0 ) q ( x 1 : T ∣ x 0 ) q(x_{1:T}\mid x_0) q ( x 1 : T ∣ x 0 )
− log p θ ( x 0 ) ≤ E q ( x 1 : T ∣ x 0 ) [ − log p θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) ] . -\log p_\theta(x_0)\ \le\ \mathbb E_{q(x_{1:T}\mid x_0)}\!\left[-\log\frac{p_\theta(x_{0:T})}{q(x_{1:T}\mid x_0)}\right]. − log p θ ( x 0 ) ≤ E q ( x 1 : T ∣ x 0 ) [ − log q ( x 1 : T ∣ x 0 ) p θ ( x 0 : T ) ] . 也就是說,我們可以改去最小化 negative log-likelihood 的一個上界,也就是 ELBO (evidence lower bound,見 當那個要加總的量算不出來,可以退到哪裡? )對應的 loss。
第二步:把整條 path 看成兩個 distribution。 再對 x 0 ∼ p data x_0\sim p_{\text{data}} x 0 ∼ p data
D K L ( q ( x 0 : T ) ∥ p θ ( x 0 : T ) ) + constant . D_{\mathrm{KL}}\big(q(x_{0:T})\,\big\|\,p_\theta(x_{0:T})\big)+\text{constant}. D KL ( q ( x 0 : T ) p θ ( x 0 : T ) ) + constant . 所以問題變成:讓模型的整條 reverse path,接近資料經過 forward process 產生的那條 path。
第三步:Markov structure 讓這個 path-level KL 可以逐步拆開。 最後跟 θ \theta θ
∑ t E p t ( x t ) [ D K L ( q ( x t − 1 ∣ x t ) ∥ p θ ( x t − 1 ∣ x t ) ) ] . \sum_t\mathbb E_{p_t(x_t)}\Big[D_{\mathrm{KL}}\big(q(x_{t-1}\mid x_t)\,\big\|\,p_\theta(x_{t-1}\mid x_t)\big)\Big]. t ∑ E p t ( x t ) [ D KL ( q ( x t − 1 ∣ x t ) p θ ( x t − 1 ∣ x t ) ) ] . 而這正是我們前面一路改寫、最後變成 regression loss 的東西。
所以整條關係是
regression loss ⟶ reverse-step KL ⟶ path KL ⟶ − log p θ ( x 0 ) 的上界 \boxed{\ \text{regression loss}\ \longrightarrow\ \text{reverse-step KL}\ \longrightarrow\ \text{path KL}\ \longrightarrow\ -\log p_\theta(x_0)\ \text{的上界}\ } regression loss ⟶ reverse-step KL ⟶ path KL ⟶ − log p θ ( x 0 ) 的上界 也就是說,前面的 regression 並不是憑空設計的:它一路可以接回我們真正關心的 generative likelihood。
不過這並不代表每一步都能完全學準。我們把 p θ ( x t − 1 ∣ x t ) p_\theta(x_{t-1}\mid x_t) p θ ( x t − 1 ∣ x t )
這也留下幾個後面的問題:這個 approximation 到底有多好?noise 一定要加嗎?如果 timestep 切得越來越細,又會發生什麼?
這些等到 U1.4 再討論!
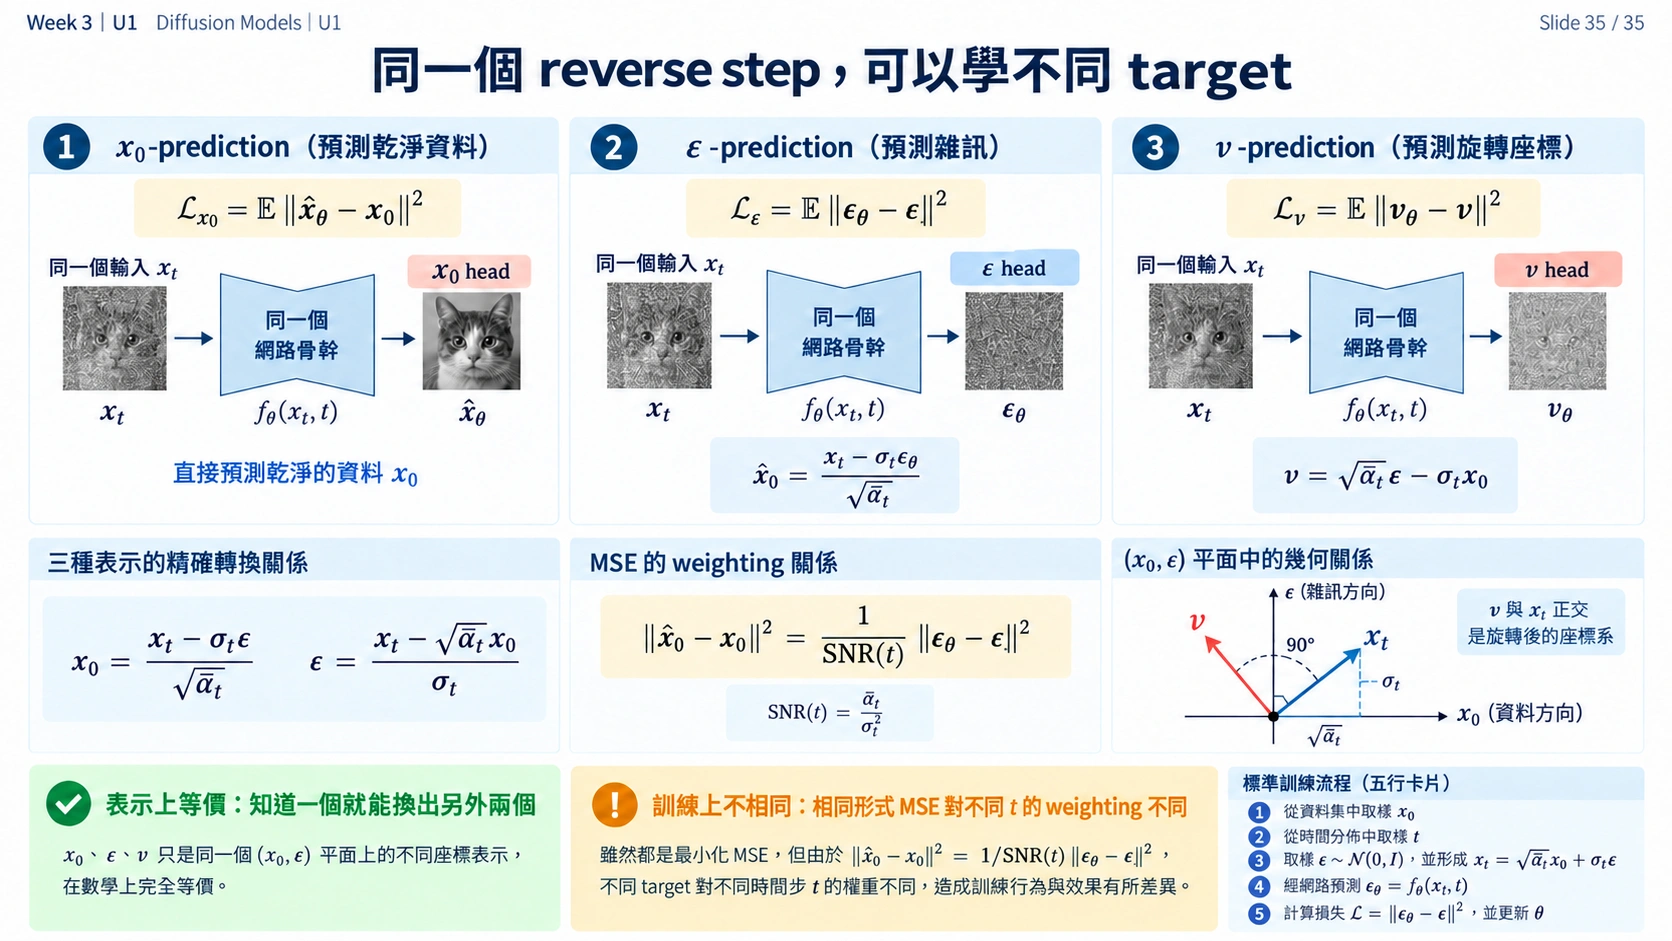
同一個 reverse step,不一定要學 x 0 x_0 x 0
由 x t = α ˉ t x 0 + σ t ϵ x_t=\sqrt{\bar\alpha_t}x_0+\sigma_t\epsilon x t = α ˉ t x 0 + σ t ϵ x t x_t x t x 0 x_0 x 0 ϵ \epsilon ϵ
x 0 = x t − σ t ϵ α ˉ t ⟺ ϵ = x t − α ˉ t x 0 σ t . x_0=\frac{x_t-\sigma_t\epsilon}{\sqrt{\bar\alpha_t}}
\qquad\Longleftrightarrow\qquad
\epsilon=\frac{x_t-\sqrt{\bar\alpha_t}x_0}{\sigma_t}. x 0 = α ˉ t x t − σ t ϵ ⟺ ϵ = σ t x t − α ˉ t x 0 . 所以,網路不一定非得直接預測 x 0 x_0 x 0 ϵ \epsilon ϵ x 0 x_0 x 0 parametrization 。
在我們目前這個 formulation 裡,實務上常見的選擇有三種:x 0 x_0 x 0 ϵ \epsilon ϵ v v v
x 0 x_0 x 0 x ^ 0 \hat x_0 x ^ 0
ϵ \epsilon ϵ
L ϵ = E [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] , x ^ 0 = x t − σ t ϵ θ α ˉ t . \mathcal L_\epsilon=\mathbb E\big[\|\epsilon_\theta(x_t,t)-\epsilon\|^2\big],
\qquad \hat x_0=\frac{x_t-\sigma_t\epsilon_\theta}{\sqrt{\bar\alpha_t}} . L ϵ = E [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] , x ^ 0 = α ˉ t x t − σ t ϵ θ . v v v ( α ˉ t , σ t ) (\sqrt{\bar\alpha_t},\sigma_t) ( α ˉ t , σ t ) ( cos ϕ t , sin ϕ t ) (\cos\phi_t,\sin\phi_t) ( cos ϕ t , sin ϕ t )
v = α ˉ t ϵ − σ t x 0 . v=\sqrt{\bar\alpha_t}\,\epsilon-\sigma_t\,x_0 . v = α ˉ t ϵ − σ t x 0 . v v v ( x 0 , ϵ ) (x_0,\epsilon) ( x 0 , ϵ ) x t x_t x t 垂直 的那個方向。它在 t → 0 t\to0 t → 0 ϵ \epsilon ϵ t → T t\to T t → T − x 0 -x_0 − x 0 U5.1 把步數減到很少的時候才真正派上用場——v v v
符號 為什麼 v 可以看成「垂直方向」? 因為 α ˉ t + σ t 2 = 1 \bar\alpha_t+\sigma_t^2=1 α ˉ t + σ t 2 = 1 α ˉ t = cos ϕ t \sqrt{\bar\alpha_t}=\cos\phi_t α ˉ t = cos ϕ t σ t = sin ϕ t \sigma_t=\sin\phi_t σ t = sin ϕ t
x t = cos ϕ t x 0 + sin ϕ t ϵ , v = cos ϕ t ϵ − sin ϕ t x 0 . x_t=\cos\phi_t\,x_0+\sin\phi_t\,\epsilon,\qquad
v=\cos\phi_t\,\epsilon-\sin\phi_t\,x_0 . x t = cos ϕ t x 0 + sin ϕ t ϵ , v = cos ϕ t ϵ − sin ϕ t x 0 . 在以 x 0 x_0 x 0 ϵ \epsilon ϵ x t x_t x t v v v 互相垂直的一組座標 ——v v v ϕ t \phi_t ϕ t x t x_t x t ϕ t \phi_t ϕ t ϕ t \phi_t ϕ t π / 2 \pi/2 π /2
三者之間可以透過 affine transformation 互相轉換,而且轉換係數只和 t t t 在表示上 ,只要知道其中一個,就可以直接算出另外兩個——給定其中一個訓好的網路,另外兩個不用重訓,代數換算就有了。實作那篇會要你親手驗證一次。
但用這三種 parametrization 去訓練,最後會得到完全一樣的結果嗎?
表示上等價,但訓練上不相同
假設我們都使用看起來一樣的 MSE loss——就是前面一路在用的那個平方誤差:
E [ ∥ prediction − target ∥ 2 ] , \mathbb E\big[\|\text{prediction}-\text{target}\|^2\big], E [ ∥ prediction − target ∥ 2 ] , 把 target 從 x 0 x_0 x 0 ϵ \epsilon ϵ v v v 對應回同一個 quantity 時,不同 noise level 的誤差會被乘上不同的權重。
把 x ^ 0 \hat x_0 x ^ 0 ϵ θ \epsilon_\theta ϵ θ
∥ x ^ 0 − x 0 ∥ 2 = σ t 2 α ˉ t ∥ ϵ θ − ϵ ∥ 2 = 1 S N R ( t ) ∥ ϵ θ − ϵ ∥ 2 , S N R ( t ) = α ˉ t 1 − α ˉ t . \|\hat x_0-x_0\|^2=\frac{\sigma_t^2}{\bar\alpha_t}\,\|\epsilon_\theta-\epsilon\|^2
=\frac{1}{\mathrm{SNR}(t)}\,\|\epsilon_\theta-\epsilon\|^2,
\qquad \mathrm{SNR}(t)=\frac{\bar\alpha_t}{1-\bar\alpha_t}. ∥ x ^ 0 − x 0 ∥ 2 = α ˉ t σ t 2 ∥ ϵ θ − ϵ ∥ 2 = SNR ( t ) 1 ∥ ϵ θ − ϵ ∥ 2 , SNR ( t ) = 1 − α ˉ t α ˉ t . 所以前面推出來的那個加權平方誤差,換到 ϵ \epsilon ϵ
J ~ ( θ ) = E t [ w ( t ) S N R ( t ) ⋅ ( 該 t 的 ϵ -loss ) ] , w ( t ) S N R ( t ) = β t 2 α t ( 1 − α ˉ t − 1 ) . \widetilde{\mathcal J}(\theta)=\mathbb E_t\Big[\tfrac{w(t)}{\mathrm{SNR}(t)}\cdot\big(\text{該 } t \text{ 的 }\epsilon\text{-loss}\big)\Big],
\qquad \frac{w(t)}{\mathrm{SNR}(t)}=\frac{\beta_t}{2\,\alpha_t\,(1-\bar\alpha_{t-1})}. J ( θ ) = E t [ SNR ( t ) w ( t ) ⋅ ( 該 t 的 ϵ -loss ) ] , SNR ( t ) w ( t ) = 2 α t ( 1 − α ˉ t − 1 ) β t . 所以三種 parametrization 雖然可以互相換算,但它們定義的 training objective 並不完全相同。
要小心「不完全相同」指的是什麼:不同寫法的最小值點是同一個 (都被同一個條件期望達成);不一樣的是在有限容量、有限訓練時間下,它們對不同 t t t
representation equivalent ≠ optimization equivalent \boxed{\text{representation equivalent} \;\neq\; \text{optimization equivalent}} representation equivalent = optimization equivalent 差別主要就在於:不同的 parametrization,會讓模型更重視不同 noise level 的誤差。
三欄代表三種可選的 target;f θ ( x t , t ) f_\theta(x_t,t) f θ ( x t , t ) x ^ 0 \hat x_0 x ^ 0 ϵ θ \epsilon_\theta ϵ θ v θ v_\theta v θ ∥ x ^ 0 − x 0 ∥ 2 = ∥ ϵ θ − ϵ ∥ 2 / S N R ( t ) \|\hat x_0-x_0\|^2=\|\epsilon_\theta-\epsilon\|^2/\mathrm{SNR}(t) ∥ x ^ 0 − x 0 ∥ 2 = ∥ ϵ θ − ϵ ∥ 2 / SNR ( t ) ( x 0 , ϵ ) (x_0,\epsilon) ( x 0 , ϵ ) 係數座標 旋轉,不是說任意兩張圖片向量 x t x_t x t v v v
Week 3 投影片 45 · 點圖查看原圖
這裡我們順便講一下 DDPM 原文實際採用的做法。
在實作上,它直接把這個 weighting w ( t ) w(t) w ( t ) ϵ \epsilon ϵ
L simple ( θ ) = E t , x 0 , ϵ [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] . \mathcal L_{\text{simple}}(\theta)=\mathbb E_{t,\,x_0,\,\epsilon}\big[\|\epsilon_\theta(x_t,t)-\epsilon\|^2\big]. L simple ( θ ) = E t , x 0 , ϵ [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] . 關於這樣的操作,我們可以理解成:
forward process 決定我們怎麼製造不同 noise level 的資料; weighting 決定 training 時多重視哪些 noise level。
兩件事其實可以分開設計。因此,即使 forward process 不變,我們仍然可以改變不同 t t t − log p θ ( x 0 ) -\log p_\theta(x_0) − log p θ ( x 0 ) t t t U2 比較 diffusion 與 flow matching 時,這個 distinction 還會再出現。
DDPM 的訓練核心其實就這五行
repeat
  x0 ← 一個 batch 的資料
  t  ← Uniform{1,…,T}
  ε  ← N(0, I)
  xt ← √ᾱ_t · x0 + √(1-ᾱ_t) · ε
  loss ← ‖ε_θ(xt, t) − ε‖²
  梯度下降
這裡我們先寫成 pseudo code。真的要實作,還需要決定 batch size、T T T ϵ θ \epsilon_\theta ϵ θ
到 U1.5 ,我們會把它真的寫成可以跑的程式。到時候你也會看到一個有趣的現象:loss 不會一路掉到 0,而會停在一個非零值附近。這不是程式寫錯;在 U1.3 ,我們會先了解為什麼這件事本來就應該發生。
消化一下
我們把原本不好算的 reverse problem,變成了可以實際訓練的 weighted MSE;也看到網路可以預測 x 0 x_0 x 0 ϵ \epsilon ϵ v v v
可是 DDPM 實際使用的 L simple \mathcal L_{\text{simple}} L simple 這樣訓練出來的網路,到底在學什麼?為什麼改掉 weighting 之後仍然有效?
下一篇會固定一個 noise level,直接找出這個 regression 的最佳解。答案是 E [ ϵ ∣ x t ] \mathbb E[\epsilon\mid x_t] E [ ϵ ∣ x t ] p t p_t p t
下一篇:U1.3 Tweedie 公式:Denoiser 和 Data Distribution 有什麼關係? →
參考文獻
Ho, J., Jain, A., Abbeel, P. Denoising Diffusion Probabilistic Models. ϵ \epsilon ϵ
Lai, C.-H., Song, Y., Kim, D., Mitsufuji, Y., Ermon, S. The Principles of Diffusion Models.
Salimans, T., Ho, J. Progressive Distillation for Fast Sampling of Diffusion Models. v v v
Kingma, D. P., Gao, R. Understanding Diffusion Objectives as the ELBO with Simple Data Augmentation.