
U2.4 Stochastic Interpolant: 統一 Flow 與 Diffusion
本篇重用5 篇
在 U2.1 到 U2.3,我們已經把 Flow Matching 的理想情況接起來了:先畫 reference paths,再用 L2 regression 學出 velocity,最後沿著 ODE 把 搬成 。當起點是 Gaussian 時,這個 velocity 還可以和 diffusion 的 denoiser、score 互相換算。
可是實際訓練後,我們拿到的從來不是精確的 ,而只是一個 loss 還不錯的 。這時真正重要的問題已經不只是「最佳解寫成什麼」,而是:
如果每個位置的 velocity 都差一點,最後生成的 distribution 會差多少?
而且,既然 velocity 與 score 都在描述同一條 ,我們是不是只能沿著 ODE 走?還是也能用 SDE 走過同一組 marginals,並得到不同的誤差保證?
要回答這些問題,我們需要的不是再多一個方法名稱,而是一套能同時回答四件事的架構:中間的 怎麼來、網路要學什麼、生成時可以怎麼走,以及 training error 最後控制了什麼。
能不能從一個同時涵蓋 Flow 與 Diffusion 的 framework 出發,
分析它們生成的 distribution 與真實 distribution 之間的誤差是否可控?
Stochastic Interpolant: 將 reference paths 寫成一個 random process
在 U2.1,我們先隨意抽出一組端點 ,再建立 reference path 將它們接起來。其實可以把這個過程寫得更完整一點:先考慮 、 本身來自兩個 distributions,
接下來,如何「抽出一組端點」,對應到的就是 的 joint distribution:
在這裡,我們也稱 為 coupling——也就是將兩端 couple 起來的方法。
補充Coupling 的嚴謹定義
給定定義在 、 上的兩個 distributions 、,coupling 是 product space 上的 probability distribution ,並且對任意 measurable sets 、,滿足
所有符合條件的 組成 。所以 coupling 可以改變 與 之間的關係,但不能改變任何一端原本的 distribution。
我們前面採取的是最直接的做法:獨立分別從 、 各抽一個點,
也就是 independent coupling。但這不是唯一的選擇。
回到散場的例子, 告訴我們人群原本站在哪裡, 告訴我們最後各個捷運站有多少人。Independent coupling 就像不看位置,隨機替每個人抽一個捷運站;站在象山方向的人可能被配到市政府站,許多人的路便會互相交叉。
但如果我們已經知道每個人的位置,就可以把靠近象山的人優先配到象山站、靠近市政府的人優先配到市政府站,同時維持每個車站原本的人數。兩種方法的 與 完全相同,改變的只有「誰和誰配成一組」——也就是 coupling。
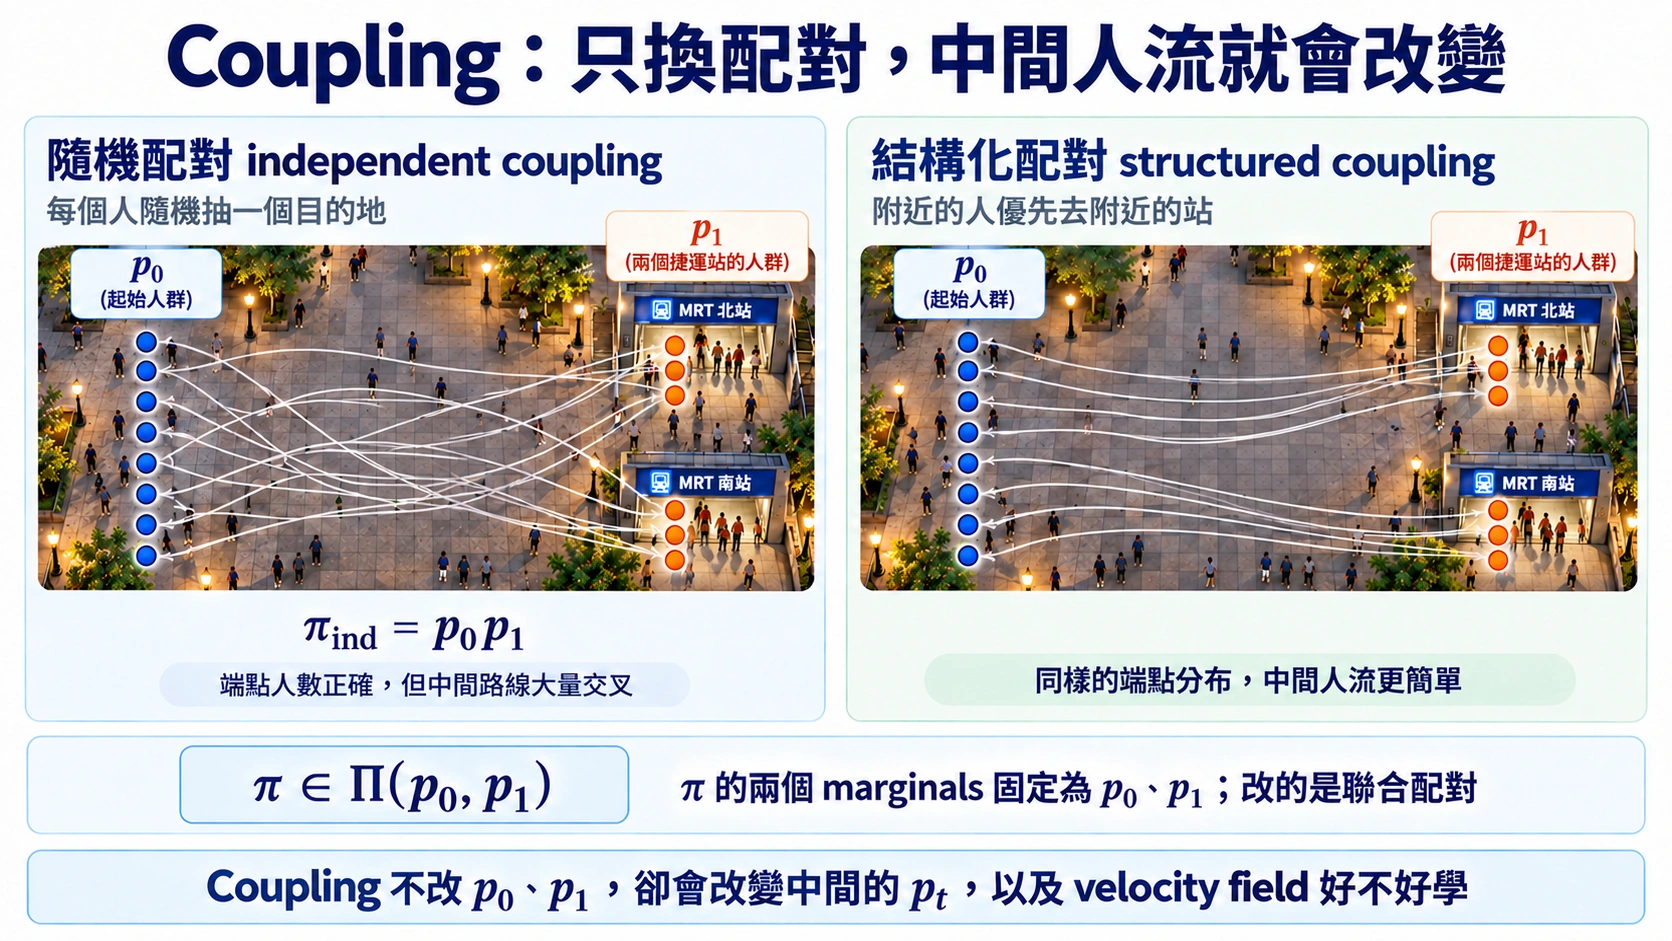
圖:兩端的人群與各站人數保持不變;改變 coupling ,只改變誰被配到哪一站,卻會改變中途的 reference paths 與 。
有了抽取端點的方法後,我們才替每一組 建立 reference path。例如,
先從 抽出端點,再把抽到的端點放進 :
固定端點後, 是一條沒有隨機性的 reference path;但端點本身是隨機抽出的,所以 是 random variable。Albergo、Boffi 與 Vanden-Eijnden [1] 把這樣連接兩端 distributions 的 random process 稱為 stochastic interpolant;這套架構延續了 Albergo 與 Vanden-Eijnden [2] 先前用 stochastic interpolants 建立 normalizing flows 的做法。
從我們在起點與終點看到的 particles 出發,先按照 決定每個人要去哪一站,再按照 算出他們在時間 的位置;所有位置形成的 distribution 就是
所以, 決定哪些端點會配在一起, 決定每組端點中途怎麼走;兩者合在一起,才決定每個時刻空拍照中的 。 即使 與 完全相同,換掉其中任何一個部分,中間的人群分布都可能改變。
沿用跨年散場的例子,可以把幾個容易混在一起的物件分開:
| 物件 | 散場例子 | 數學角色 |
|---|---|---|
| Coupling | 決定哪一個人要去哪一站 | |
| Reference path | 指定某個人的起點與捷運站後,替他畫出的路 | |
| Stochastic interpolant | 隨機抽出一組端點後,他在時間 的位置 | |
| Marginal path | 在時間 拍一張空拍照,看到整群人如何分布 | |
| ODE trajectory | 迷路的人跟著學到的平均人潮後,真正走出的路 |
Reference path 是用來製造 training label 的路;stochastic interpolant 是先隨機抽取端點,再沿著 reference path 得到的 random process; 是它在每個時刻留下的快照。真正生成時走的則是最後一列,通常不會重走某一條 reference path。
名稱為什麼 U2 先叫 reference path,到了這裡才叫 stochastic interpolant?
在 U2,我們先固定一組 ,只討論怎麼替這一組端點畫路,所以 reference path 比較直白。
現在先用 隨機抽取 ,再令 ,研究的才是整條 random process 與它的 marginal distributions,因此需要 stochastic interpolant 這個正式名稱。兩個名稱描述的是不同層次,不需要把前面的 reference path 全部改名。
在 reference path 外,再加入可以控制的 randomness
到這裡,coupling 與 reference path 已經足以定義一條 probability path。但「能接起兩端」不代表中間一定容易學。
回到散場的例子,如果許多 reference paths 在同一個路口交叉,人群可能在某個時刻全擠進一條很窄的巷子。這時 會變得很尖,甚至塌在低維的區域;附近的 velocity 也可能快速改變,讓神經網路與 numerical solver 都更難處理。
那能不能保留起點與終點,卻讓中間的人群不要擠得那麼尖?這套架構的做法是:在 reference path 外,再加入一個獨立的 Gaussian random variable ,
把端點、路徑與額外 randomness 接起來
- 從 coupling 抽出一組端點 。兩端各自的 distribution 不變,但配對方式可以設計。
- 是這組端點在 reference path 上的位置;係數控制兩端如何交接。
- 另外獨立抽出 Gaussian ,加上 。同一組端點現在能產生周圍的 training points; 保留兩端。
這裡沿用 U2.3 的時間方向與符號: 是起點、 是終點。因此
在散場的畫面裡, 就像讓每個人在 reference path 周圍保留一點活動空間,而不是所有人都踩在同一條細線上。因為 ,它不會改變兩端;改變的是中間每一張空拍照。
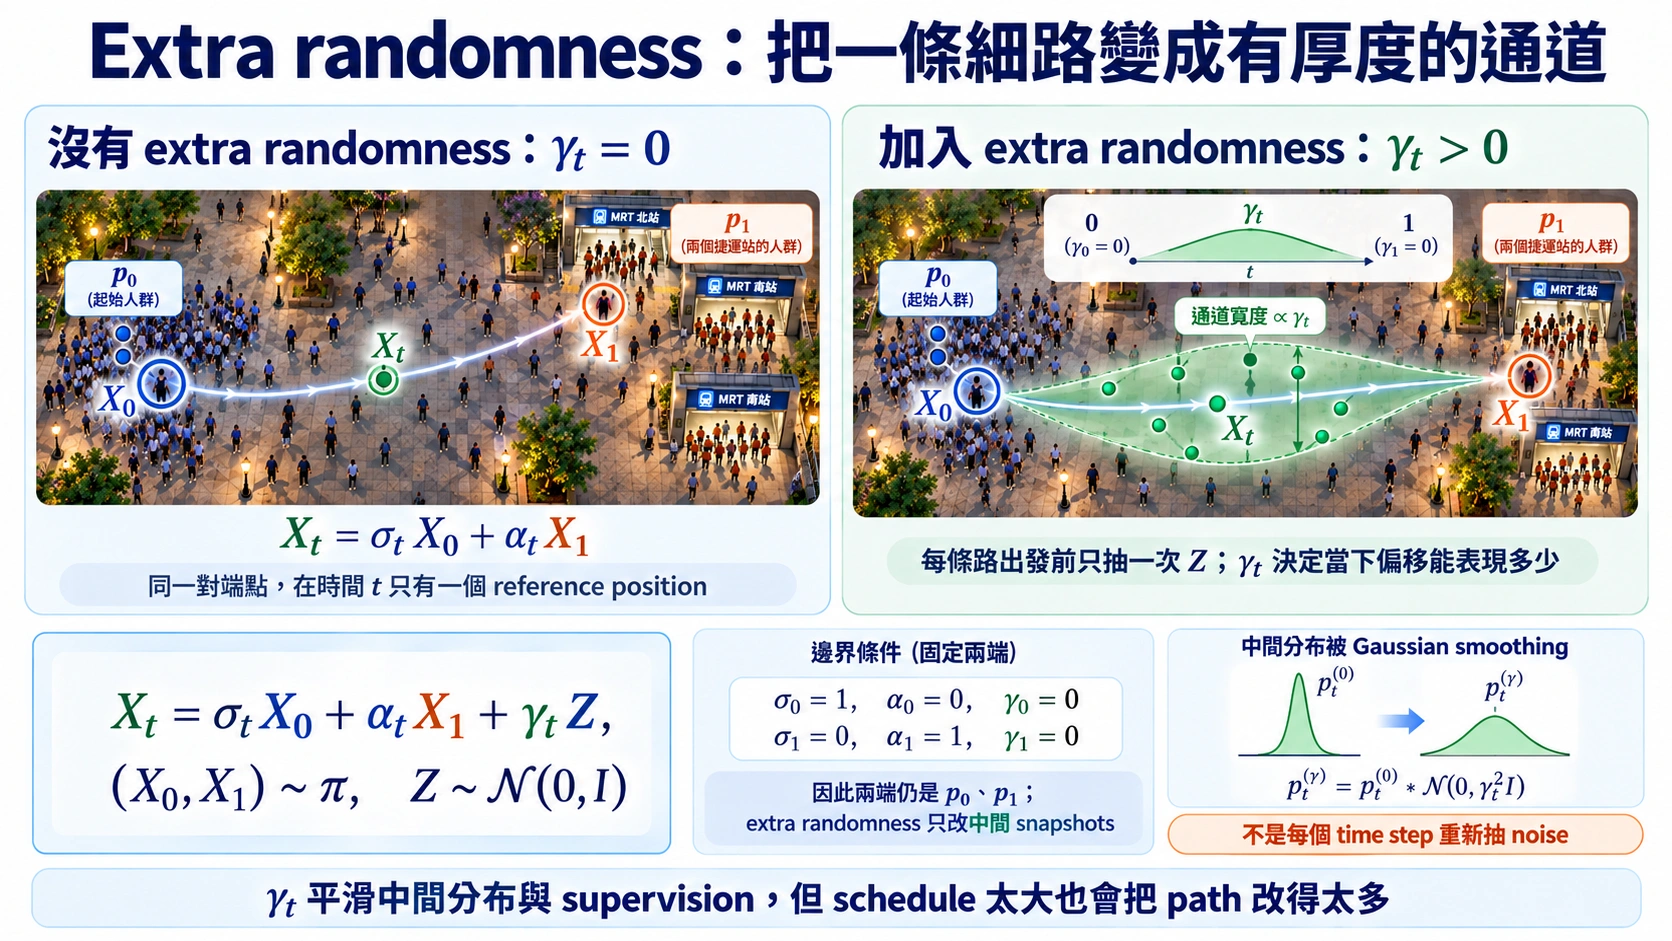
圖:固定同一對端點、改抽 ,中途位置就散開成有厚度的通道。 保留兩端;這是 interpolant 的 randomness,與 SDE 每一步的 Brownian increment 不同。
論文中的結果加入 有什麼理論與實務上的好處?
令 表示沒有額外 noise 時的中間 distribution。因為 是獨立 Gaussian,加入 後會精確得到
也就是把原本的 distribution 做一次 Gaussian smoothing。Albergo、Boffi 與 Vanden-Eijnden [1] 在其 regularity assumptions 下證明:當 時,中間的 density 與 velocity field 都會在空間上變得平滑。作者因此指出,生成時所需的 numerical integration 也會比較容易。
後來的研究把這個好處說得更具體:
- 讓 flow 更穩定。 在一端為 Gaussian 的相關設定中,Gao 等人 [5] 進一步證明了 velocity 的 Lipschitz regularity、flow 的存在與唯一性,以及 source distribution 或 learned velocity 被擾動時的 stability。也就是說,Gaussian smoothing 不只是讓圖看起來比較圓滑;它能直接提供 ODE well-posedness 與誤差控制所需的 regularity。
- 讓有限資料提供更密的 supervision。 對兩端都是 empirical distribution 的情況,原本每一組資料只畫出一條細線;加上 後,同一組端點會在周圍產生一整片 training points。Su 等人 [7] 證明,Gaussian smoothing 後的 empirical interpolant 與 population interpolant 之間的 距離不會更大,因此能縮小他們分析的 generalization gap。實驗中,完整的 stochastic-injection 方法在五個 image-to-image tasks 上比 standard Flow Matching 平均改善 13 FID;ablation 也顯示,單獨拿掉 interpolant noise 就會使結果變差。
- 降低某些 deterministic paths 的 memorization。 Reu 等人 [6] 證明,在他們分析的 straight-path setting 中,即使 training paths 彼此交叉,仍可能存在一個記住 training pairings 的 velocity field;在 CelebA 的實驗裡,加入少量 noise 後才恢復 generalization。這說明「每條線都穿過很多地方」不代表 supervision 已經足夠。
這個 Gaussian 還提供了一個訓練時已知的 label 。三位作者 [1] 進一步證明,它的 conditional expectation 可以直接換成 的 score;所以下面除了 velocity,我們也能用 L2 regression 學到 score,進而建立 ODE 與 SDE。
不過,這些結果不能簡化成「加入越多 noise 一定越好」。 會改變整條 ,而且 schedule 與 scale 都要選:Su 等人 [7] 的 ablation 裡,不同 schedule 的差距很大。Bertrand 等人 [8] 也在一端為 Gaussian 的 high-dimensional setting 中發現,把 stochastic regression target 換成 conditional mean 並不會傷害 generalization,有時反而更好。雖然他們研究的不是 ,但這提醒我們:interpolant smoothing、sampling randomness 與 noisy training target 是三種不同的 randomness,不能混成同一個「noise 有幫助」的理由。
這是 stochastic interpolant 中最常用、也足以包含 U1 與 U2 的 affine family。更一般的版本可以把前兩項換成任意的 reference map ;不過下面的內容我們先用 affine 來做說明。
現在有三件事是我們可以設計的:
- Path: 決定路徑。
- Coupling: 決定哪一個 與哪一個 會以多少的機率被配在一起。
- Extra randomness: 決定路徑中允許多大的額外 Gaussian variation。
如果把 reference path 想成一條畫好的路, 就像替它加上寬度: 時是一條線; 時,同一組端點在中途可以落在一條有厚度的通道裡。因為 ,這份 randomness 不會改變兩端的 distributions。
DDPM、DDIM 與 Flow Matching 都在這個架構裡
先把我們已經看過的方法,放回剛才的三項設計:
| 方法 | Path | Coupling | Extra randomness |
|---|---|---|---|
| Linear Flow Matching | |||
| DDPM/DDIM | ,且 |
U2.1 已經介紹過 如何畫出 linear path;DDPM/DDIM 的 是 data amplitude、 是 noise amplitude,兩者如何由 VP noise schedule 得到,則可以回顧 U1.1。
DDPM 與 DDIM 會放在同一列,是因為這張表記錄的是 stochastic interpolant 如何定義每個時刻的 。兩者使用相同的 VP path,只差在最後生成時怎麼 sample。
Ma 等人的 SiT [3] 則把同一套 interpolant 架構用到大規模影像生成,系統性地比較不同 path、training objective 與 deterministic/stochastic sampler。
這一列的 也不表示沒有 noise: 本身已經是 Gaussian noise。 是在 與 之外,另外加入、用來改變中間 的 randomness。
所以 stochastic interpolant 統一的,是 coupling 怎麼配對端點、path 怎麼連接端點,以及中途要不要加入額外 randomness。同一條 又能用哪些 dynamics 來生成,我們會在後面繼續推導。
同一個 L2 trick,仍然可以學出 velocity
給定一組 ,直接對 微分:
這個 reference velocity 可以直接算,所以和 U2.1 一樣,把 當輸入、 當 label:
把所有可產生的 reference velocities 當成學習目標
- 抽出時間 、端點 與獨立的 ,便能算出 。網路收到的是 。
- 是網路對這個時間、這個位置的速度預測。
- 剛才那組 決定了 。這是可以直接算出的 reference velocity。
- 把預測減去 reference velocity,再取平方長度,量出這一筆資料的速度誤差。
- 對時間、端點與額外的 取平均,也就是考慮這個抽樣方式下所有能產生的 label,參考所有的 reference velocities 作為學習目標。
固定 後,L2 regression 仍然會把所有可能經過這裡的 velocities 取平均,因此
這正是 U2 的 Flow Matching,現在只是 reference velocity 多了 。接下來省略星號,把這個 optimal velocity 記成 。
為什麼這個 velocity 真的會走過同一條 ?
這正是 U2.2 已經證過的結論。現在只要把決定 reference path 的 random variables 從 擴充成 ,仍然有
因此 與 仍然滿足
令 ,再沿著
前進, 的 marginal distribution 就會和 stochastic interpolant 的快照一樣,在每個時刻都是 ,最後抵達 。更嚴謹的 test-function 證明已經放在 U2.2 的補充中。
多出來的 Gaussian,讓任意端點也能拿到 score
既然訓練時的 也是已知的,我們也可以用另一個 L2 regression 來預測它:
給定 後,
所以只要 ,就可以沿用 U1.3 的 Tweedie 公式:
從已知的 Gaussian label 得到 score
- 我們已經看到時間 的位置 ;現在只考慮能產生這個觀察的可能來路。
- 每一種來路都帶著一個 ,表示它相對於 conditional Gaussian 中心的偏移。
- 把這些可能的 Gaussian labels,按它們在此處的 conditional distribution 取平均。
- 當 ,把平均的 乘上 ,就得到這個位置的 score。負號與尺度來自前面的 Gaussian score 推導。
- -regression 的最佳解正是 ,所以它可以直接代入同一條式子。
直覺上, 把每一條 conditional path 撐成一條有厚度的通道;預測「我在通道裡偏離中心多少」,也就告訴我們哪個方向的 density 比較高。
和 U2.3 的關係如果 已經是 Gaussian,velocity 不是本來就和 score 有關嗎?
沒錯。在 U2.3 中,、,所以原本的 Gaussian 起點就已經給出
而 optimal velocity 可以寫成
所以 U2.3 中 velocity 會和 score 連起來,是因為它們都可以從同一個 conditional mean 得到。
但現在我們允許 、 都是任意 distributions,端點不一定有 Gaussian 可以利用。加入獨立的 ,等於重新放入一個已知的 Gaussian direction,讓同一個 identity 變成
因此這不是另一個新的 trick,而是把 U2.3 用在 Gaussian 起點上的方法,推廣到任意兩個端點。若 本來就已經是 independent Gaussian,單純為了取得 score 並不需要再加入 ;此時 的主要作用是改變並平滑中間的 probability path。
不過在任意端點的情況下,從 得到 score,並不代表 score 就足以決定 velocity: 還同時平均了 與 的貢獻,所以一般仍要分別學 velocity 與 score。
展開細節Tweedie 公式在這裡怎麼套?
記 。在固定端點的 conditional Gaussian 中,,因此
再將 conditional score 對端點的 posterior 取平均:
和 U1.3 一樣,關鍵仍然是:除以 marginal 之後,積分裡的權重正好變成 posterior。
同一條 ,可以用 ODE 走,也可以用 SDE 走
現在 stochastic interpolant 同時給了我們
已經能用 ODE 推動 。若選定 ,我們可以先把 velocity 與 score 合成新的 drift:
這個 drift 不一定要先訓練兩支 networks 再相加。利用
可以直接得到
所以固定 後,只要讓一支 network 對 做 L2 regression:
這個 objective 的最佳解就是 。接著用它作為 SDE 的 drift:
在 U2.2 中,ODE 對應的 continuity equation 告訴我們 density 會怎麼改變。SDE 也有對應的 density evolution equation,稱為 Fokker–Planck equation:
補充Fokker–Planck equation 從哪裡來?
對任意 smooth test function ,Itô’s lemma 給出
把 expectation 寫成對 density 的積分,再做 integration by parts:
因為這對任意 都成立,括號裡就是 。和 U2.2 的 test-function 證明相比,多出來的 正是 Brownian motion 對 density 造成的擴散。
因為 ,多出來的兩項正好抵消:
剩下的仍是 continuity equation。也就是說,stochastic interpolant 先決定要經過哪些 marginals ;ODE 或 SDE 則決定每個樣本要用什麼方式去走過這些 marginals。 這就是 Flow 與 Diffusion 在這套架構裡真正共用的部分。
補充 也可以隨時間改變
上面先用常數 讓式子保持簡單。更一般地,可以選任意只隨時間改變的 :
因為 不依賴位置 ,Fokker–Planck equation 中仍然有
所以在 fields 精確、連續時間也精確求解時,任意 都會經過同一條 。它改變的是 trajectories,以及模型與 numerical errors 出現後,偏差會如何累積。
實作什麼時候才需要同時預測 velocity 與 score?
如果只使用一個固定 ,直接學 就夠了。若希望同一個模型可以切換 ODE、使用不同 的 SDE,或分別分析 velocity 與 score error,才需要同時取得 與 ;實作上可以共用一個 backbone,再接兩個 output heads。
一般不能只學 score,因為 score 只描述當下 density 的形狀,沒有決定整條 隨時間移動的方向。U1 的 diffusion model 是特例:forward dynamics 已知,而且 Gaussian endpoint 讓 velocity 可以由 score 換算,所以只訓練 score/noise prediction 就足夠。
Loss 變小,最後的 distribution 真的會比較接近嗎?
到這裡為止,我們都假設 與 學得完全正確。現在回到開頭真正想問的問題:當網路只有近似值時,training error 能不能控制最後的 distribution error?
答案是可以,但 ODE 與 SDE 自然對應到兩種不同的保證。
ODE:velocity error 控制
令 是沿著 learned velocity 解 ODE 得到的終點 distribution,並假設 是 -Lipschitz。定義整段路上的 velocity error
這正是 population Flow Matching loss 超過最佳值的部分。Benton、Deligiannidis 與 Doucet [4] 給出的 error bound 說,在這些條件下,
證明的想法很直接:讓正確 ODE 與 learned ODE 從同一個起點出發,分別得到 與 。兩人的距離滿足
用 Grönwall inequality 把每一刻的方向誤差累積起來,再平方取平均,就得到
而 本身就是 與 的一種 coupling; 會在所有 coupling 裡選搬運成本最小的那一個,所以只可能更小。這裡控制的是精確解 ODE 時的模型誤差;numerical solver 造成的離散誤差要另外計算。
SDE:drift error 直接控制 KL
現在把 exact velocity 與 score 換成網路的近似值,考慮
並把它的 marginal 記成 。令
對兩條 diffusion coefficient 相同、drift 不同的 Fokker–Planck equations,可以算出
其中 , 是兩條 SDE 的 drift 差。利用
再把 代入並積分,就得到
這條式子把 training 與 generation 接了起來:velocity 和 score 的 L2 errors 不只是容易算的 surrogate,它們真的會控制最後的 likelihood error。
注意為什麼 ODE 那邊不直接給 KL bound?
對 deterministic ODE 做相同計算時,不會出現 這個負項。因此小的 velocity MSE 一般不足以單獨控制 KL,還需要控制 與 之間的 Fisher divergence。
所以這裡不是「SDE 比 ODE 正確」:兩者在 exact fields 下都會得到同一條 。差別是 fields 不精確時,ODE 很自然地得到 stability;SDE 的 diffusion 則額外提供 KL/likelihood control。
這裡有兩個很容易混在一起的量: 放在 stochastic interpolant 裡,會改變中間的 與我們能學到的 target; 放在 sampling dynamics 裡,在 fields 精確時不改變 ,只改變每個樣本怎麼走。下面的 demo 先看 做了什麼; 對 finite-step sampling 的影響,則留到實作課再量。
在 demo 中,起點與終點都是同一個環。選擇對徑配對並把 設成 0,中間的所有 reference paths 會同時通過圓心, 時整個 distribution 甚至會塌成一個點。提高 後,中間會重新出現厚度;但這也改變了整條 marginal path,而不只是替 sampling 隨手加一點 noise。
那是不是一律把 設成正的就好?
課堂提問Q1
可以讓中間 distribution 有厚度,又能讓我們學到 score。那為什麼不永遠都加入這項 randomness?
先想一想,再展開看整理後的答案
因為它解決的是「怎麼得到平滑 density 與 score」,不是「怎麼讓 ODE trajectory 變直」。
提供平滑的 conditional density,讓 score 可以透過 regression 得到;但它也會改變中間的 與 reference velocities。不同通道互相重疊後, 仍要平均多個方向,ODE trajectories 不一定會因此變直。
如果我們只需要 velocity, 完全可以訓練。U2 的 Flow Matching 就是這個情況;而當 本身是獨立 Gaussian 時,還可以像 U2.3 那樣從 的 conditional mean 換算 score。失去的是上面這個對任意起點與任意 coupling 都成立的 -regression 公式。
所以後面的問題要分開處理:U3 會先研究 reference paths 交叉後產生的彎曲,接著用 reflow 與 minibatch OT 改善 coupling;U3.5 再實際比較 改變時,誤差修正能力與 numerical cost 如何取捨。
快速回顧一下
參考文獻
- Albergo, M. S., Boffi, N. M., Vanden-Eijnden, E. Stochastic Interpolants: A Unifying Framework for Flows and Diffusions. 2023.
- Albergo, M. S., Vanden-Eijnden, E. Building Normalizing Flows with Stochastic Interpolants. ICLR 2023.
- Ma, N., Goldstein, M., Albergo, M. S., Boffi, N. M., Vanden-Eijnden, E., Xie, S. SiT: Exploring Flow and Diffusion-Based Generative Models with Scalable Interpolant Transformers. 2024.
- Benton, J., Deligiannidis, G., Doucet, A. Error Bounds for Flow Matching Methods. TMLR 2024.(以 velocity 的 L2 approximation error 與 Lipschitz constant 控制 deterministic Flow Matching 的 error。)
- Gao, Y., Huang, J., Jiao, Y. Gaussian Interpolation Flows. JMLR 2024.(證明 Gaussian interpolation velocity 的 Lipschitz regularity、flow 的存在唯一性,以及 stability。)
- Reu, T., Dromigny, S., Bronstein, M., Vargas, F. Gradient Variance Reveals Failure Modes in Flow-Based Generative Models. NeurIPS 2025.(deterministic straight-path training 的 memorization 結果;noise 改善 generalization 的部分為實驗觀察。)
- Su, S., Zhang, Y., Zhou, L., Ranganath, R., Yeung-Levy, S. Three Forms of Stochastic Injection for Improved Distribution-to-Distribution Generative Modeling. arXiv preprint, 2025.(分析 stochastic interpolant 如何增加有限資料下的 supervision coverage,並提供 與 image-to-image experiments。)
- Bertrand, Q., Gagneux, A., Massias, M., Emonet, R. On the Closed-Form of Flow Matching: Generalization Does Not Arise from Target Stochasticity. NeurIPS 2025.(區分 noisy regression target 與 interpolant randomness,避免把不同來源的 stochasticity 混為一談。)