
U1.5 實作:建立這個單元的 Toy
本篇重用9 篇
先在淺水區把每件事看清楚
這個單元的理論講完了,但還沒有一行程式跑過。接下來要做的,是把整個單元的東西縮成一個幾秒就能重跑的小實驗。
之後三個單元的理論都要對回同一組實驗,所以這個 toy 值得認真建。選 2D 有三個很實際的好處:
- 有標準答案。 資料點是有限的,所以 就是一個混合 Gaussian——真實的 、score、後驗均值全部可以精確算出來。網路學得好不好不用猜,可以直接比。
- 看得見。 軌跡、向量場都能直接畫在平面上,不必靠指標想像。
- 跑得快。 訓練幾秒鐘結束,改一行就能重跑;想試一個念頭不用等半天。
設定:資料是兩個月牙(sklearn.datasets.make_moons,,噪聲 0.05),標準化到零均值單位變異數。網路是三層 MLP、寬 128,輸入 , 用 sinusoidal embedding。,linear schedule 。
下載 Week 3:Gaussian diffusion 與解析 score notebook(.ipynb)
Notebook 內容。 用可解析的 2D Gaussian mixture 實作 forward noising、精確 score 與 Tweedie posterior mean;內含固定 seed、三組可重跑視覺化與改變 mixture 重疊程度的 TODO。這是解析 toy,不依賴任何 checkpoint。
步驟 1:forward 與訓練
def q_sample(x0, t, eps):                 # forward process 的 closed form
    ab = alpha_bar[t][:, None]
    return ab.sqrt() * x0 + (1 - ab).sqrt() * eps

for step in range(n_steps):               # denoising 回歸的五行
    x0  = sample_data(batch)
    t   = torch.randint(1, T + 1, (batch,))
    eps = torch.randn_like(x0)
    xt  = q_sample(x0, t, eps)
    loss = ((model(xt, t) - eps) ** 2).mean()
    loss.backward(); opt.step(); opt.zero_grad()
跑起來之後,loss 會在幾百步內從 ~1 掉到 0.3 附近,然後就停在那裡不動了。
loss 停住、而且離 0 很遠,
是哪裡寫錯了嗎?
課堂提問Q1
一般的回歸任務,我們會期待 loss 一路往 0 掉。所以看到它停在 0.3,直覺的下一步是:把網路加寬、學習率調一調、多訓十倍步數。
這樣做 loss 會掉下去嗎?
先想一想,再展開看整理後的答案
不會,而且一點都不會——那個 0.3 不是訓練不夠,是理論算得出來的地板。
U1.3 已經把這條寫出來了: 的最佳解是 ,不是訓練時抽到的那一個 ,所以即使訓到最佳,loss 也只會停在條件變異數上:
加寬網路只會讓你更快走到這條地板,不會穿過它。而且這個下界隨 變,兩端剛好相反:
- 很小: 幾乎就是 。看到 等於看到原圖——但那不會告訴你當初抽到的是哪一個 ,因為它的貢獻被 壓到幾乎看不見。條件變異數接近 1,loss 下界接近 1。
- 很大: 幾乎就是 本身, 幾乎可以直接讀出來。條件變異數接近 0,loss 下界接近 0。
是 Gaussian 時這個下界算得出精確值:。所以那條曲線就是 本身,而把所有 平均起來就是那個停住的非零數字——DDPM 的 linear schedule 下 。
該看的不是 loss 停在多少,而是它隨 長什麼形狀。
實作建議: 把 loss 依 分箱畫出來(例如每 100 個 一箱),你會看到一條從 ~1 掉到 ~0 的曲線。這條曲線比單一個平均 loss 有用得多——它讓你看得出模型是在哪一段 沒學好。
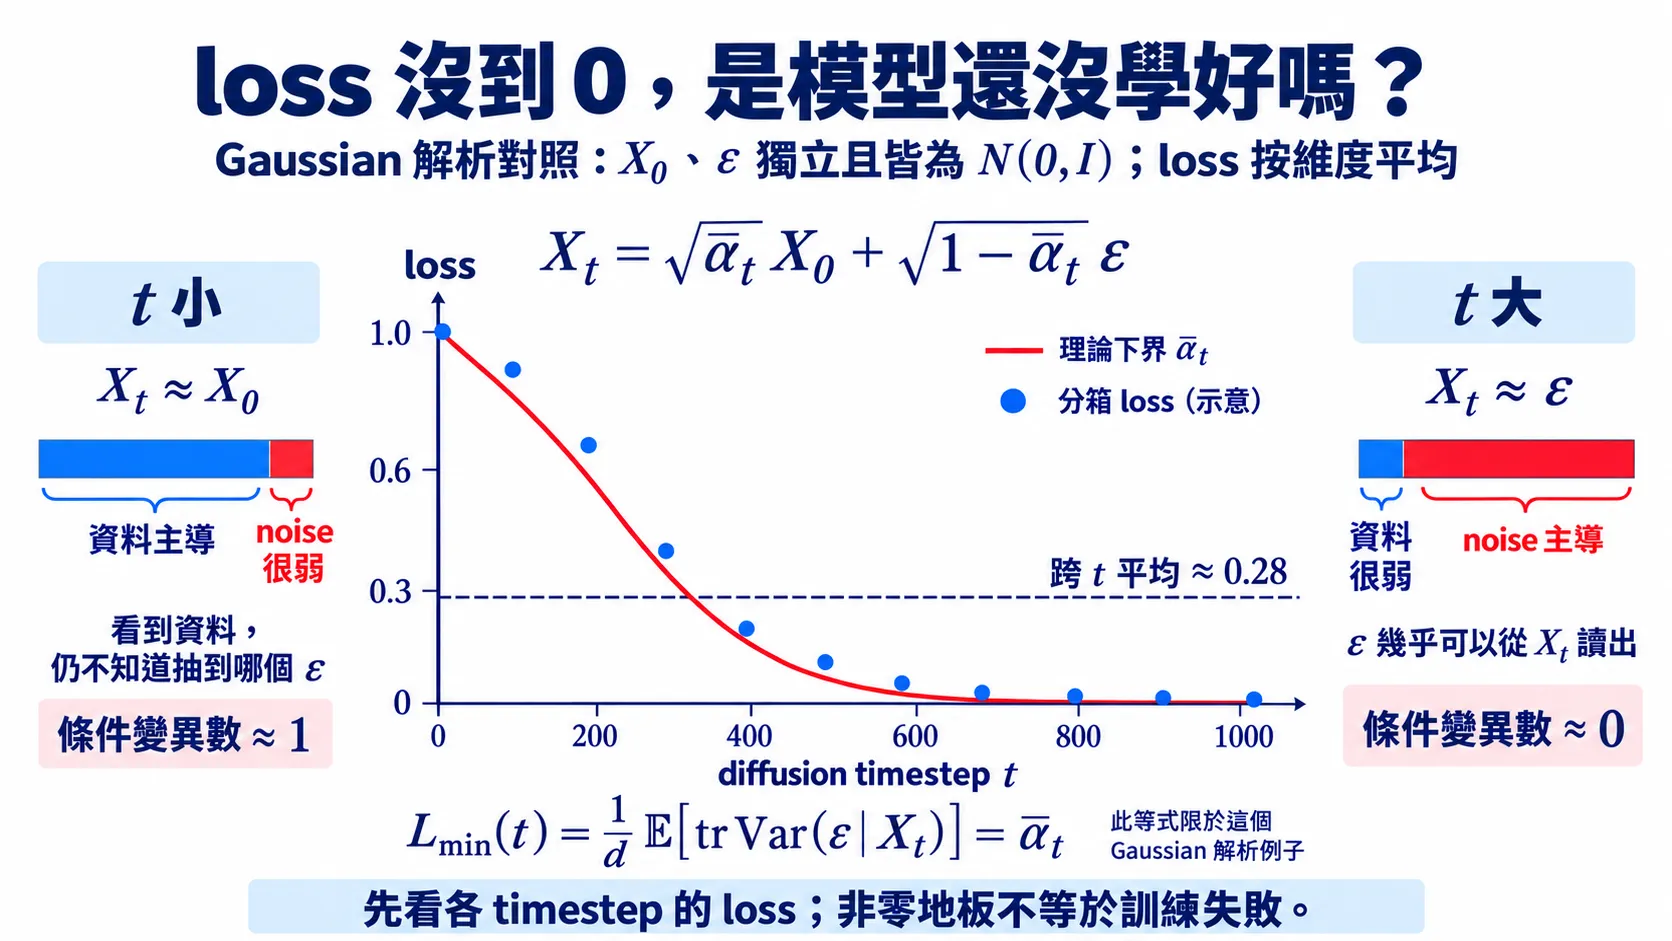
圖:loss 的下界隨 下降。 這張圖用互相獨立的 作解析對照;loss 按維度平均時,紅線為 ,藍點只是分箱 loss 的示意,不是 notebook 的實測值。虛線 是跨 timestep 的平均,不是每個 都有同一條地板。兩個月牙 toy 的下界仍由 posterior uncertainty 決定,不能直接套用這個 Gaussian 例子的 。
步驟 2:畫 score field(圖 a)
在 的網格上,對 各畫一張,每張疊兩組箭頭:
- 模型:
- 真值:
exact_score(x, t)
會看到的事情: 大時箭頭整片指向原點, 小時箭頭指向月牙——跟 U1.3 的 demo 一樣。而模型與真值在資料密集的地方吻合,在遠離資料的角落偏差變大,因為那裡幾乎沒有訓練樣本落過。
這個偏差不是無害的,步驟 4 會看到它的後果。
步驟 3:三種 parametrization 真的等價嗎?(圖 b)
不重訓。取一批 ,只從 換算:
同一個 noise predictor,怎麼換成另兩種輸出?
- 先拿同一批 ,不改模型,也不重新訓練。
- 模型已經給出 ,先扣掉它在 中對應的 。
- 再除以信號係數 ,就得到 。
- 把同一份 與剛算出的 組合成 ,仍然不用重訓。
先做一件一行就能做完的事:從 和 反解回 ,確認它和原本的 只差在浮點誤差()之內。三種寫法真的是同一個東西,這一步就是 U1.2 說的「親手驗證一次」。
驗完之後再拿 跟 exact_posterior_mean 比對,畫出「 的誤差對 」的曲線。
會看到的事情: 大時誤差被放大——因為換算要除以趨近 0 的 。U1.2 說三種 parametrization 在數學上等價,這條曲線就是它們在數值上不等價的地方;而 之所以在兩端都不退化,正是因為它不需要做這種除以趨近 0 的係數的換算。
步驟 4:DDPM 與 DDIM 軌跡(圖 c)
下面分別沿用 Ho、Jain 與 Abbeel 的 DDPM [1],以及 Song、Meng 與 Ermon 的 DDIM [2],只把它們放進同一支函數裡比較。
def ddim_step(xt, t, s, eta=0.0):
    eps = model(xt, t)
    x0_hat = (xt - sig[t] * eps) / ab[t].sqrt()
    sigma_s = eta * ((1 - ab[s]) / (1 - ab[t]) * (1 - ab[t] / ab[s])).sqrt()
    dir_xt = (1 - ab[s] - sigma_s**2).sqrt() * eps
return ab[s].sqrt() * x0_hat + dir_xt + sigma_s * torch.randn_like(xt)是 DDIM, 是 DDPM——一支函數就夠,這正是 U1.4 那條一般式。固定 32 個起點 ,對步數 各跑一次,把完整軌跡畫出來。
會看到的事情:DDIM 10 步的軌跡是彎的,而且終點常常落在月牙外側;1000 步時終點幾乎收在同一組位置,但路徑仍然是彎的。這張圖要留好,U2 開頭會直接用它。
補充這裡和課文 demo 的差別:現在的 score 有誤差了
U1.4 的互動 demo 用的是精確的 score,所以看不到「網路不準」造成的效果。這裡你手上是一個真的訓出來的網路——它在低密度區會不準(步驟 2 看到的),於是取樣時如果軌跡跑到那些地方,誤差會被進一步放大。
這也是為什麼作業 3 值得做:帶噪聲的取樣器()有機會把偏離的樣本拉回當下的 ,而這件事只有在 score 有誤差時才看得出好處。
用精確的 score 看不到加噪聲的好處——那個好處是拿來對付網路誤差的。
作業
- Parametrization 等價。 分別以 -、-、-prediction 訓練三個網路,換算成 之後比較 DDIM 50 步終點的 (Wasserstein-2 距離,兩堆樣本之間的距離)。它們應該接近但不相同——說明差異來自 U1.2 的哪一節。
- 加權。 以 -prediction 訓練,但把 loss 乘上 。比較 score field 在 小與 大時的誤差分布,跟均勻加權的版本有什麼不同。
- 把 U1.4 的判準做成定量版。 對步數 ,畫 DDPM()與 DDIM()終點的 曲線。先寫下你的猜測再跑。 這個 toy 的 score 是精確算出來的,所以照 U1.4 的判準,你應該預期確定性那一端不太會輸;如果你量到相反的結果,先去檢查是不是 score 不夠精確。
- (選)Anderson 反向 SDE。 讀 Anderson 1982 [3] 第 2 節,說明 reverse SDE 的 score 項是從哪一個條件期望冒出來的,並指出它與 U1.3 的 Tweedie 公式是什麼關係。
消化一下
參考文獻
- Ho, J., Jain, A., Abbeel, P. Denoising Diffusion Probabilistic Models. NeurIPS 2020.
- Song, J., Meng, C., Ermon, S. Denoising Diffusion Implicit Models. ICLR 2021. (步驟 4 的
ddim_step一般式。) - Anderson, B. D. O. Reverse-time diffusion equation models. Stochastic Processes and their Applications, 1982. (作業 4。)