學完這篇,你能
DDPM 的 L simple \mathcal L_{\text{simple}} L simple 固定 t t t E [ ϵ ∣ x t ] \mathbb E[\epsilon\mid x_t] E [ ϵ ∣ x t ] E [ ϵ ∣ x t ] = − σ t ∇ log p t ( x t ) \mathbb E[\epsilon\mid x_t]=-\sigma_t\nabla\log p_t(x_t) E [ ϵ ∣ x t ] = − σ t ∇ log p t ( x t ) p t p_t p t 為什麼 score 是一個很好用的建模對象? 對 log p t ( x ) \log p_t(x) log p t ( x )
本篇重用 7 篇 那個 simple MSE,到底在學什麼?
上一篇不管是走逐步的 KL,還是走 DDPM 原文的 ELBO,我們得到的都是一個有理論依據的 weighted MSE 。但真正拿來訓練的時候,DDPM 做了一件很重要的修改:它把不同 timestep 的加權拿掉了,直接用
L simple ( θ ) = E t , x 0 , ϵ [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] . \mathcal L_{\text{simple}}(\theta)=\mathbb E_{t,\,x_0,\,\epsilon}\big[\|\epsilon_\theta(x_t,t)-\epsilon\|^2\big]. L simple ( θ ) = E t , x 0 , ϵ [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] . 所以到這裡留下了一個問題:ELBO 解釋的是原本那個 weighted objective;那我們現在真的拿來 train 的 simple MSE,到底在學什麼?
而且這個問題比它看起來更根本。我們從頭到尾都只是在看 ( x 0 , x t ) (x_0,x_t) ( x 0 , x t ) ( ϵ , x t ) (\epsilon,x_t) ( ϵ , x t ) p data p_{\text{data}} p data
一個看起來只是做 denoising regression 的 neural network,
要回答這件事,我們先不看整條 reverse process,只固定一個 noise level t t t
固定一個 t t t
把 L simple \mathcal L_{\text{simple}} L simple
L simple ( θ ) = E t E x 0 , ϵ [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] ⏟ 每一個 t 自己的一項 , x t = α ˉ t x 0 + σ t ϵ . \mathcal L_{\text{simple}}(\theta)=\mathbb E_{t}\ \underbrace{\mathbb E_{x_0,\,\epsilon}\Big[\big\|\epsilon_\theta(x_t,t)-\epsilon\big\|^2\Big]}_{\text{每一個 }t\text{ 自己的一項}},
\qquad x_t=\sqrt{\bar\alpha_t}\,x_0+\sigma_t\epsilon . L simple ( θ ) = E t 每一個 t 自己的一項 E x 0 , ϵ [ ϵ θ ( x t , t ) − ϵ 2 ] , x t = α ˉ t x 0 + σ t ϵ . 它其實是一堆互不干擾 的小問題疊起來:ϵ θ ( ⋅ , t ) \epsilon_\theta(\cdot,t) ϵ θ ( ⋅ , t ) t t t t t t t t t
加權那件事也因此可以先放下。 帶加權的版本只是在每一項前面乘一個與 ϵ θ \epsilon_\theta ϵ θ w ( t ) w(t) w ( t ) t t t
固定一個 t t t min ϵ θ E [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] \min_{\epsilon_\theta}\mathbb E\big[\|\epsilon_\theta(x_t,t)-\epsilon\|^2\big] min ϵ θ E [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ]
而這種 MSE 的 loss 有一個已知的最佳解公式。對任何一對隨機變數 ( X , Y ) (X,Y) ( X , Y )
arg min f E ( X , Y ) [ ∥ f ( X ) − Y ∥ 2 ] ⏟ 對聯合分布取 = E [ Y ∣ X ] ⏟ 對給定 X 的條件分布取 . \arg\min_f\ \underbrace{\mathbb E_{(X,Y)}\big[\|f(X)-Y\|^2\big]}_{\text{對聯合分布取}}
\;=\;\underbrace{\mathbb E[Y\mid X]}_{\text{對給定 }X\text{ 的條件分布取}} . arg f min 對聯合分布取 E ( X , Y ) [ ∥ f ( X ) − Y ∥ 2 ] = 對給定 X 的條件分布取 E [ Y ∣ X ] . 這個公式有一個很直覺的畫面。想像你要在一條街上開一家店,明天顧客會出現在哪裡你不知道,只知道他們大致的分布;而「不方便」的代價是顧客走到店裡的距離平方 。最好的位置在哪?不是人最多的那一點,而是所有顧客位置的平均 ——平方的代價會讓遠處的人拉得特別用力,於是你被迫站到重心上。f ( X ) f(X) f ( X ) Y Y Y X X X X X X
兩個期望值取的對象不一樣:左邊對 ( X , Y ) (X,Y) ( X , Y ) 聯合分布 取,得到一個數值;右邊對「給定 X X X Y Y Y 條件分布 」取,得到一個隨給定的 X X X f ( X ) f(X) f ( X ) Y Y Y E [ Y ∣ X ] + ( Y − E [ Y ∣ X ] ) \mathbb E[Y\mid X]+\big(Y-\mathbb E[Y\mid X]\big) E [ Y ∣ X ] + ( Y − E [ Y ∣ X ] ) M1.2 )。
套回 DDPM:X X X x t x_t x t Y Y Y ϵ \epsilon ϵ x 0 x_0 x 0 ϵ \epsilon ϵ x t x_t x t 理想上,模型夠強、訓練到收斂的話 ,
也就是說,模型不是在記住「這個 x t x_t x t ϵ \epsilon ϵ 看到這個 x t x_t x t ϵ \epsilon ϵ
x 0 x_0 x 0 x t = α ˉ t x 0 + σ t ϵ x_t=\sqrt{\bar\alpha_t}x_0+\sigma_t\epsilon x t = α ˉ t x 0 + σ t ϵ x 0 x_0 x 0 ϵ \epsilon ϵ
E [ x 0 ∣ x t ] = x t − σ t E [ ϵ ∣ x t ] α ˉ t . \mathbb E[x_0\mid x_t]=\frac{x_t-\sigma_t\,\mathbb E[\epsilon\mid x_t]}{\sqrt{\bar\alpha_t}} . E [ x 0 ∣ x t ] = α ˉ t x t − σ t E [ ϵ ∣ x t ] . 這就是上一篇「散布是 schedule 給的,中心由 E [ x 0 ∣ x t ] \mathbb E[x_0\mid x_t] E [ x 0 ∣ x t ] L simple \mathcal L_{\text{simple}} L simple
到這裡事情就開始有點不一樣了。因為這個 posterior p ( x 0 ∣ x t ) p(x_0\mid x_t) p ( x 0 ∣ x t ) 所有 可能的 x 0 x_0 x 0
補充 順帶一提:這也解釋了 loss 為什麼停在一個非零值 同一個分解還告訴我們 loss 會停在哪裡。把 E ∥ f ( X ) − Y ∥ 2 \mathbb E\|f(X)-Y\|^2 E ∥ f ( X ) − Y ∥ 2
min θ E [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] = E t , x t [ tr Var ( ϵ ∣ x t ) ] . \min_\theta\ \mathbb E\big[\|\epsilon_\theta(x_t,t)-\epsilon\|^2\big]
=\mathbb E_{t,\,x_t}\big[\operatorname{tr}\operatorname{Var}(\epsilon\mid x_t)\big]. θ min E [ ∥ ϵ θ ( x t , t ) − ϵ ∥ 2 ] = E t , x t [ tr Var ( ϵ ∣ x t ) ] . 所以 loss 不會到 0 ,而且它停住的高度是有意義的——那是「看到 x t x_t x t ϵ \epsilon ϵ U1.5 會把這條線實際畫出來。
另外,這一整段是 U1.2 那個 conditional trick 的 MSE 版本 :那裡我們證的是 KL 版(把 x 0 x_0 x 0 θ \theta θ
這個 posterior mean 跟整個分布有什麼關係?
我們猜測 posterior mean E [ ϵ ∣ x t ] \mathbb E[\epsilon\mid x_t] E [ ϵ ∣ x t ] t t t x t x_t x t x t x_t x t p t p_t p t
p t ( x t ) = ∫ q ( x t ∣ x 0 ) p data ( x 0 ) d x 0 , p_t(x_t)=\int q(x_t\mid x_0)\,p_{\text{data}}(x_0)\,\mathrm dx_0 , p t ( x t ) = ∫ q ( x t ∣ x 0 ) p data ( x 0 ) d x 0 , 這個分布也是 U1.2 裡第一次使用 Bayes 時分母的那個 p t ( x t ) p_t(x_t) p t ( x t )
於是我們可以把猜測的問題問得更精確一點:
E [ ϵ ∣ x t ] \mathbb E[\epsilon\mid x_t] E [ ϵ ∣ x t ] p t ( x t ) p_t(x_t) p t ( x t )
Tweedie 公式:對 x t x_t x t
固定一個 t t t q ( x t ∣ x 0 ) q(x_t\mid x_0) q ( x t ∣ x 0 ) p t p_t p t
p t ( x t ) = ∫ N ( x t ; α ˉ t x 0 , σ t 2 I ) p data ( x 0 ) d x 0 . p_t(x_t)=\int \mathcal N\!\big(x_t;\,\sqrt{\bar\alpha_t}\,x_0,\ \sigma_t^2 I\big)\,p_{\text{data}}(x_0)\,\mathrm dx_0 . p t ( x t ) = ∫ N ( x t ; α ˉ t x 0 , σ t 2 I ) p data ( x 0 ) d x 0 . 我們試著對 x t x_t x t (梯度可以穿到積分裡面是有條件的),其中積分裡只有代表 q ( x t ∣ x 0 ) q(x_t\mid x_0) q ( x t ∣ x 0 )
∇ x t p t ( x t ) = ∫ ∇ x t N ( x t ; α ˉ t x 0 , σ t 2 I ) p data ( x 0 ) d x 0 = ∫ − x t − α ˉ t x 0 σ t 2 N ( x t ; α ˉ t x 0 , σ t 2 I ) p data ( x 0 ) d x 0 . \begin{aligned}
\nabla_{x_t} p_t(x_t)
&=\int \nabla_{x_t}\mathcal N\!\big(x_t;\,\sqrt{\bar\alpha_t}\,x_0,\ \sigma_t^2I\big)\,p_{\text{data}}(x_0)\,\mathrm dx_0\\
&=\int -\frac{x_t-\sqrt{\bar\alpha_t}\,x_0}{\sigma_t^2}\,\mathcal N\!\big(x_t;\,\sqrt{\bar\alpha_t}\,x_0,\ \sigma_t^2I\big)\,p_{\text{data}}(x_0)\,\mathrm dx_0 .
\end{aligned} ∇ x t p t ( x t ) = ∫ ∇ x t N ( x t ; α ˉ t x 0 , σ t 2 I ) p data ( x 0 ) d x 0 = ∫ − σ t 2 x t − α ˉ t x 0 N ( x t ; α ˉ t x 0 , σ t 2 I ) p data ( x 0 ) d x 0 . 接著兩邊除以 p t ( x t ) p_t(x_t) p t ( x t ) ∇ x t p t ( x t ) / p t ( x t ) = ∇ x t log p t ( x t ) \nabla_{x_t}p_t(x_t)\big/p_t(x_t)=\nabla_{x_t}\log p_t(x_t) ∇ x t p t ( x t ) / p t ( x t ) = ∇ x t log p t ( x t ) 正好就是後驗 p ( x 0 ∣ x t ) p(x_0\mid x_t) p ( x 0 ∣ x t ) M1.3 ):
N ( x t ; α ˉ t x 0 , σ t 2 I ) p data ( x 0 ) p t ( x t ) = q ( x t ∣ x 0 ) p data ( x 0 ) p t ( x t ) = p ( x 0 ∣ x t ) . \frac{\mathcal N\!\big(x_t;\,\sqrt{\bar\alpha_t}\,x_0,\ \sigma_t^2I\big)\,p_{\text{data}}(x_0)}{p_t(x_t)}
=\frac{q(x_t\mid x_0)\,p_{\text{data}}(x_0)}{p_t(x_t)}
=p(x_0\mid x_t). p t ( x t ) N ( x t ; α ˉ t x 0 , σ t 2 I ) p data ( x 0 ) = p t ( x t ) q ( x t ∣ x 0 ) p data ( x 0 ) = p ( x 0 ∣ x t ) . 因此我們得到:
∇ x t log p t ( x t ) = ∫ − x t − α ˉ t x 0 σ t 2 p ( x 0 ∣ x t ) d x 0 . \nabla_{x_t}\log p_t(x_t)
=\int -\frac{x_t-\sqrt{\bar\alpha_t}\,x_0}{\sigma_t^2}\,p(x_0\mid x_t)\,\mathrm dx_0 . ∇ x t log p t ( x t ) = ∫ − σ t 2 x t − α ˉ t x 0 p ( x 0 ∣ x t ) d x 0 . 被積函數裡那一塊看起來有點眼熟。把 forward 那一行 x t = α ˉ t x 0 + σ t ϵ x_t=\sqrt{\bar\alpha_t}x_0+\sigma_t\epsilon x t = α ˉ t x 0 + σ t ϵ
x t − α ˉ t x 0 σ t = ϵ , \frac{x_t-\sqrt{\bar\alpha_t}\,x_0}{\sigma_t}=\epsilon , σ t x t − α ˉ t x 0 = ϵ , 也就是「造出這個 x t x_t x t − ϵ / σ t -\epsilon/\sigma_t − ϵ / σ t p ( x 0 ∣ x t ) p(x_0\mid x_t) p ( x 0 ∣ x t ) ϵ \epsilon ϵ
右邊冒出來的,正是上一節那個 posterior mean。換成 x 0 x_0 x 0
E [ x 0 ∣ x t ] = x t + σ t 2 ∇ log p t ( x t ) α ˉ t , \mathbb E[x_0\mid x_t]=\frac{x_t+\sigma_t^2\,\nabla\log p_t(x_t)}{\sqrt{\bar\alpha_t}} , E [ x 0 ∣ x t ] = α ˉ t x t + σ t 2 ∇ log p t ( x t ) , 兩式只差 E [ x 0 ∣ x t ] \mathbb E[x_0\mid x_t] E [ x 0 ∣ x t ] E [ ϵ ∣ x t ] \mathbb E[\epsilon\mid x_t] E [ ϵ ∣ x t ] E [ ϵ ∣ x t ] \mathbb E[\epsilon\mid x_t] E [ ϵ ∣ x t ]
s θ ( x t , t ) : = − ϵ θ ( x t , t ) σ t ≈ ∇ log p t ( x t ) . s_\theta(x_t,t):=-\frac{\epsilon_\theta(x_t,t)}{\sigma_t}\;\approx\;\nabla\log p_t(x_t). s θ ( x t , t ) := − σ t ϵ θ ( x t , t ) ≈ ∇ log p t ( x t ) . 這個量有一個名字。所以開頭那個問題有答案了——
訓好的 denoiser 就是 p t p_t p t ∇ x t log p t ( x t ) \nabla_{x_t}\log p_t(x_t) ∇ x t log p t ( x t )
這個把 noisy observation 的 posterior mean 與 marginal score 連起來的關係,就是 Tweedie formula ;這裡的寫法可以對照 Efron [1] 的整理。
原來 denoiser 學到的是 p t p_t p t
把 Tweedie 乘開來讀:− E [ ϵ ∣ x t ] = σ t ∇ log p t ( x t ) -\mathbb E[\epsilon\mid x_t]=\sigma_t\nabla\log p_t(x_t) − E [ ϵ ∣ x t ] = σ t ∇ log p t ( x t ) x 0 x_0 x 0
α ˉ t E [ x 0 ∣ x t ] − x t ⏟ denoising 的方向 = σ t 2 ∇ log p t ( x t ) . \underbrace{\sqrt{\bar\alpha_t}\,\mathbb E[x_0\mid x_t]-x_t}_{\text{denoising 的方向}}=\sigma_t^2\,\nabla\log p_t(x_t). denoising 的方向 α ˉ t E [ x 0 ∣ x t ] − x t = σ t 2 ∇ log p t ( x t ) . 兩邊同向,只差一個 σ t 2 \sigma_t^2 σ t 2
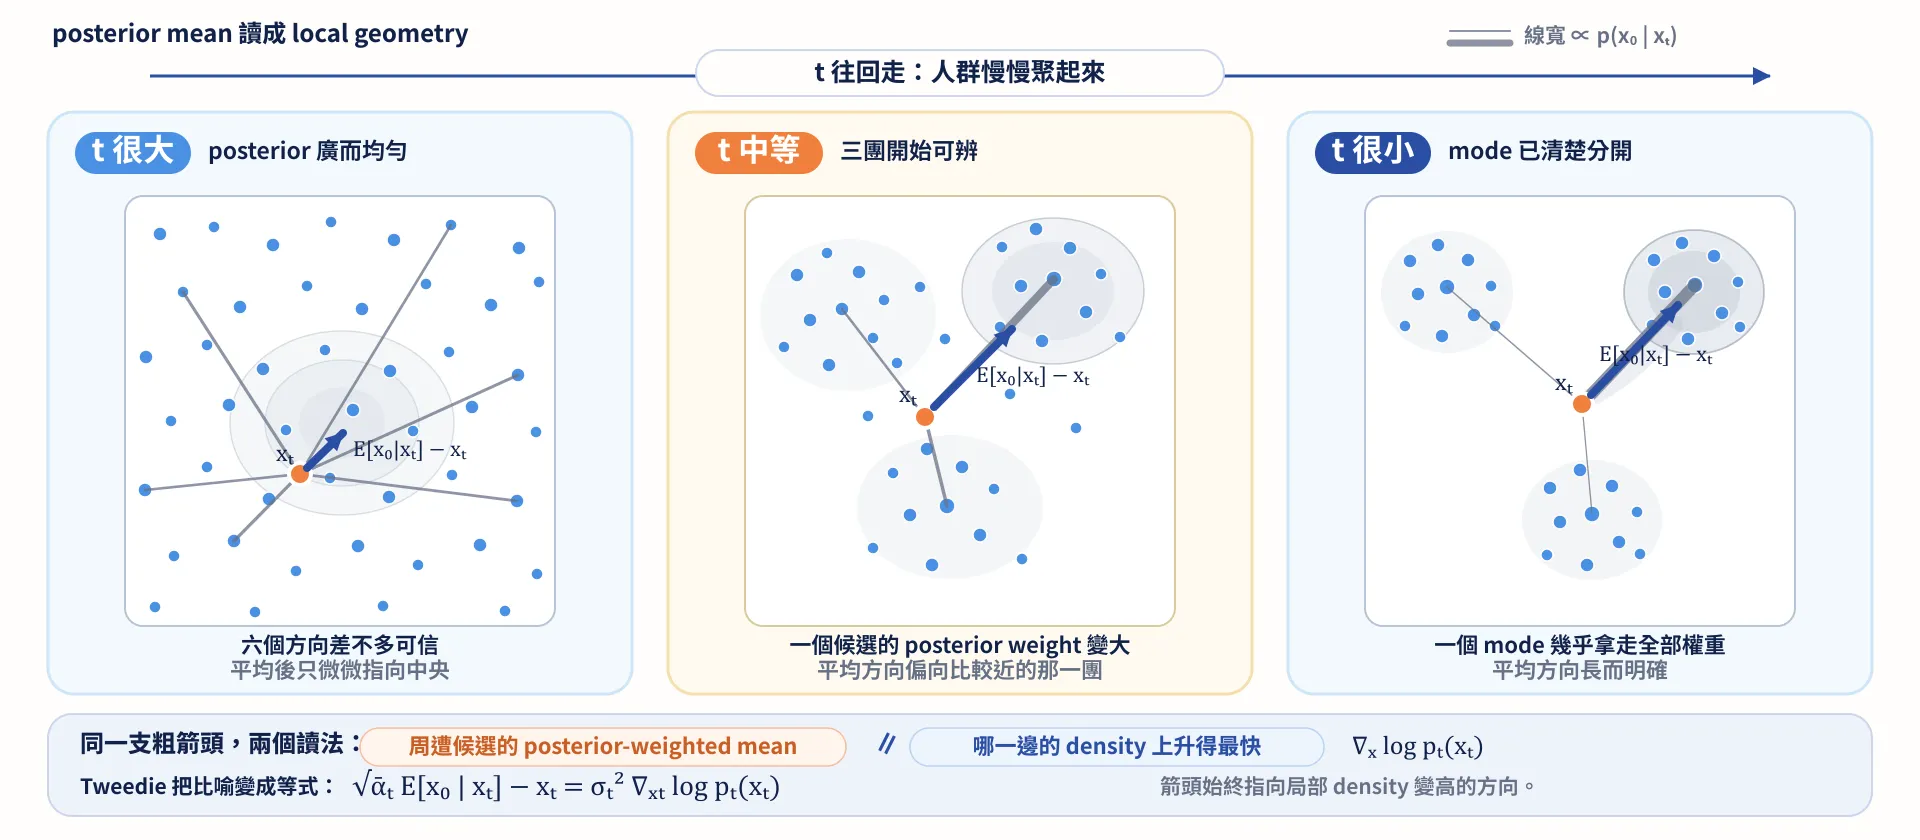
想像演唱會結束,人群從會場往四面八方散開。t t t t t t
現在你站在某個街口 x t x_t x t 所有可能走到這裡的人從哪裡來,再取平均的回頭方向 。這個 posterior average 就是 E [ x 0 ∣ x t ] \mathbb E[x_0\mid x_t] E [ x 0 ∣ x t ] α ˉ t \sqrt{\bar\alpha_t} α ˉ t x t x_t x t
Tweedie formula 說,這個「平均回頭方向」正好就是附近人群變密最快的方向,也就是 score。Denoiser 看似只是在猜一筆資料被 noise 推開了多少,最後卻從所有可能走到這裡的例子中,學會了每個時間、每個街口應該往哪裡回頭 。
但這支箭頭還不是一條完整路線。它只回答當下該往哪個方向;一步走多遠、到了下一個街口如何更新、途中要不要加入隨機,是下一篇 reverse dynamics 才要回答的問題。
圖:灰線代表可能的來路,線寬是 posterior weight;靛色粗箭頭是平均的回頭方向 α ˉ t E [ x 0 ∣ x t ] − x t \sqrt{\bar\alpha_t}\mathbb E[x_0\mid x_t]-x_t α ˉ t E [ x 0 ∣ x t ] − x t
不過「知道哪裡是回頭方向」還只是一個開始。一步要跨多大?要不要帶一點隨機?反覆照這個方向走,最後真的會回到原本的分布嗎?
為什麼學 score,而不是直接學 density?
既然我們最後拿到的是 ∇ log p t ( x t ) \nabla\log p_t(x_t) ∇ log p t ( x t ) p t p_t p t
課堂提問 Q1
最直接的做法看起來很清楚:訓一個網路去表示 p t p_t p t
這條路會走到哪裡去?
先想一想,再展開看整理後的答案 會走回 U1.0 那面牆。
要讓一個網路輸出的東西是機率密度 ,它就得積分為 1,也就是得除以一個 normalizing constant Z θ Z_\theta Z θ ∇ θ log Z θ = E x ′ ∼ p θ [ ∇ θ E θ ( x ′ ) ] \nabla_\theta\log Z_\theta=\mathbb E_{x'\sim p_\theta}[\nabla_\theta E_\theta(x')] ∇ θ log Z θ = E x ′ ∼ p θ [ ∇ θ E θ ( x ′ )] p θ p_\theta p θ 我們想做的事,變成做這件事的前提。
而 score 完全不碰這面牆。把密度寫成 p θ ( x ) = p ~ θ ( x ) / Z θ p_\theta(x)=\tilde p_\theta(x)/Z_\theta p θ ( x ) = p ~ θ ( x ) / Z θ x x x
∇ x log p θ ( x ) = ∇ x log p ~ θ ( x ) − ∇ x log Z θ ⏟ = 0 , \nabla_x\log p_\theta(x)=\nabla_x\log\tilde p_\theta(x)-\underbrace{\nabla_x\log Z_\theta}_{=\,0}, ∇ x log p θ ( x ) = ∇ x log p ~ θ ( x ) − = 0 ∇ x log Z θ , 因為 Z θ Z_\theta Z θ x x x score 對 normalizing constant 免疫。
所以 Tweedie 公式真正的意義不只是「denoiser 和 score 相等」,而是:我們要的那個量,剛好是那面牆管不到的量 ,而且有一支五行的回歸程式可以拿到它。這個繞過 normalizing constant 的建模方向,從 Hyvärinen 的 score matching [2] 開始;Song 與 Ermon [3] 再把 score 作為生成模型的學習對象。
注意 「繞過」和「解決」不一樣 不要把上面那件事讀成「Z Z Z 沒有去表示 p θ p_\theta p θ ,只表示它的坡度——所以也就沒有辦法回頭問「這張圖的機率是多少」。我們沒有解出 density estimation,我們繞過了它。 代價是拿不到 density 與 likelihood,換到的是可以直接學到生成真正需要的那個局部幾何。U2 比較兩個框架時會再回到這個取捨。
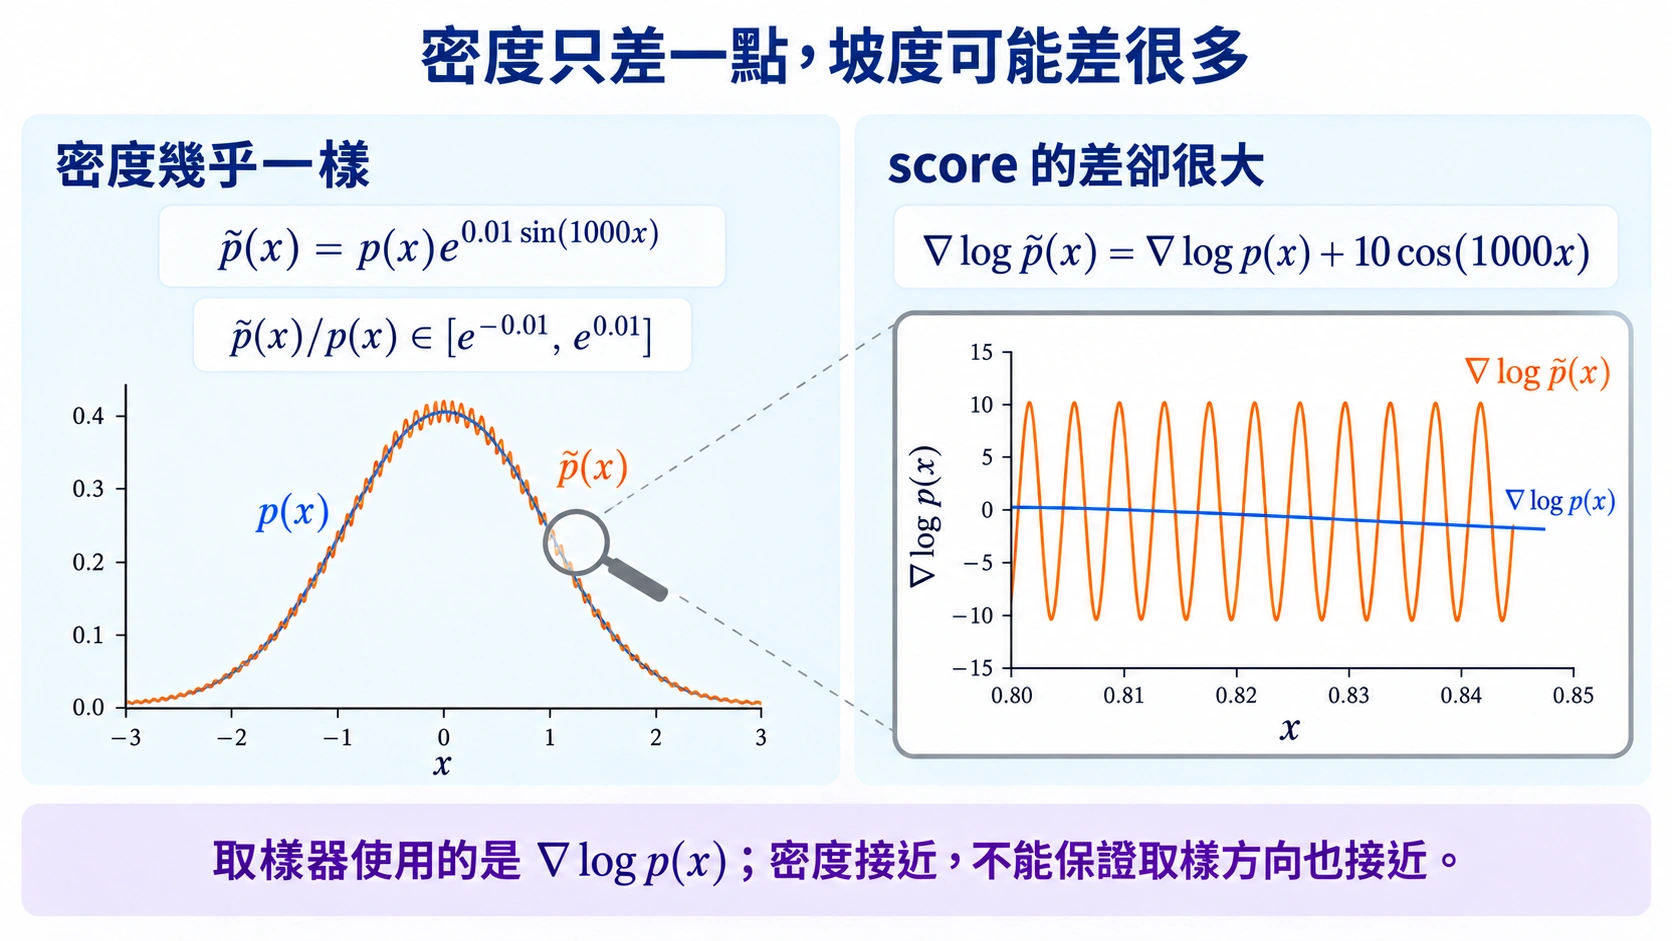
補充 Density 估得接近,微分後的 score 也會接近嗎? 還需要檢查導數。固定一個 noise level,這裡把真實 density 簡寫成 p ( x ) p(x) p ( x )
p ~ ( x ) = p ( x ) e 0.01 sin ( 1000 x ) , p ~ ( x ) p ( x ) ∈ [ e − 0.01 , e 0.01 ] . \tilde p(x)=p(x)e^{0.01\sin(1000x)},
\qquad
\frac{\tilde p(x)}{p(x)}\in[e^{-0.01},e^{0.01}]. p ~ ( x ) = p ( x ) e 0.01 s i n ( 1000 x ) , p ( x ) p ~ ( x ) ∈ [ e − 0.01 , e 0.01 ] . p ~ \tilde p p ~ Z = ∫ p ~ ( x ) d x Z=\int\tilde p(x)\,\mathrm dx Z = ∫ p ~ ( x ) d x r ( x ) = p ~ ( x ) / Z r(x)=\tilde p(x)/Z r ( x ) = p ~ ( x ) / Z Z Z Z x x x
∇ x log r ( x ) = ∇ x log p ~ ( x ) = ∇ x log p ( x ) + 10 cos ( 1000 x ) . \nabla_x\log r(x)
=\nabla_x\log\tilde p(x)
=\nabla_x\log p(x)+10\cos(1000x). ∇ x log r ( x ) = ∇ x log p ~ ( x ) = ∇ x log p ( x ) + 10 cos ( 1000 x ) . 左圖比較函數值,右圖放大一小段 x x x 0.01 sin ( 1000 x ) 0.01\sin(1000x) 0.01 sin ( 1000 x ) 10 cos ( 1000 x ) 10\cos(1000x) 10 cos ( 1000 x )
Week 3 投影片 5 · 點圖查看原圖 所以直接把學到的 density 再微分,還需要控制導數的誤差。前面的 denoising regression 則透過 Tweedie,直接把要估計的量連到 score。
這個 score field 長什麼樣?
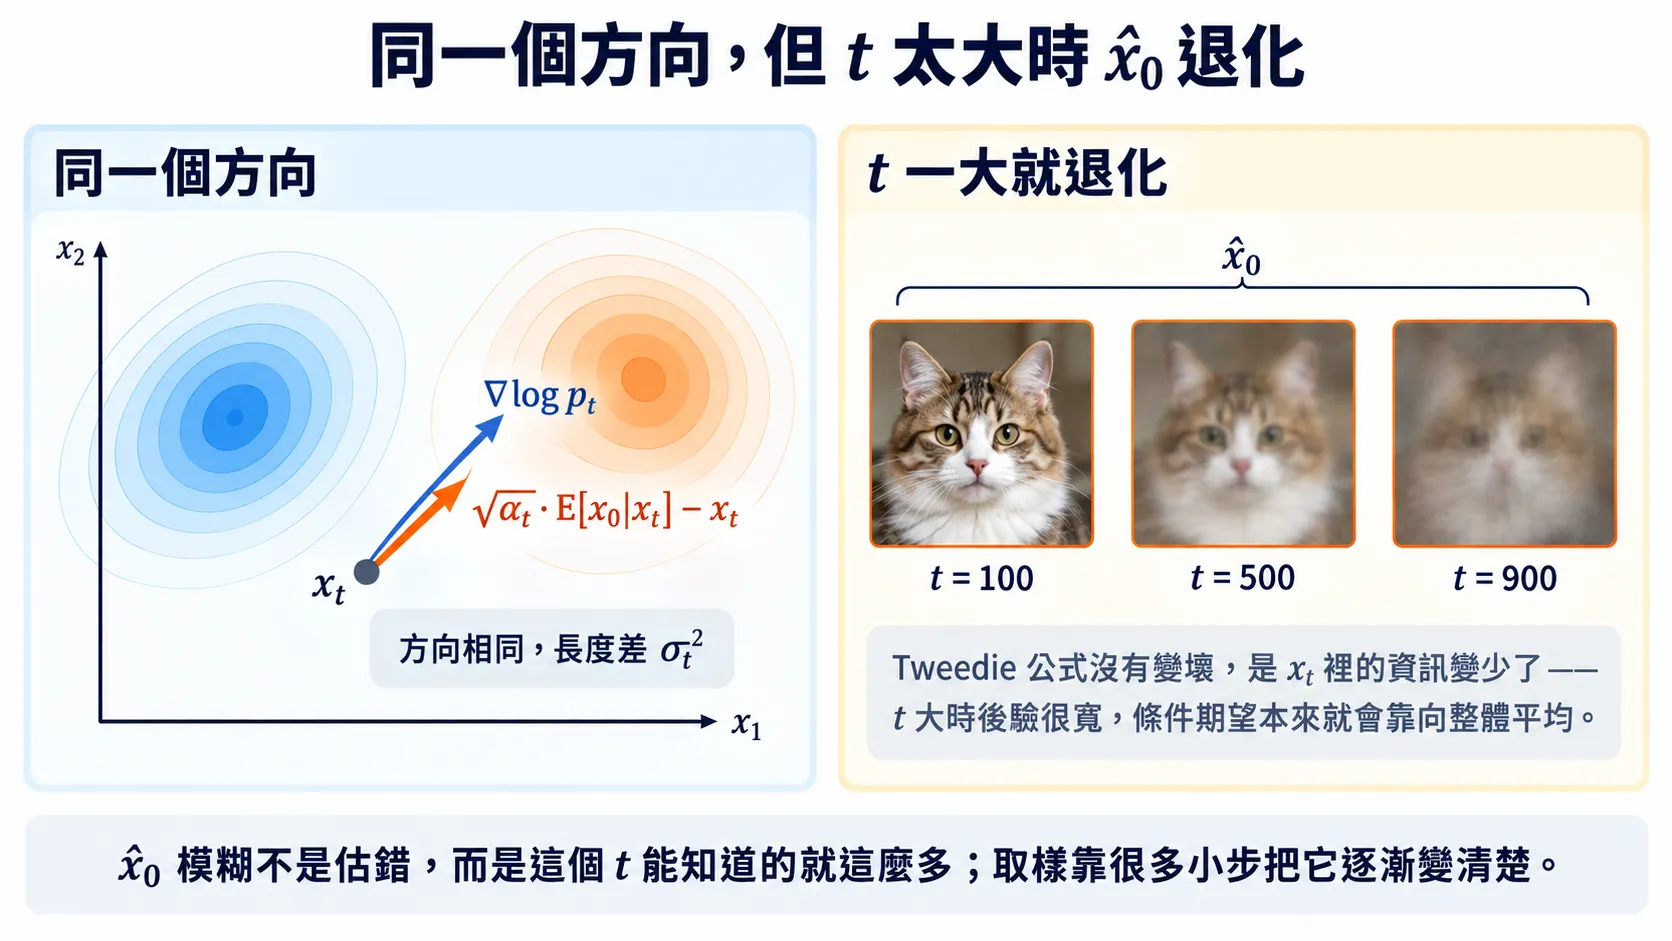
圖:同一個方向,但 t t t x ^ 0 \hat x_0 x ^ 0 左邊是 Tweedie 公式的畫面——兩支箭頭完全同向,只差 σ t 2 \sigma_t^2 σ t 2 t t t x ^ 0 \hat x_0 x ^ 0 公式沒有變壞,是 x t x_t x t
互動 demo:score field 與 denoising 方向。 箭頭是網格上每一點的 ∇ log p t \nabla\log p_t ∇ log p t α ˉ t E [ x 0 ∣ x t ] − x t \sqrt{\bar\alpha_t}\,\mathbb E[x_0\mid x_t]-x_t α ˉ t E [ x 0 ∣ x t ] − x t 方向完全一樣 ,只差 σ t 2 \sigma_t^2 σ t 2 t t t
消化一下
開頭的問題有答案了:simple MSE 學到的不是某一筆 training pair,而是整個 p t p_t p t
把這個 denoiser 代回 U1.2 的 reverse Gaussian,我們已經可以從 x T x_T x T x 0 x_0 x 0 t t t t − 1 t-1 t − 1
要釐清這些問題,我們得先了解這些 process 背後的運動規則:forward dynamics 如何把 p 0 p_0 p 0 p T p_T p T p T p_T p T p 0 p_0 p 0 同一組 noisy marginals 是否只對應一種走法,還是可以換一條允許跳步、卻仍走向正確 distribution 的路?
下一篇:U1.4 從離散步驟到 Forward / Reverse Dynamics →
參考文獻
Efron, B. Tweedie’s Formula and Selection Bias. M1.4 。)
Hyvärinen, A. Estimation of Non-Normalized Statistical Models by Score Matching. Z Z Z
Song, Y., Ermon, S. Generative Modeling by Estimating Gradients of the Data Distribution.