
U1.1 指定路徑的方法:Forward Process
有一個方向,我們知道怎麼走
上一篇的結論是:與其直接猜一個生成函數 ,不如先訂好一條路徑,再沿著這條路徑設計回歸目標,讓模型學會怎麼走。那接下來的問題就是:這條路要怎麼定呢?
直接設計一條「從純噪聲走到一張圖片」的路徑,感覺還是很困難——因為我們根本不知道,一團噪聲(noise)下一步應該變成什麼。
但如果反過來呢?從一張真實圖片出發,每次只加一點點噪聲,這件事我們似乎知道怎麼做:隨機抽一個 Gaussian noise、縮小一點,再加到圖片上。只加一次幾乎看不出差別;再加一點,圖片稍微模糊一些;持續加下去,最後整張圖就會變成幾乎純粹的噪聲。也就是說:資料 → 噪聲,這條路我們是會做的。
可以把它想成洗牌。把一副排好的牌每次只稍微洗亂一點,重複很多次之後,牌自然會變得完全隨機——這件事很容易做到。但反過來,要你把一副完全隨機、處於混亂的牌一次排回原本的順序,幾乎無從下手。不過如果問題變成「它剛剛只被弄亂了一點點,我能不能把這一小步修回來?」,事情好像就沒那麼困難了。
Diffusion 的核心想法就是這個:利用這個我們似乎知道怎麼走的方向,建立一連串很小的破壞步驟,然後去學怎麼把每一小步倒回來。 原本困難的「從噪聲直接生成圖片」,就被拆成很多步且每一步都比較容易學習的 denoising(去噪)問題。
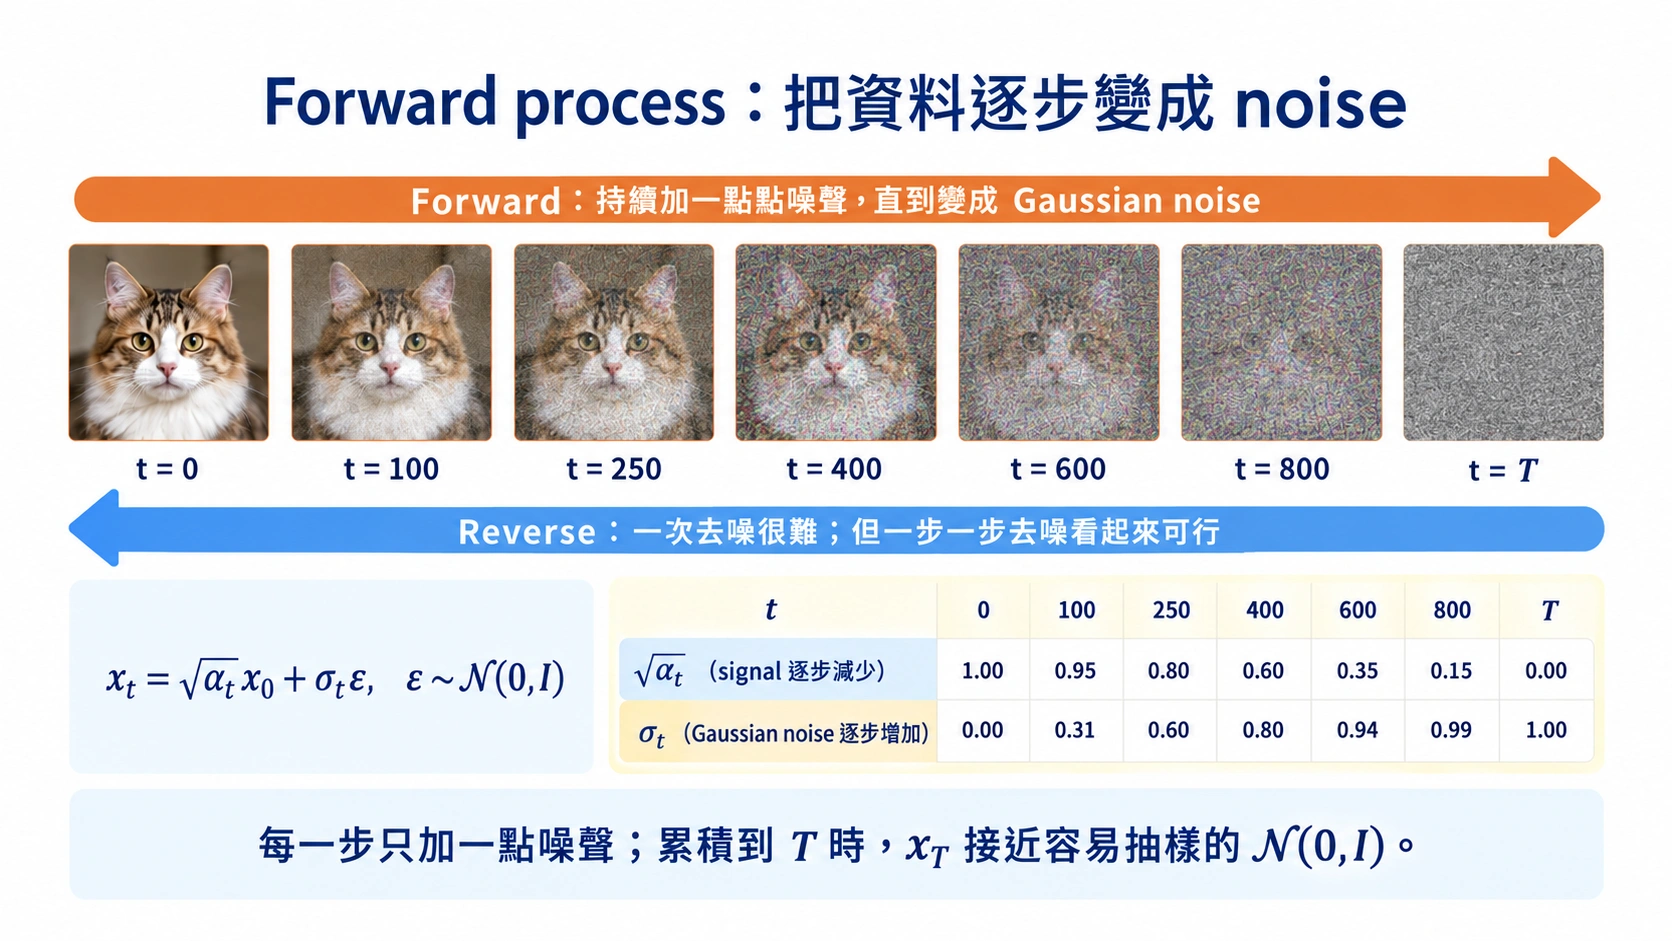
同一張照片沿時間由左往右逐漸被 noise 蓋過; 是原圖, 是接近純 noise 的另一端。圖中的七格是不同時間的示意快照,兩格之間還有許多小步。往右每一步都容易做;往左該如何走,才是模型要學的問題。
有了『一步一步加噪聲這個過程作為我們要走的那條路』這個直覺想法後,接下來就要用數學把這個過程描述清楚。
我們先引入記號來描述這條路上的每一個狀態: 是路的起點,也就是一張從 抽出來的真實圖片; 是加噪加了 步之後的樣子(下標 我們也叫它時間);走完全部 步之後的 就是路的另一端,幾乎是純 noise。所以上一張圖那七格,從左到右就是 一路走到 。
而這條從 一路加噪到 的路,就是之後每一篇都會提到的 forward process。要記得它是人訂的,不是資料給的——既然是我們自己訂,就有權利挑一條對自己最有利的。
有了記號和名字,我們想先確認三件事情:
這條路的另一端,真的會走到純 noise 嗎?
從 出發,沿著這條路走到時間 時, 會變成什麼樣子?
如果想要倒著走一步,我們需要知道什麼?又該怎麼做?
前兩個問題這一篇馬上就會回答,而第三個問題中的「需要知道什麼」要等到 U1.2 和 U1.3,而具體該怎麼做則要到 U1.4。
我們希望 forward process 做到的事
前面我們已經有一個粗糙的方向:從真實圖片出發,每次只加一點點 noise,就這樣一路加下去。但「一步一步加噪聲」目前還只是一個模糊的直覺,真正要把它變成一個能用的方法,我們得先問:我們希望 forward process 做到什麼?
第一件事,是這條路的另一端得停在一個我們很會抽樣的分布上(這裡我們會暫時先用 )。生成的時候我們是倒著走的,總得先有一個起點;如果走完 步之後的 落在一個我們根本不知道怎麼抽的分布上,那想要學「從 noise 倒回圖片」,連起點就不對了。所以「真的會走到純 noise 嗎」不是好奇而已,而是這個方法能不能成立的前提。
第二件事,是我們得算得出走到任意時間 時 會落在哪裡,而且最好不用真的從 一步一步走過去,如果知道 ,而且它是某種 Gaussian 分布,那就會很好算。
這裡的 是一個條件機率: 指的是 forward process 這套加噪程序帶出來的機率,豎線右邊則是「已經給定的條件」。所以整串要讀成「已經知道起點是 這張真實圖片的情況下,走了 步後會落在大概 的機率」。
而這兩件事其實在問同一個東西:走到底就是走到 ,所以只要 寫得出來,另一端長什麼樣子也就跟著知道了。
打個比方。你人在台大,要一路走到屏東——可以走西部:台中 → 台南 → 高雄 → 屏東;也可以繞東部:宜蘭 → 花蓮 → 台東 → 屏東。台大就是起點 ,每一站就是一個 。 說的是「第一步走到台中的可能性有多大、走到宜蘭的可能性又有多大」;而 說的是「走了 段之後,人剛好在某座城市的可能性有多大」——不管中間到底走過哪一條路。
問題就在這個「不管中間怎麼走」。一般來說,如果只想知道最後的 ,就得把所有可能的中間路線全部加總起來:
被積的那一項 可以理解成:給定起點是 ,我們這套加噪程序剛好走出差不多 這一條指定路線的可能性有多大;而積分就是把中間的 所有可能都考慮進去、全部累積起來。
看起來很麻煩。所以我們可以反過來問:能不能故意把這條加噪路徑設計成一條很好算的路?
第一個設計:下一步只看現在
最先可以做的,是讓每一步只依賴上一步,不需要回頭看更早的狀態:
這就讓整個 forward process 成為一條 Markov chain。而且這不是我們從資料裡「發現」的性質,是刻意設計出來的: 只從上一個狀態 出發,再加入一個新抽的、與過去獨立的 。
補充Markov chain:過去已成定局,未來只看現在
一條隨機過程
是一條 Markov chain,意思是:要預測下一步,只要知道現在在哪裡,不需要追問它的過去。一旦知道 ,就足以預測 ;更早的 就算給了,也不會再提供額外的資訊。
這有點像大學的考試分發:能不能錄取,看的是你手上那張成績單上的分數;你高中三年是一路穩定、還是最後半年才衝上來,分發的規則完全不看。
不過「跟過去無關」這句話要小心讀:不是過去不重要,而是過去該留下的東西都已經濃縮在現在這個狀態裡了,規則只需要讀它。forward process 也是同一件事—— 身上已經帶著前面每一步加進去的 noise,所以再多看 也問不出新東西。
寫成數學就是
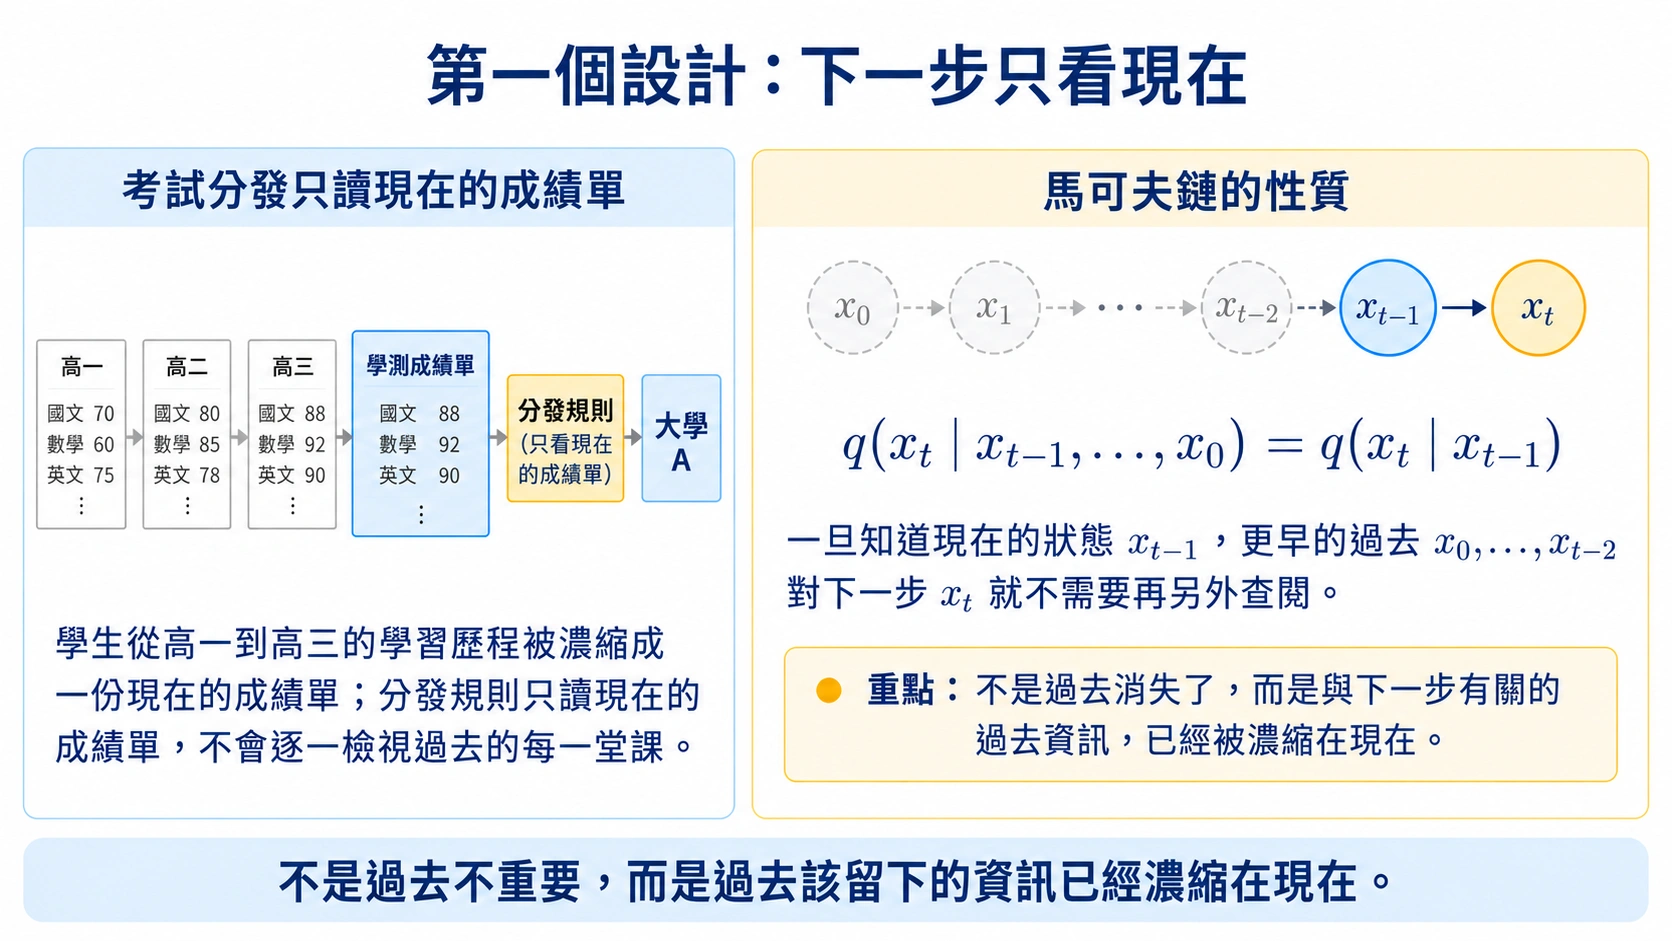
藍色 是目前狀態,黃色 是下一步;灰色的更早狀態在給定 後不再提供額外資訊。圖中的等式就是 ,並不表示 和過去完全獨立。
更詳細的 Markov chain 介紹——定義、transition matrix 與長期行為——可以參考 M4.0。
Markov property 帶來的好處是,一整條指定路線的機率可以拆成很多小段:
回到剛剛的旅程:一整條路線的可能性,等於把每一段的可能性乘起來。 先看台大 → 台中的機率,再看「已經到了台中」之後 → 會去台南的機率,依此類推——每一段 只需要知道上一站。
但這還只解決了一半。
路拆得開,不代表我們就會積分,積分結果就會好看。
我們還需要讓每一小步的形式足夠簡單,使得把中間的狀態消掉之後, 仍然能寫成漂亮的 closed form。
第二個設計:Linear + Gaussian
Gaussian 有一個非常方便的性質:經過線性變換、再加上一個 Gaussian noise,結果仍然是 Gaussian。 所以如果固定總步數 、選一組很小的 ,把每一步都設計成
括號裡的兩個位置分別是平均和變異數,所以這一行是說: 服從一個 Gaussian,中心在「把 縮小 倍」的位置,散布的大小是 。寫成取樣的樣子更好懂,它等價於
一步只加一點 noise,要怎麼寫?
- 手上先有上一個狀態 ,要從它產生下一個 。
- 把原本的狀態乘上 ,先縮小一點。
- 獨立抽一個新的 ,縮放成 再加上去。
也就是:把上一個狀態稍微縮小一點,再補上一點新的 Gaussian noise。 其中 控制第 步要加多少 noise。
「先逐步加噪、再學著倒回來」的構想可以追溯到 Sohl-Dickstein、Weiss、Maheswaranathan 與 Ganguli [1]。這裡這一組選擇——Gaussian、線性縮放、係數挑成 ——則是 Ho、Jain 與 Abbeel 提出的 DDPM(denoising diffusion probabilistic models)[2] 的 forward process,也是這門課接下來預設的那一條路。
這條式子中有兩個我們特別設計的地方。
為什麼要乘 ? 如果只加噪聲、不縮小,變異數會一路累積到超大然後爆掉——也真的有人這樣設計,Song 等人 [4] 稱它為 variance-exploding(VE);U5 就會用到它。但如果我們考慮用 來縮放,這時候如果假設 ,那麼
信號縮小多少,噪聲就補上多少,變異數總量剛好不變——因此這種 forward process 叫 variance-preserving(VP)。它帶來兩個實際好處: 比較容易落在 附近(我們會抽的那個分布),而且網路的輸入尺度在每個 都差不多,不會有的時候很大、有的時候很小。
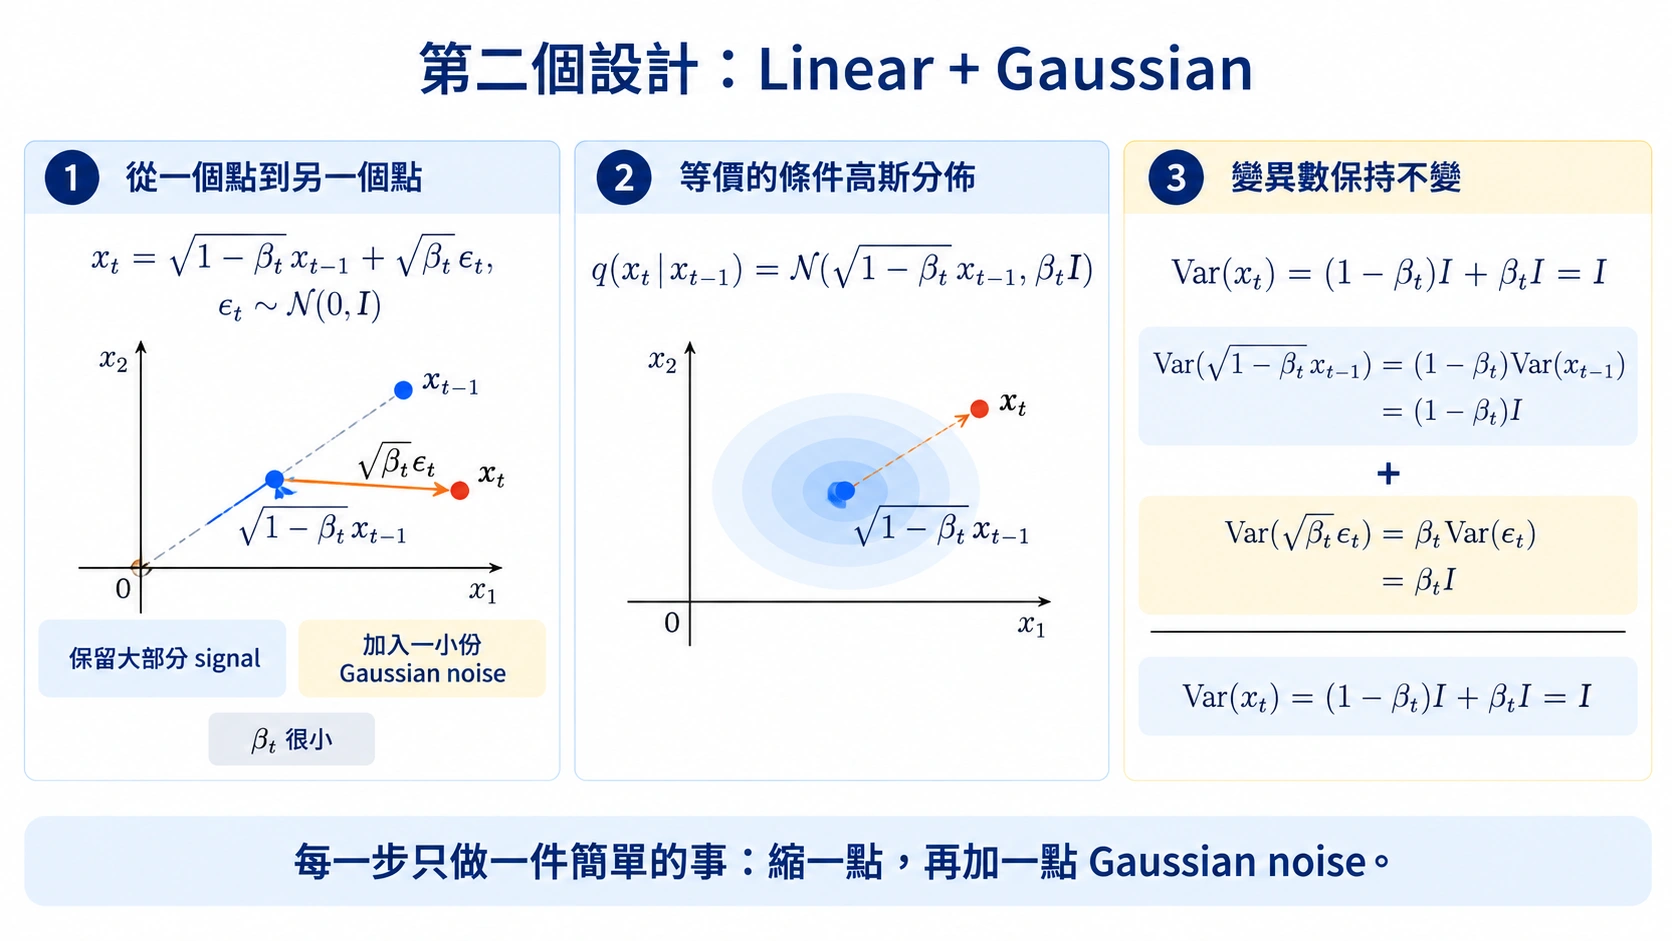
左欄是一個 realization:先縮成 ,再加上這次抽到的 。中欄固定 、改抽不同的 ,就得到 conditional Gaussian。右欄則額外假設 ,檢查兩份 variance 如何補回 。
為什麼 要小? 因為每一步的變化小,反向那一步才容易學。這就是「切碎」真正的意思:我們不是要讓模型少做事,而是要讓它每一次只做一件簡單的事。
符號、、 與 SNR:四個之後一直會用的量
往下推導之前,先把記號一次講完:
- :這一步留下多少信號。
- :從頭到現在累積留下多少信號,會從 1 一路遞減到接近 0。
- :對應累積起來的噪聲強度,兩者永遠滿足 。
- :signal-to-noise ratio,「還剩多少信號比得上噪聲」。 越大,SNR 越小。
隨 怎麼變,稱為 schedule。DDPM 原文 [2] 使用 linear schedule;Nichol 與 Dhariwal [3] 後來提出 cosine schedule。schedule 一旦定了, 就定了,這條路的「速度」也就定了。
記號齊了,就可以看整條路是怎麼一步一步加出來的——其實就是把上面那一行一直套下去:
每一行都要等上一行算完才能算,而且每一行都新抽一個 。所以照定義,想拿到 ,就得從 把這個遞迴老老實實跑 次。
真的要跑 次嗎?
課堂提問Q1
訓練的時候我們需要很多組 的配對,而 可能是 800。每抽一個訓練樣本都要把上面那個遞迴跑 800 次,這樣訓練根本跑不動。
有沒有辦法一步就跳到 ?
先想一想,再展開看整理後的答案
可以,而且關鍵只有一句話:兩個獨立的 Gaussian 加起來還是 Gaussian,而且變異數相加(M1.0)。
先展開兩步看看。把 代進去:
後面那兩項合起來仍然是一個 Gaussian,變異數是
剛好又補成兩個係數平方和等於 1。一路歸納下去就得到我們實作上最常用的那一行:
不用逐步走,也能直接得到任意時間的樣本嗎?
- 先拿一張真實圖片 ,並指定想看到的時間 。
- 從頭到現在留下的信號,合起來就是 。
- 把前面的小 noise 合成一個 ,其變異數是 。
- 所以固定 後, 就服從這個 Gaussian;抽一次 noise 就能直接算出它。
於是取一個訓練樣本只要做三件事:抽一個 、抽一個 、算一次乘法與加法。 完全不需要跑那 800 步的遞迴。
這一行在說的事情其實很單純:任意時刻的 就是「縮小的資料 + 一個 Gaussian noise」,而且兩個係數的平方和恆為 1。
換個角度看,這一行其實是把資料和一個 noise 用 這組係數來做插值(interpolation)。而「係數平方和恆為 1」是 VP 這個選擇帶來的限制,不是插值本身要求的——U3.0 會把這組係數換成 的直線插值(linear interpolation),U2.4 則考慮最一般的情況,寫成一個把 diffusion、flow matching 都涵蓋進去的通式(general form)。
唯一要特別小心的事:這裡的 不是任何一步加進去的 ,而是把 個小小的噪聲合併之後、重新命名的單一 Gaussian 變數;它與 獨立。下一篇的訓練目標會直接針對它,所以這個區別要記起來。
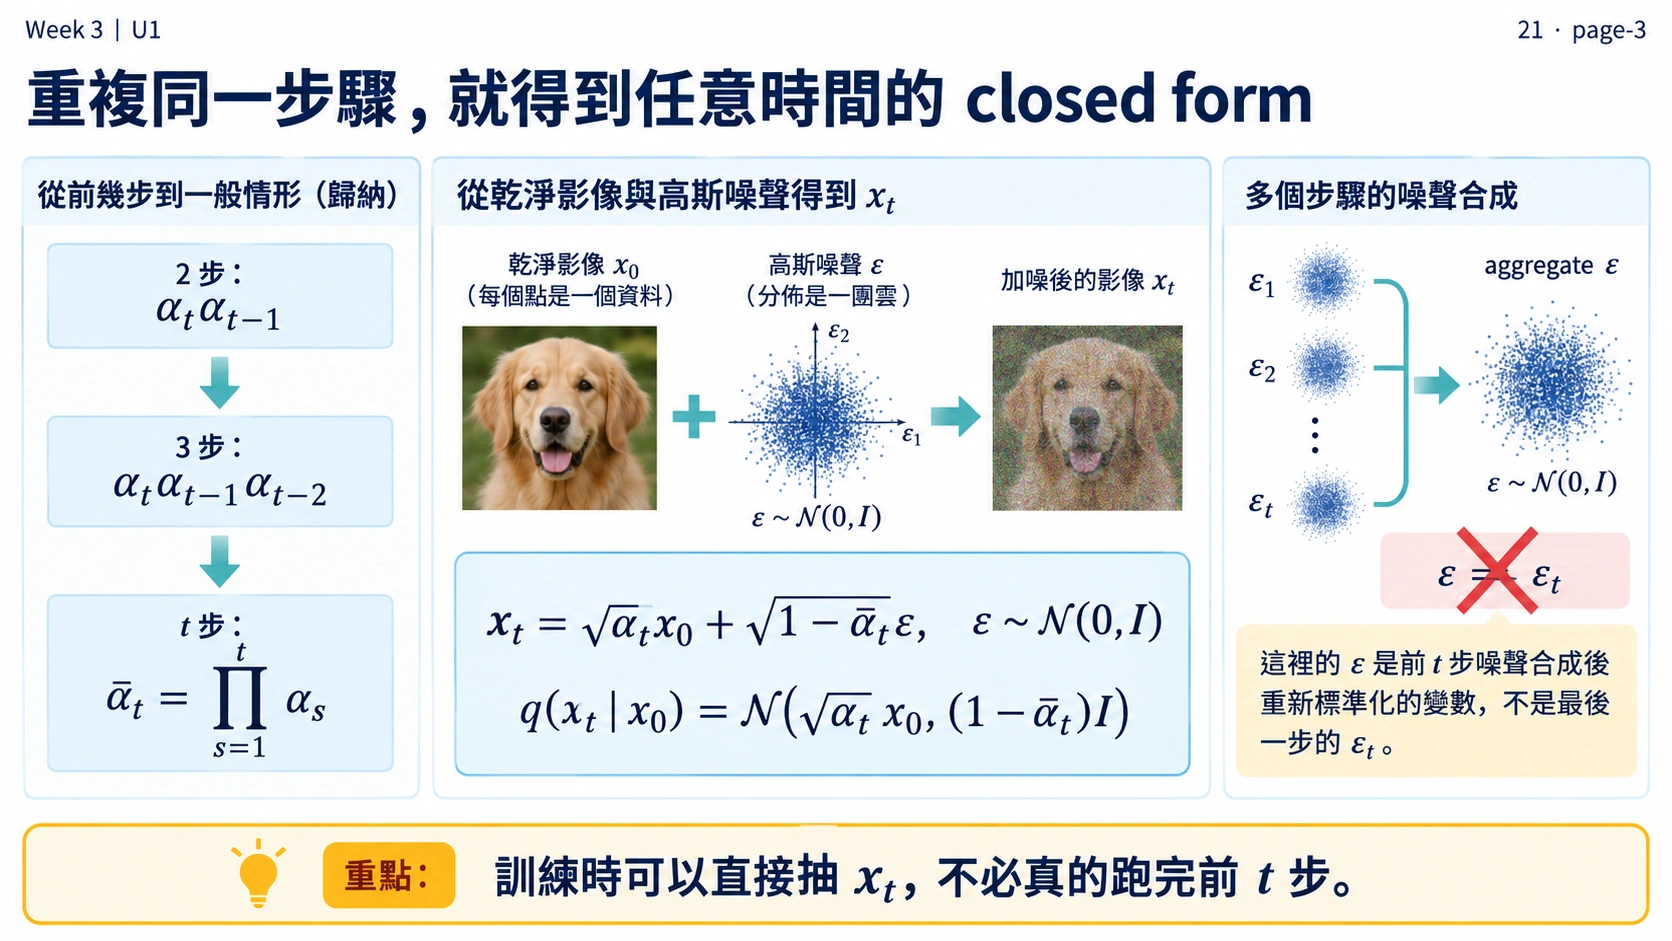
左欄將逐步保留率乘成 ,中欄把結果寫成 ,其中 。右欄特別區分每一步新抽的 ,和把這些 noise 加權合併、重新標準化後的單一 。
讓這一行成立的正是前面那兩個設計:Markov property 讓整條路能拆成很多簡單的小步驟;Linear + Gaussian 讓這些小步算得出來,且接起來之後仍然是 Gaussian,這使得那個積分有 closed form——於是不必真的去算它或是走 次,直接用 就能算出 。少了任何一個部分都不一定能這樣算出來,特別是少了第二個設計, 就不一定會有這樣漂亮的形式。
這一行也回答了第一個問題。把 換成 :,只要 schedule 讓 小到幾乎是 0—— 的痕跡就被壓到幾乎看不見,而 會趨近於 1,確保 確實走到了純 noise,因此反過來走真的是從 出發。
補充 真的等於 嗎?
嚴格說不等於,只是很接近。 很小但不是 0,所以 裡還殘留著一點點資料的痕跡。
而取樣的時候,我們是直接從 出發的——等於把這一點差距當成誤差吃下來,這件事叫 prior mismatch。它通常很小(DDPM 的 ),但它是真的存在,也是為什麼 schedule 不能設得太「慢」。
這條路長什麼樣子
互動 demo:加噪滑桿。 拖 看 怎麼一路變化,右邊同步顯示 、 與 SNR:資料的形狀先變模糊、再漸漸變成純噪聲(也就是 )。切換 schedule 會發現兩端完全一樣,只有中間移動的速度不同——你可能會發現 linear 很早就把結構洗掉了,cosine 則把中間段留得久一點,在實務上各有好處。
消化一下
參考文獻
- Sohl-Dickstein, J., Weiss, E. A., Maheswaranathan, N., Ganguli, S. Deep Unsupervised Learning using Nonequilibrium Thermodynamics. ICML 2015. (「加噪再倒回來」這個想法的出處。)
- Ho, J., Jain, A., Abbeel, P. Denoising Diffusion Probabilistic Models. NeurIPS 2020. (本篇的 VP forward process 與 linear schedule。)
- Nichol, A., Dhariwal, P. Improved Denoising Diffusion Probabilistic Models. ICML 2021. (cosine schedule。)
- Song, Y., Sohl-Dickstein, J., Kingma, D. P., Kumar, A., Ermon, S., Poole, B. Score-Based Generative Modeling through Stochastic Differential Equations. ICLR 2021. (VP 與 VE 這兩個名字的出處。)