
U3.4 少看幾次方向,還能走得準嗎?
本篇重用1 篇
在 U3.1 中,我們看到 Euler 的 finite-step error 來自一步之內被忽略的 velocity 變化。U3.2 與 U3.3 選擇修改 coupling,希望讓 learned ODE trajectory 更接近等速直線。
但如果模型已經訓好了,velocity field 也就固定了。這時候我們不能再重新安排 reference paths,能改的是怎麼近似這條 ODE。
沿用前面的導航例子:假設路線已經固定,但手機只剩下一點電,我們只能打開地圖看幾次方向。每次看完都可以往前走一段;問題是,這幾次查詢應該怎麼用,才不會在轉彎處走過頭?
回到精確更新:
右邊的積分需要知道整段路上的 velocity,但我們手上只有 neural network ,只能在選定的位置與時間逐次詢問。每呼叫一次網路取得 velocity,算一次 network function evaluation(NFE)。Numerical solver 在做的事情,就是好好安排這些 queries,用有限的資訊去近似我們想要算的積分。那麼:
如果只能查詢固定次數的 neural velocity,
要怎麼使用這些 queries,才能比 Euler 走得更準?
Review:Euler 一步只看一個方向
沿用 U3.1 的符號:, 是精確 ODE trajectory, 是 solver 算出的近似位置。下面固定同一個 field,簡寫成 ;實作時,每次查詢的都是 。
Euler 在一步的起點詢問一次:
它把整段積分近似成一個長方形:寬是 ,高是起點 velocity。每一步只花 1 NFE,但也等於假設接下來這一小段的方向與速度大小都不變。若把 平均切成 步,便需要 NFE,步長是 。
U3.1 已經得到,在 regularity 條件下,它的全域誤差會受到
控制。Velocity 沿 trajectory 越穩定,這個近似越準;方向或速度大小改得越快,就必須把 縮小。但縮小 代表多走幾步,也就要花更多 NFE。
只看起點不夠,能不能也看一下終點?
U3.1 已經把沿 trajectory 感受到的 acceleration 記成 。將精確解在 附近做 Taylor expansion:
Euler 只留下前兩項,漏掉的正是 。但真的要使用這一項,就得知道 acceleration。有沒有辦法不直接計算 acceleration,卻稍微捕捉到 velocity 在這一步裡改變了多少?
Acceleration 描述的就是 velocity 如何改變。因此,除了起點的方向,我們可以在這一步的終點再問一次:如果前後兩支箭頭差很多,代表這一段的 velocity 確實改變得很快。
從積分的角度也可以看到同一件事。Euler 用起點的 velocity 畫一個長方形來近似積分;如果 velocity 在這一小段裡逐漸改變,用起點與終點兩個高度畫出的梯形,通常會更接近曲線下面的面積。也就是使用兩者的平均 velocity:
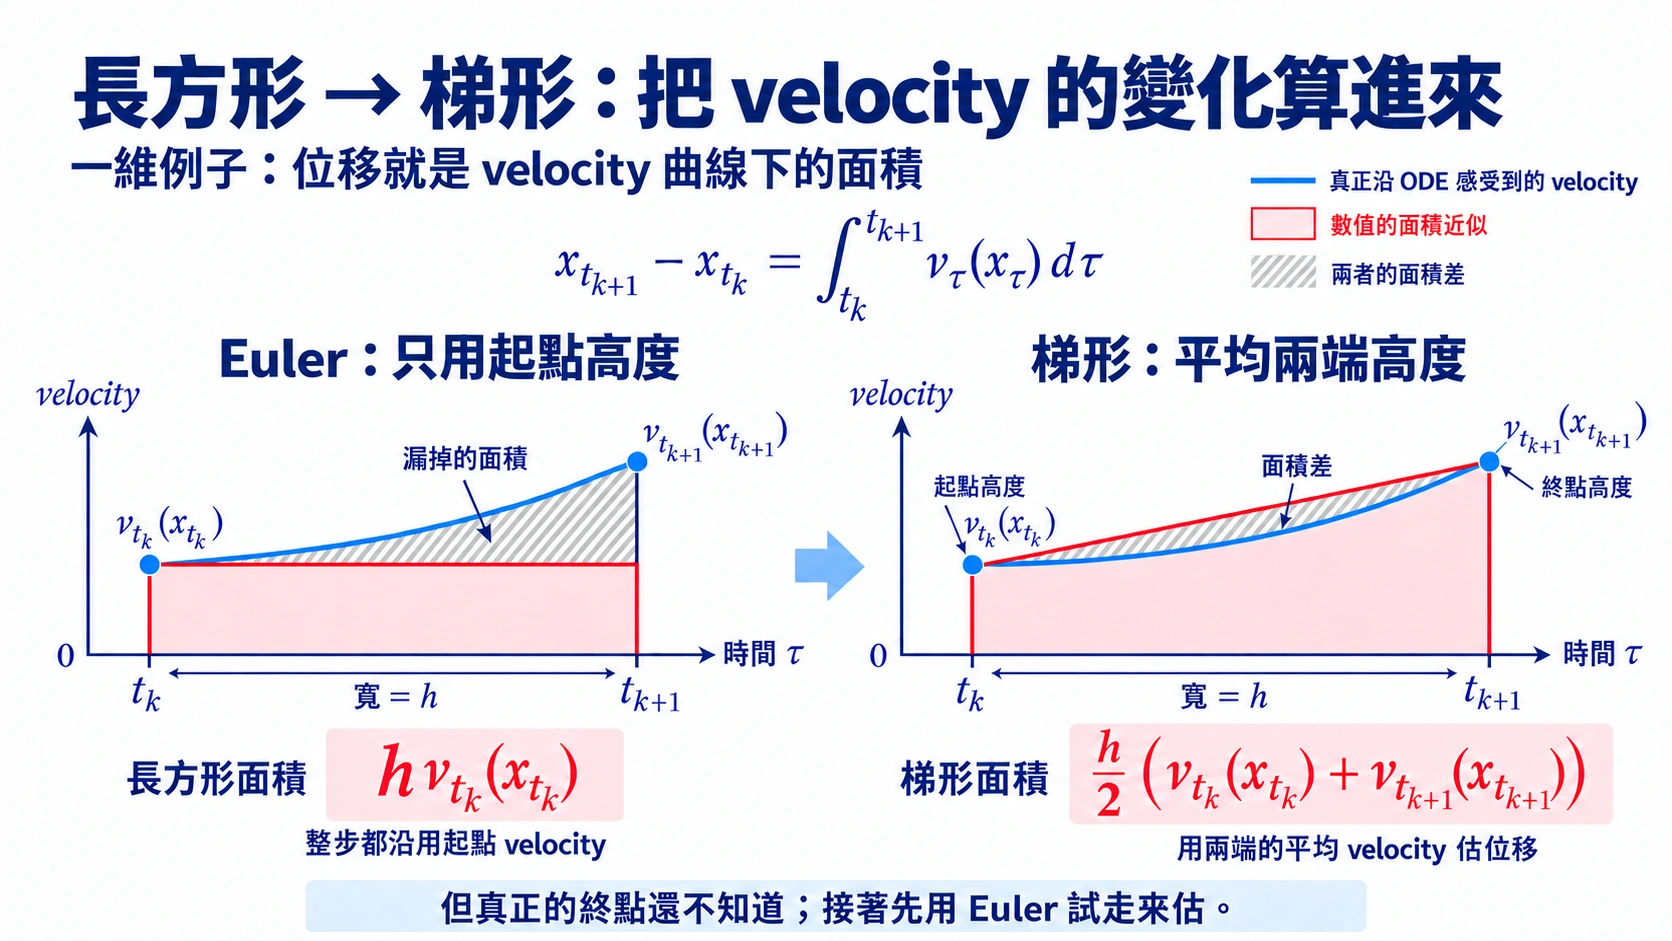
藍線是精確 trajectory 上的 ,紅色面積是位移近似,灰色斜線是面積差。兩欄使用同一段 ,寬度都是 ;右欄暫時假設真正終點的 velocity 已知,接著才處理「終點還沒算出來」的問題。
不過,真正的 正是我們還在計算的答案,現在還不能拿它來問 velocity。最直接的處理方式,是從目前的近似位置 先用 Euler 試走一次,得到一個預測終點:
先試走,才有位置可問第二次速度
- 是 solver 手上的近似位置;真正的下一個終點還不知道。
- 在時間 、位置 查詢 ,花掉第一次 NFE。
- 把這支 velocity 乘上 ,加回目前位置,得到 predictor 。它提供第二次查詢的位置,還不是最後接受的答案。
接著在預測位置 、時間 再問一次方向,最後用起點與預測終點的平均 velocity 修正這一步:
用兩次查詢修正這一步
- Predictor 用過的 可以直接沿用,不必再花一次 NFE。
- 現在有了 ,就在這個預測位置與新時間 查第二次 velocity。
- 把起點與預測終點的 velocities 加起來,再乘 ,近似這一小段的平均 velocity。
- 乘上這一步的時間長度 ,得到 Heun 使用的位移近似。
- 從原本的 加上修正位移,得到 corrector 。整步共用兩次 velocity 查詢,也就是 2 NFE。
前一個式子只是 predictor,後一個式子才是 corrector;這個做法稱為 Heun method。沿用導航的例子,就是先照目前方向試走到下一個位置,在那裡再看一次導航;如果前後方向不同,便不讓整步都跟著第一支箭頭走。
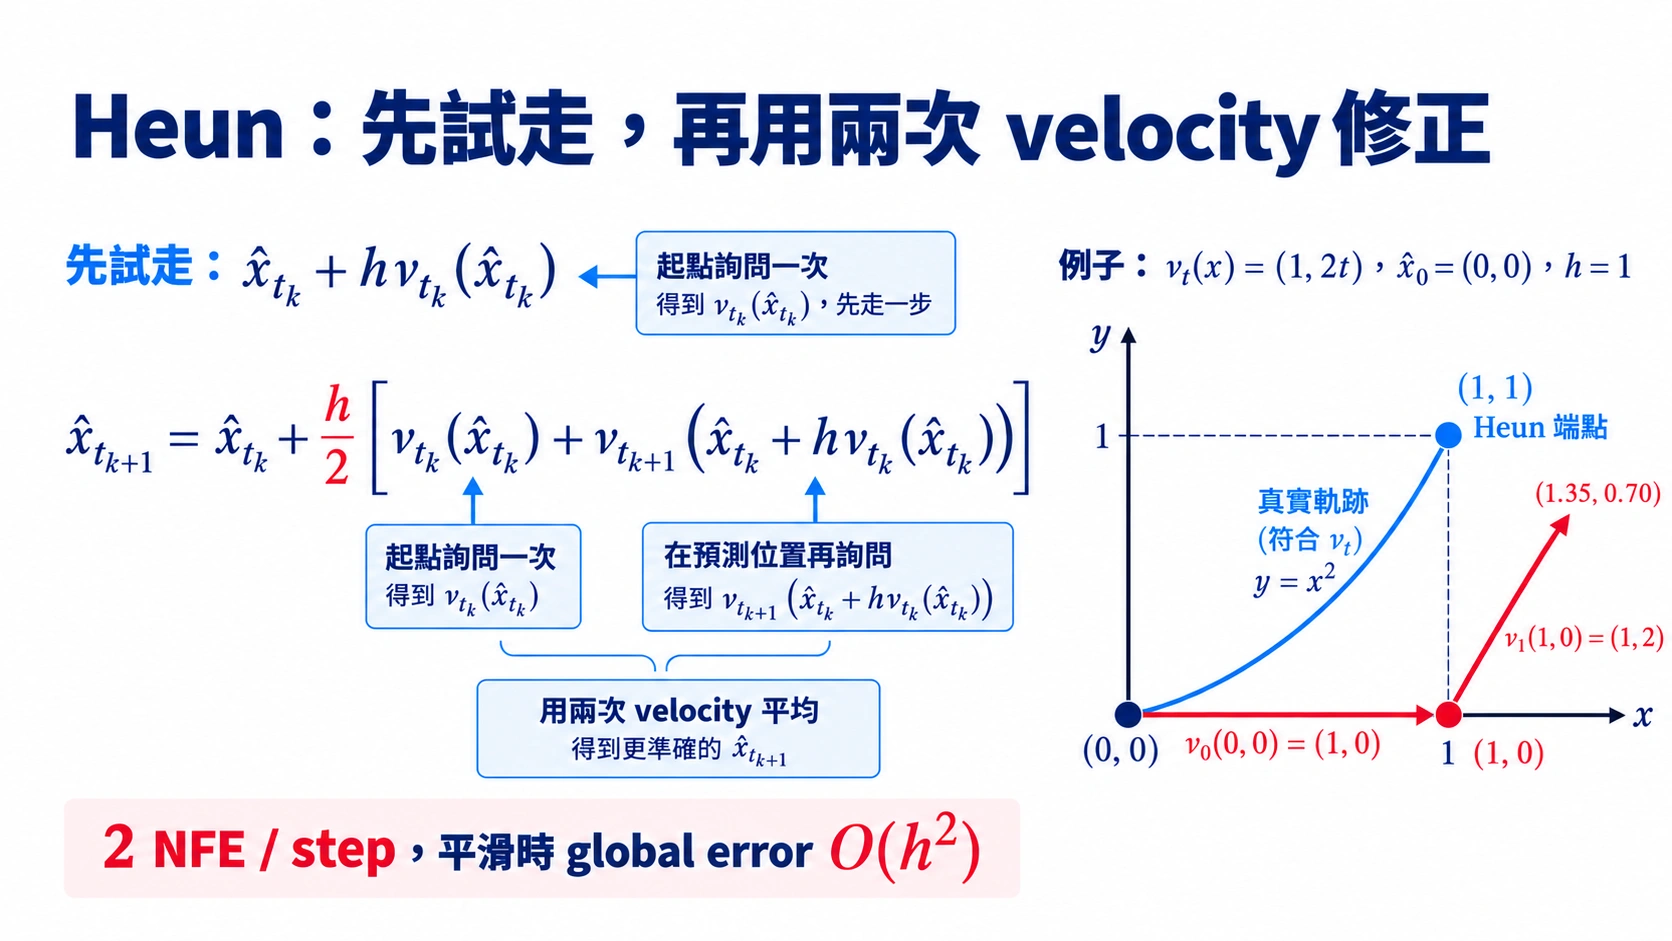
左欄把 predictor 直接代進 corrector,因此和上式相同。右欄取 、、:Euler 先預測 ,第二次查到 ,平均兩次 velocity 後,Heun 抵達 。這個 toy 剛好一步精確;一般 field 仍有高階餘項。
為什麼兩個 velocity 的平均能補到 acceleration?
為了只比較這一步新產生的 local error,先假設目前位置精確,也就是 。在 trajectory 夠平滑時,預測終點的 velocity 可以展開成
也就是說,起點與預測終點的 velocity 相差大約 。把它放回剛才的梯形更新:
Heun 因此補回了 Euler 漏掉的二次項。在 trajectory 夠平滑時,Euler 每一步的 local error 是 ,累積約 步後得到 的 global error;Heun 的 local error 是 ,所以 global error 變成 :
Karras 等人 [1] 在 diffusion sampling 中採用了這類二階修正。不過,Heun 每一步要 2 NFE。如果總預算只有 次網路呼叫,Euler 可以走 步,Heun 通常只能走 步。因此實務比較應該固定 NFE,而不是讓兩者走一樣多步。
每一段都走一樣大步,可能把 queries 用錯地方
Euler 與剛才的 Heun 都把時間切成等長的小段。但導航次數有限時,直路每隔幾公尺就重新確認方向很浪費;接近轉彎處,隔太久才看一次又容易走過頭。更自然的做法是:velocity 穩定時走大步,變化明顯時再縮小步長。
麻煩是,我們事先不知道哪一段變化比較大。最簡單的判斷方法,是從同一個 出發,分別算「一個大步」與「兩個半步」。用 與 標記這兩種終點近似:
為什麼兩個結果的差可以拿來判斷?沿用剛才的 Taylor expansion,可以算出
所以兩者的差雖然不是真實誤差本身,卻會隨這一段的 velocity 變化一起增大。把差距的 norm 記成 ,並用 表示事先設定的 tolerance,也就是我們願意接受的 local discrepancy:
用兩種近似的差判斷是否該縮步
- 從目前位置出發,以步長 做一次 Euler,得到 。
- 這次以 走兩次,中途再查 velocity,得到同一時刻的另一個近似 。
- 兩個終點相減並取 norm。這裡只比較 solver 能算出的結果,沒有用到未知的精確答案。
- 用 記這個差距,再與 tolerance 比較,決定接受這一步或縮小 重算。 是誤差信號,並不等於真實 local error。
若 ,就接受這一步,下一步還可以放大 ;若 ,就拒絕這次更新、縮小 再算。
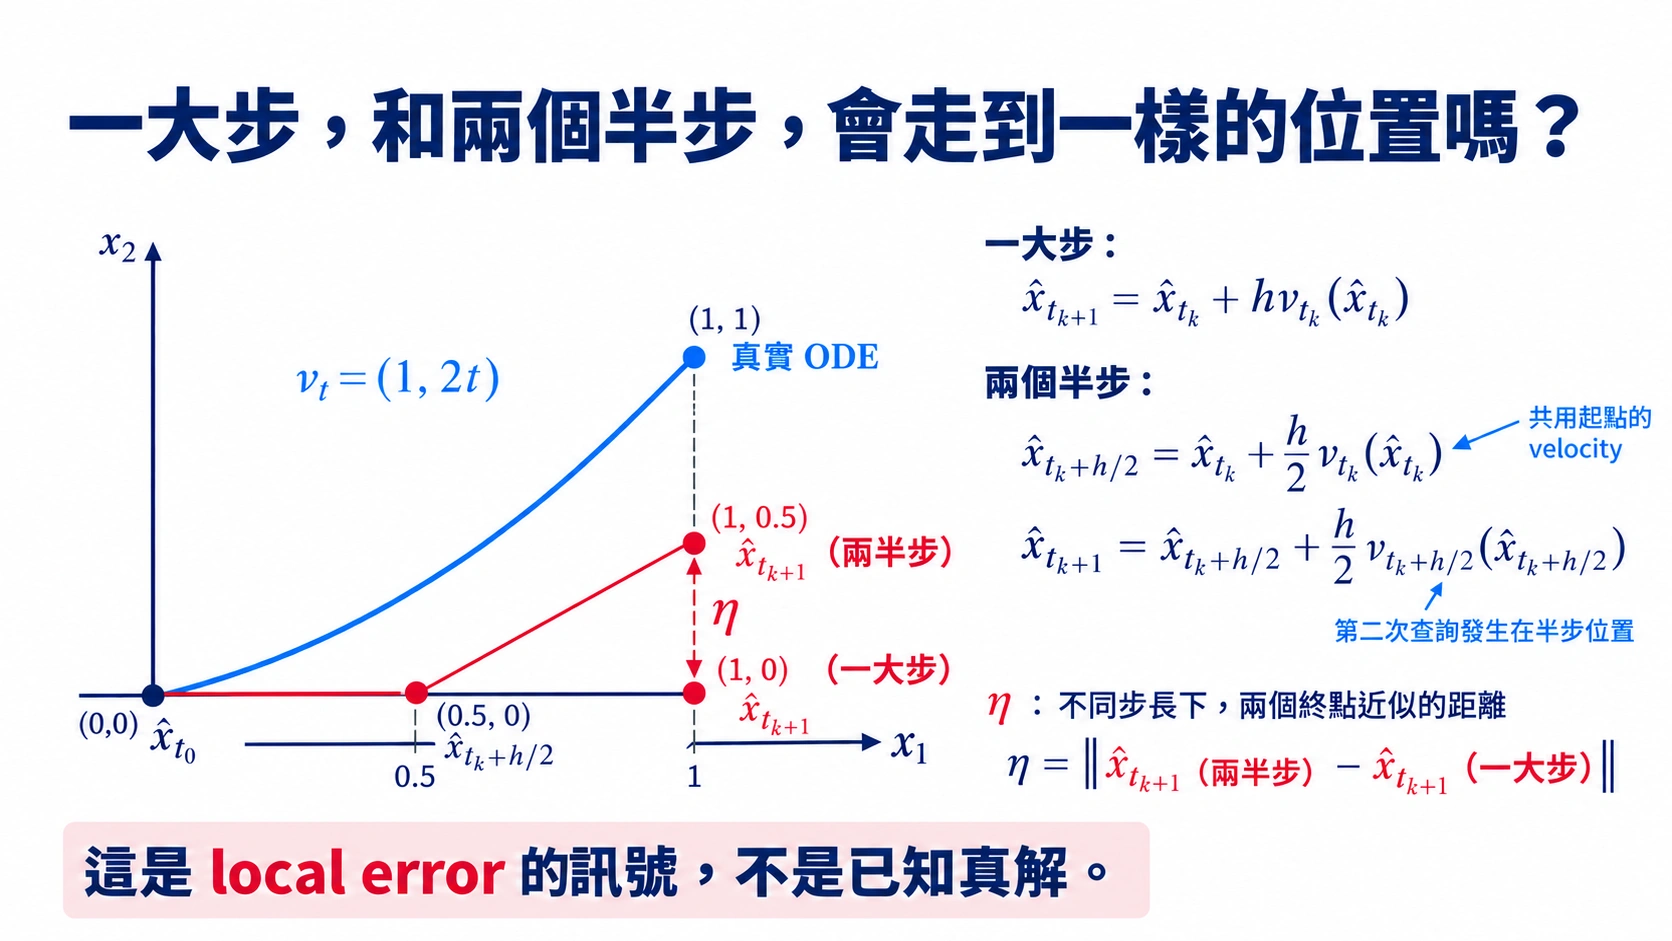
沿用 、:一個大步到 ,兩個半步到 ,所以 。這是兩種近似的差,沒有拿真正答案 來算;實際演算法也不需要事先知道精確終點。
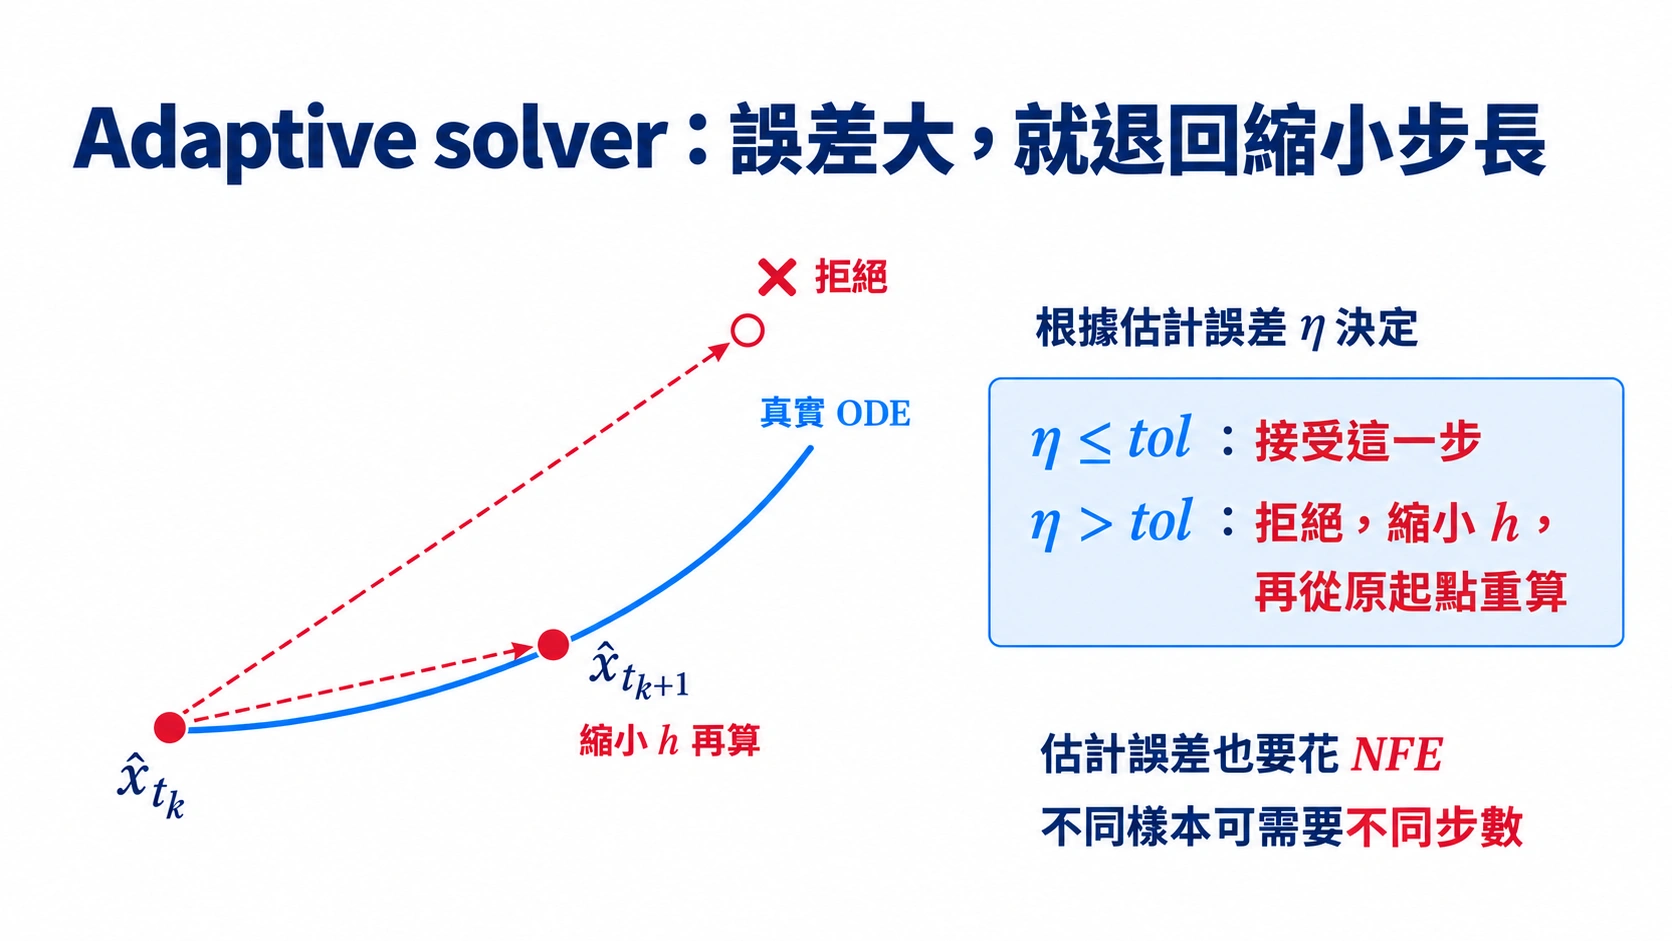
接受時才前進時間;拒絕時仍留在原本的 ,縮小 、重新設定 再算。圖中的藍線只是用來說明誤差來源;接受或拒絕的判斷依據是 ,不需要先知道藍線。
這就是 adaptive step size 的基本想法。注意,前面介紹的 Heun 本身仍是固定步長;「用 Heun」與「步長會不會自動調整」是兩個不同的選擇。不過,Heun 的 Euler predictor 與 corrector 已經給了同一步的兩種近似,因此也可以用
當成 local error signal,再依照差距放大或縮小下一步。更一般的 embedded Runge–Kutta methods 也會共用一組 velocity evaluations,同時計算兩個不同階數的近似;Dormand–Prince method [2] 就是常見的例子。Adaptive solver 不需要預先知道哪裡會轉彎、加速或減速,但估計誤差本身也會花 NFE,而且不同樣本可能需要不同步數。
互動 demo:先固定 NFE,再比較 Euler 與 Heun。 兩者在同一個平滑的二維旋轉 field 上使用完全相同的 NFE 預算;Heun 每一步需要兩次查詢,所以只能走一半的步數。切到 Adaptive 後,demo 改用 Euler predictor 與 Heun corrector 的差調整步長,在 velocity 變化明顯的區段留下較密的節點。
課堂提問Q1
Heun 是二階方法,Euler 只有一階。如果兩者都只能使用 20 NFE,Heun 是否一定比較準?
先想一想,再展開看整理後的答案
不一定。階數說的是 時誤差下降的速度,不是任何步數下的固定排名。
固定 20 NFE 時,Euler 可以走 20 步,Heun 通常只能走 10 步。Heun 雖然用兩次 velocity 估出較好的平均方向,但它每一步跨得也更大。當 trajectory 夠平滑、二階誤差常數不大時,Heun 通常會佔優;如果 velocity 在一步內變化得很不規則,高階導數很大,這個優勢可能縮小。
所以比較 solver 要同時寫清楚:總 NFE、誤差階數,以及 velocity 沿 trajectory 是否足夠平滑。 只說「二階比一階好」,少算了每一步的成本與不同問題的誤差常數。
如果 ODE 有一部分可以精確算,就不必全部一起近似
Euler、Heun 與 adaptive Runge–Kutta 都把右邊的 velocity field 當成一個 black-box function。不過 U2.3 的 Gaussian path 會產生一種特別的 semilinear structure:
其中 是 noise schedule 決定的已知係數;第一項對 是線性的,第二項才包含需要 NFE 的 neural network。對任意 ,這條 ODE 可以精確改寫成
第一行是可以直接算出的 linear evolution;numerical solver 真正需要近似的,只剩第二行包含 的積分。Lu 等人提出的 DPM-Solver [3] 就沿著這個想法,再把時間換成 log-SNR,對 neural term 建立高階近似。能精確處理的部分先算完,有限的 NFE 才不會花在重複近似已知結構上。
展開細節上面的 exact update 怎麼得到?
令
把 ODE 兩邊乘上 。因為 ,product rule 會讓 linear term 抵消:
從 積分到 ,再除回 ,就是正文的 exact update。這個動作通常叫做 integrating factor,或 variation-of-constants formula。
這個優勢不會自動延伸到任意 Flow Matching path。只有當 ODE 真的具有可以解析處理的結構時,專用 solver 才能利用它;否則仍要回到 Heun 或 adaptive Runge–Kutta 這類 general-purpose methods。
Solver 走得再準,也只是在解目前這個 field
Solver 只負責更準確地積分目前這條 learned ODE。若 和理想的 不同,即使把 numerical step size 縮到幾乎為零,我們得到的也只是 所定義之 ODE 的精確 trajectory,不會自動回到 原本應該產生的 probability path。
所以生成誤差至少要分成兩層:一層是模型學到的 field 不準,另一層才是用有限 NFE 解這個 field 所產生的 solver error。U3.1 的 補充已經把這兩項分開;Heun、adaptive solver 與 DPM-Solver 改善的是後者,不能替前者補回正確方向。
固定 learned field 之後,solver 決定的是我們能多準地走完它,不是這個 field 本身對不對。
快速回顧一下
參考文獻
- Karras, T., Aittala, M., Aila, T., Laine, S. Elucidating the Design Space of Diffusion-Based Generative Models. NeurIPS 2022. (Diffusion sampling 中使用二階修正,並以 NFE 比較計算成本。)
- Dormand, J. R., Prince, P. J. A Family of Embedded Runge–Kutta Formulae. Journal of Computational and Applied Mathematics, 1980. (用共享 evaluations 的不同階數近似估計 local error。)
- Lu, C., Zhou, Y., Bao, F., Chen, J., Li, C., Zhu, J. DPM-Solver: A Fast ODE Solver for Diffusion Probabilistic Model Sampling in Around 10 Steps. NeurIPS 2022. (把 linear part 解析積分,只對 neural term 做高階近似。)