
U7.1 不重新訓練,怎麼取得這次要求的引導方向?
本篇重用3 篇
模型會生成圖片了,但這一次我想要它畫一隻在雪山上滑雪板的柯基
在 U7.0 裡,我們整理了讓生成結果符合要求的幾種方法:conditional training 在訓練時加入 condition,fine-tuning 則用新資料更新模型。但如果不想為這次需求重新訓練,我們就得保留原本的參數,只在 sampling 時想辦法引導它;這就是 test-time steering。
我們想一個具體的情況:模型學過各種動物、建築物、風景與風格的圖片,但這一次我們想要它畫一隻在雪山上滑雪板的柯基。如果照原本的方法,隨意給一個 noise 去抽樣,模型很可能生成其他動物或風景。
即使是 text-to-image model——也就是接收一段文字(text)描述,根據它生成圖片(image)的模型——也可能沒有完整照著我們的意思畫。例如畫成哈士奇在滑雪,或是有柯基和雪山,卻讓牠站在雪地;也可能畫出滑雪板,卻把場景換成公園。
那我們在不重新訓練模型的情況下,
能不能在圖片還沒生成完時,就提醒它往「雪山上滑雪板的柯基」的方向改?
想像你正在畫這張圖,草稿還只有幾條模糊的線,品種、動作與場景都還沒確定;繼續畫下去,就可能出現剛才那幾種結果。旁邊的朋友不必替你畫,只要看看目前的草稿,提醒你「這樣比較像柯基」「這個姿勢比較像在滑雪板」「背景要是雪山」,我們就可以邊畫邊調整,不必等整張畫完才重來。
所以我們需要的,不一定是另一個會生成圖片的模型;一個能判斷「現在這張圖有多符合要求」的模型,也可能提供修改的線索。
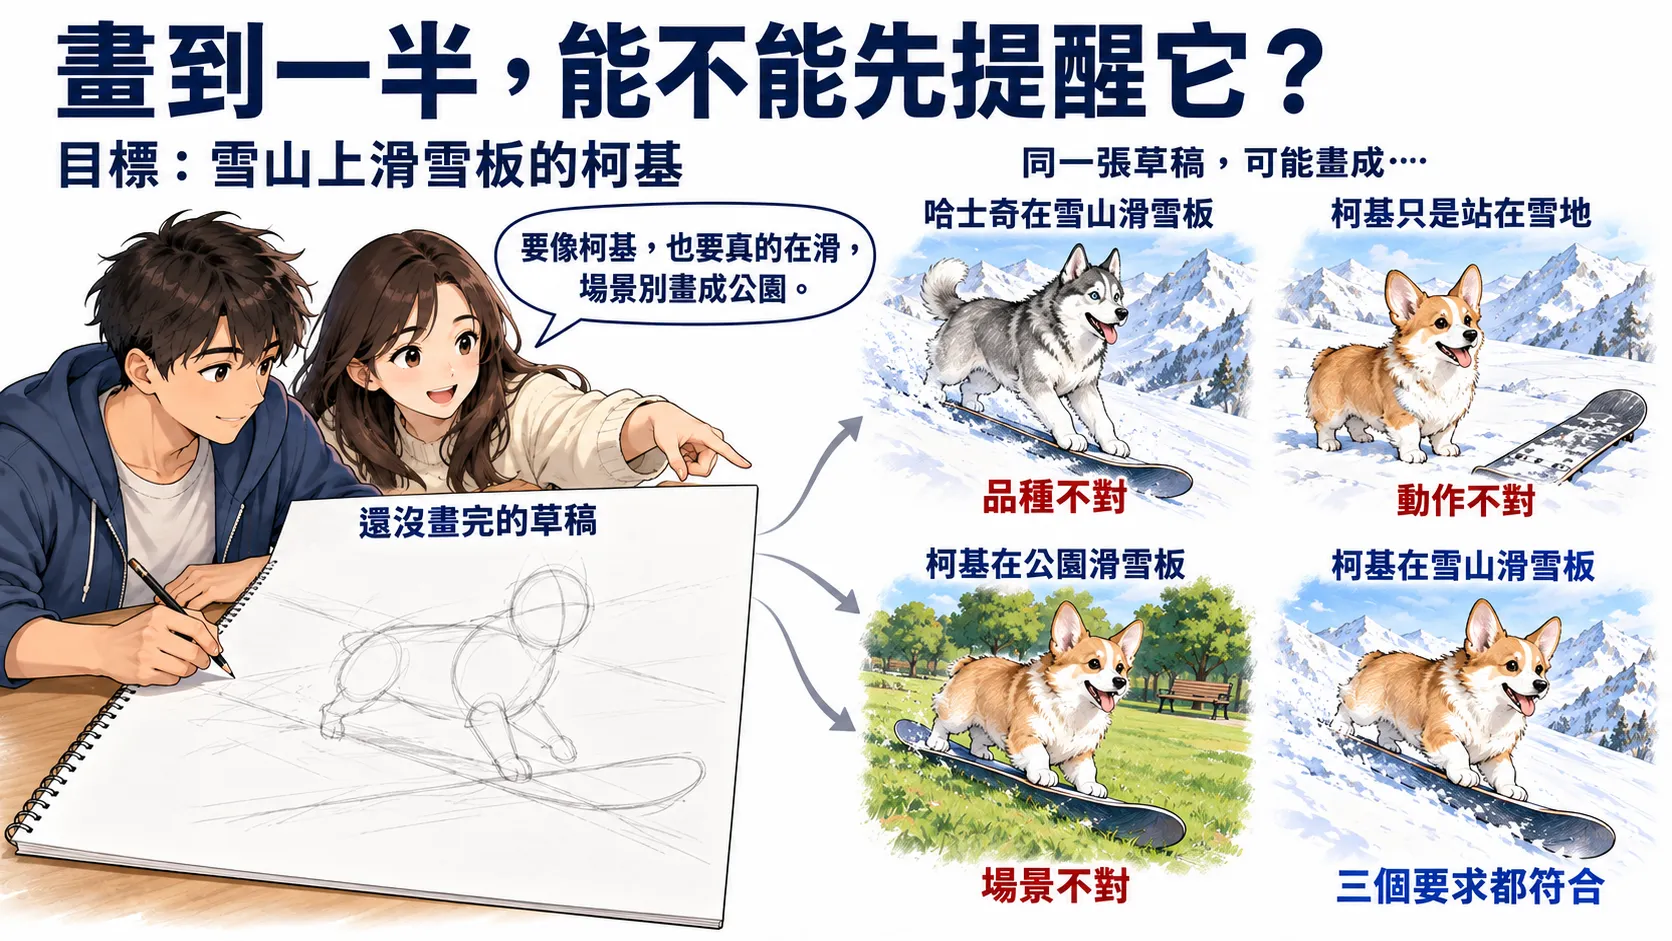
圖:草稿還沒畫完,品種、動作或場景都可能畫錯。朋友在畫的途中提醒,畫圖的人再繼續修改。
我們想生成的,是哪一群照片?
完整的要求包含品種、場景與動作,我們先從其中一項開始:牠是不是柯基? 令 「柯基」。我們想生成的是合理資料中、有柯基的那一群照片,而不只是讓某個評分模型給高分。想像先從相簿挑出所有有柯基的照片;其中仍有各種背景、姿勢與外觀。這一群乾淨照片的 distribution,就是 :固定 ,看照片 如何分布。
不過生成途中拿到的是 noisy image ,不是已經完成的乾淨圖片 。這裡沿用 U1 的時間方向: 越大噪聲越多,sampling 從大的 往 走。若把剛才那群柯基照片都按照 forward process 加噪到時間 ,它們形成的 distribution 就是 。
越大,表示帶有柯基的照片被加噪後,在 附近越密集。若去噪時也維持「柯基」這個條件,我們的目標就是讓這群 noisy images 回到有柯基的照片。依照 U1.3,對應的方向是它的 conditional score:
它指向指定 後,noisy data 的 density 在當下位置上升最快的方向。原本的 unconditional score 則看所有資料,並不特別指定柯基。指定「柯基」後,原本的方向到底多了什麼?
把這次要求提供的方向找出來
要比較這兩支方向,我們可以先看看它們對應的 densities 有什麼關係。沒錯!又是使用 Bayes rule 的時候:
右邊先保留所有 noisy images 的 density ,再乘上 ——也就是「看到目前這張帶噪聲的圖 ,它原本來自有柯基(類別 )的圖片的機率」。分母 是資料中這個類別的比例,讓相乘後的 density 積分為 ;它不隨圖片 改變。
和 不同:前者固定「柯基」,想看帶噪聲的圖片怎麼分布;後者固定目前帶噪聲的圖片,判斷它有多可能來自有柯基的照片。
先取 log,把乘法拆成加法:
接著固定 與 ,對 微分。最後一項是常數(與 無關),因此 gradient 為零:
第一項保留原本資料 density 的方向,第二項增加指定類別的影響。它們可以相加,不只是因為都是向量,而是因為 Bayes rule 中的乘法,取 log 後變成了加法。
那第二項怎麼讀呢?因為 log 不改變機率高低的順序, 指出:在小小的改動幅度下,往哪裡改動目前圖片,能讓它來自柯基的 log-probability 上升得最快。就像朋友指出目前的輪廓往哪裡改,會更像柯基。微分的對象是目前圖片 ,不是模型參數。
把這支 conditional score 放進 U1 的 reverse dynamics,才對應從 noise 回到指定類別的資料。現在問題變得更具體了:
這支 condition 額外提供的方向,
我們能從哪裡取得?
補充有了 conditional score,就一定抽到正確的 conditional distribution 嗎?
想像只拿相簿裡的柯基照片,按照 U1 的 forward process 一路加噪到 。最後那群 noisy images 的分布,就是 。若要把這串分布的變化原樣倒走,不只每一步的方向要對,還要從這個加噪後的分布出發;換了起始分布,就不能直接套用「會回到原本 」的結果。
那為什麼實作時可以從 開始?回想 U1 的式子:
當 很小,照片那一項幾乎消失,noise 的係數則接近 。不管原本是柯基還是其他照片,加噪後的分布都接近同一個 standard Gaussian,我們才用它近似 。但只要照片那一項還沒完全消失,兩者就未必相同;這是起始分布的近似誤差。
起點之外,網路估計的 score 可能偏離理想方向;即使方向估得準,有限步 sampler 仍只在選定的幾個時刻計算它,再近似中間怎麼移動,可能漏掉途中方向的變化。
所以 Bayes rule 確認的是兩支精確方向相加,就是所需的 conditional score;它沒有讓起始分布、網路估計與 sampling 的近似自動變成精確。
手上有一個能判斷品種的模型呢?
假設 generative model 原本不接收 ,只能估計所有資料的 base score。於是我們突發奇想找來一個看圖片、判斷狗的品種的模型:給它一張圖,它就估計裡面是柯基、哈士奇或其他品種的機率。這種用來判斷輸入屬於哪個類別的模型,稱為分類器(classifier)。它不需要會畫圖,只需要提供判斷;不過,只判斷品種,也不保證場景與動作都畫對。
我們希望 classifier 去估計剛才的 。因為途中還是 noisy image,一般只看過乾淨圖片的 classifier 未必看得懂;就像朋友若只會辨認完成的畫,卻看不懂草稿,也幫不上生成途中的修改。因此,它必須學過不同 noise levels 下的判斷,輸入也包含時間 。
把這個 classifier 記成 , 是它的參數;generative model 的 則估計 base score。照剛才的 Bayes 等式,生成時可以組合成
這就是 Dhariwal 與 Nichol [1] 使用的 classifier guidance:固定兩個模型,把 classifier 對目前圖片的 gradient 交給 sampler。兩個估計都精確時,這支合成方向就是 conditional score。
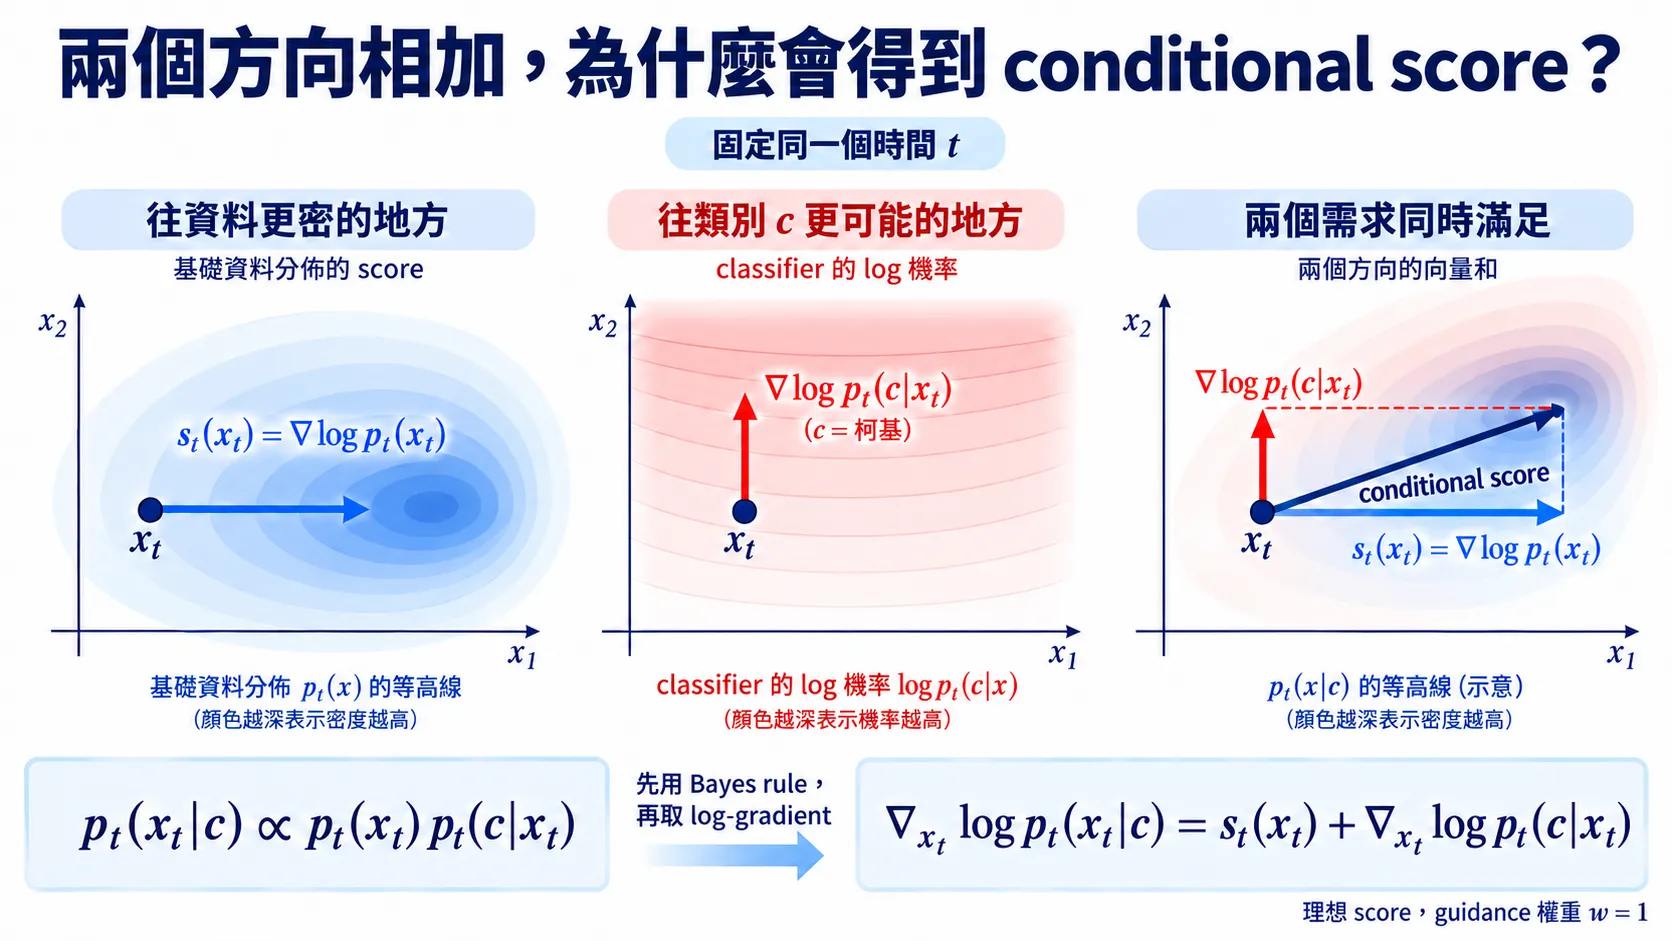
圖:在同一個 ,base score 加上 classifier 的 log-probability gradient。兩者精確時,合成方向就是 conditional score;箭頭與等高線為示意。
補充Noisy classifier 怎麼訓練?
Dhariwal 與 Nichol [1] 從有類別標籤的 training pair 出發,像 U1 一樣抽 與 Gaussian noise ,算出 ,再訓練
是 classifier 對正確類別給的機率。機率越高,負 log 就越小;這個 loss 讓它學不同 noise levels 下的類別機率。高 noise 時資訊不足,答案也可以是不確定的機率,不是要求每張圖都猜中。Expectation 平均資料 pair、抽到的時間與加入的 noise;製造其中的 只需沿用 diffusion 的 forward process,不仰賴 generative model。
補充Sampling 時對 classifier 反向傳播,不就又是在訓練模型嗎?
反向傳播是計算微分的方法,不一定要更新參數。訓練 classifier 時,我們算 並更新 ;sampling 時則固定 與 ,只算 ,把結果交給 sampler 改動 。
就像朋友的判斷方式沒有改變,我們改的是他正在看的草稿。要看的是微分對象與實際更新的量,不是有沒有做反向傳播。
補充把 log-probability 學得準,一階導數也會準嗎?
沿用 U1.0 的地形畫面,把這裡的 log-probability 當成高度:兩片地形的高度接近,不代表坡度也接近。 在地面鋪上一層很小、卻很密的波紋,高度可能只差一點點,坡度卻差很多。同樣地,即使 接近真正的 ,對 微分後的 gradient 仍不一定接近;而 classifier guidance 真正拿來改動圖片的,正是這個一階導數。
這也回到 U1.0 的目標:我們要的是像原本資料的圖片,而不只是讓另一個模型給高分。Kawar、Ganz 與 Elad [3] 因此研究 classifier 的 robustness——圖片受到小幅擾動時,分類判斷是否仍穩定——以及這類 classifier 能否提供更符合人眼理解的 guidance;分類準確率高,本身並沒有保證這件事。
沒有 classifier,能不能只靠模型自己?
這次,我們考慮一個已經做過 U7.0 中 conditional training 的 pretrained model,估計的目標是 conditional score 。它用 配對訓練,預測 中的 noise 時,網路也會收到 ;所以模型原本就能接收類別或文字的 condition。
它已經能 conditional generation,為什麼還要找額外方向?我們這次想進一步控制的是:能不能在 sampling 時,少一些結果的多樣性,換取更高的單張樣本品質? 這是 Ho 與 Salimans 的原論文 [2] 想保留的品質/多樣性取捨,不是讓模型第一次知道 condition。
那我們可不可以不仰賴 classifier,只靠模型自己本身,就取得能加強 condition 的方向? 把同一張草稿交給模型,一次指定柯基,另一次不指定類別;比較兩次修改方向,也許就能看出這個要求額外改變了什麼。
conditional 與 unconditional prediction 的差,
能不能替代 classifier 原本要提供的方向?
我們想找的,是指定「柯基」之後,模型多做了哪些修改,而不是它在有 condition 時給出的整個修改方向。回想剛才從 Bayes rule 得到的關係:
左邊的 conditional score ,是考慮「這張圖要有柯基」後的方向。右邊第一項 是不指定類別時,讓圖片更像原本資料的 base score;第二項才是「這次要柯基」額外提供的方向。也就是說,conditional score 裡已經包含 base score,不是整支方向都只來自「柯基」這個要求。
所以,若想單獨拿到 condition 增加的那一部分,我們就可以在等式兩邊都減去 。右邊的 base score 抵消後,只留下:
回到草稿的例子:先問「如果這張圖要畫柯基,現在該怎麼改?」,再問「如果沒有指定品種,現在該怎麼改?」。把前者減去後者,就是我們想取出的、因為指定柯基而增加的修改。「不指定類別」不是要求沒有柯基,而是仍考慮所有類別的資料。
這裡比較的是同一張 、同一個時間 上的兩個答案,不是兩張生成完的圖片,也不是不同生成階段的方向。兩支 score 都精確時,它們的差就等於 classifier 原本要提供的 gradient;實作時,網路給的是兩支 score 的估計,因此用它們的差來近似這個方向,不必真的訓練 classifier。
不過,剛才的等式告訴我們的是:如果有這兩個答案,就能這樣相減。 它還沒有保證手上的模型會回答兩種情況。假如 training 時每次都把 交給網路,它學過的是「看到 、 和 時該怎麼預測」;現在突然拿掉 ,就換成了訓練時未必見過的輸入。
那麼,要怎麼讓同一個模型,也學會「不指定類別」時的回答?
同一個模型怎麼學會兩種回答?
Ho 與 Salimans [2] 在 training 時偶爾把 換成空 condition ,也就是明確告訴模型「這一次不提供類別或 prompt」。這個做法稱為 conditioning dropout。把實際送進網路的 condition 記成 :有時保留 ,有時換成 。沿用 U1 的 denoising regression,就能寫成
每次仍從 training pair 抽資料,抽 與 noise 算出 ;label 仍是加入的 ,多出的隨機動作只有「要不要把 給模型」。保留 時,它學這個 condition 下的 noise prediction;以與資料無關的機率拿掉 時,它對所有類別的資料學 unconditional prediction。
訓練完後,同一個模型能提供 與 ,再用 U1.3 的換算得到 conditional score 與 unconditional score 。因此,剛才的額外方向可以用
來估計。參數是同一套,但 sampling 時仍需要兩種輸入的模型計算,才取得這兩個答案。 這是後面做法的前提:模型在 training 時就已經學過兩種回答,不是現在才拿掉 ,或重新訓練它。
已經能 conditional generation,為什麼還要 guidance?
現在我們拿到 condition 增加的方向了,接著就可以回到剛才的品質/多樣性問題。如果只想按照 抽樣,理想的 conditional model 已經足夠;guidance 不是 conditional generation 必須多補的一項,而是讓我們選擇另一種 sampling 行為。
想像模型已經會根據「柯基」生成各種照片。但如果這次我們願意少一些變化,希望生成結果的品質更高、品種特徵更容易辨識,能不能不重新訓練,只在 sampling 時調整這個取捨?Ho 與 Salimans [2] 的原論文以 class-conditional ImageNet 模型為例,追求的正是這種控制;並不是因為模型原本不會接收 condition。
我們可以先保留模型原本的 conditional prediction,再沿著剛才找到的差值,多加一段修改。沿用本篇的 convention: 是原本的 conditional prediction,因此額外加強的幅度是 :
時,第二項消失,我們就照原本的 conditional model 生成; 時,才繼續沿著「指定 後多出的方向」加強。這就是 Ho 與 Salimans [2] 提出的 classifier-free guidance(CFG):不用外部 classifier,而是用模型自己的兩種回答完成這個調整。
為了和前面從 unconditional score 出發的寫法對照,我們把括號展開。Conditional score 的係數是 ,unconditional score 的係數則是 。重新合併後,就得到常見的形式:
它先保留 unconditional prediction,再把 condition 造成的差異乘上 。若這支差異改由外部 classifier 估計,就回到前面介紹的 classifier guidance:
忽略 condition; 對應原本的 conditional prediction; 則刻意加強 condition。兩種方法用的是同一個 Bayes 關係,差在用什麼來估計這支方向。Classifier-free 拿掉的是外部 classifier,不是 training 時的 condition。
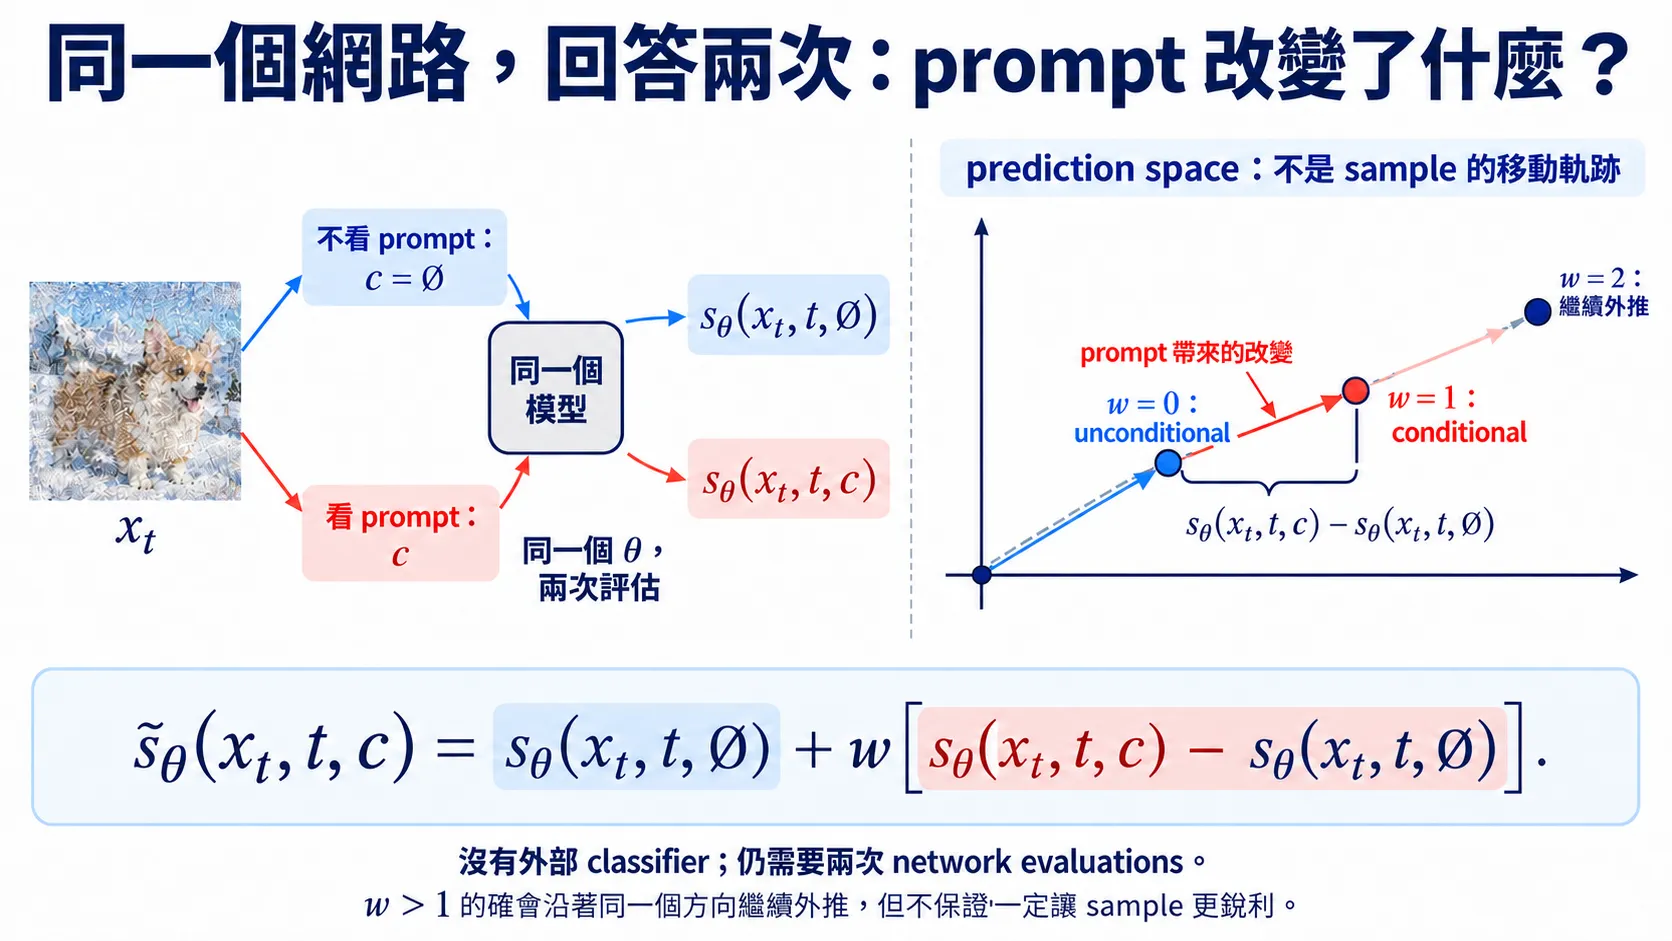
圖:同一套 對相同 noisy state 回答兩次,CFG 再沿兩個 prediction 的差值外推。右圖是 prediction space,不是生成軌跡。
課堂提問Q1
如果 已經對應 conditional score,把 調大,是不是代表 condition 估得更準?
先想一想,再展開看整理後的答案
不是。 對應理想的 conditional score; 則刻意讓 condition 對 sampling 的影響比 training distribution 裡更強,不是在修正成更精確的估計。
Dhariwal 與 Nichol [1]、Ho 與 Salimans [2] 的實驗都討論了生成品質與 diversity 的取捨:提醒變強,可能讓結果更集中在符合要求的樣本,也可能失去其他合理答案。差值中的估計誤差也會被放大;過大的 guidance 還可能造成過度飽和或不自然的紋理。 是 sampling 時的選擇,不是模型準確率的刻度。
補充 對應的是哪一個 density?
若每個 的 score 估計都精確,
最後一行用了 Bayes rule;兩個括號中的量只差一個與 無關的 factor,所以 log-gradient 相同。 在固定的 上對類別機率做 power reweighting;但這一族重新加權的 densities 未必滿足原 forward process 的演化方程,不能只靠這個 identity 宣稱 sampler 的終點一定是 的正規化版本。
網路輸出的是 noise,怎麼放進原本 sampler?
U1 的網路通常輸出 ,而不是直接輸出 score。令 表示該時刻的 noise amplitude,U1.3 給出的換算是
Conditional 與 unconditional prediction 都使用同一個 。我們只要把剛才的 guided score 寫成 ,就能把兩種做法換成原 sampler 使用的 noise prediction。
對 classifier guidance,先代入:
兩邊乘上 ,得到
classifier gradient 在 score 空間是相加;換到 noise prediction 空間後,就變成從 減掉它。負號與縮放都來自這個換算,不是另一個 sampling 假設。
對 CFG,三支 score 都有相同的 factor,代入後可寫成
同樣乘上 ,這次相同的 factor 全部消去:
生成時把對應的 放進原本 sampler 就好。整個 sampling 過程中,generative model 的 ,以及外部 classifier 若存在時的 ,都不需要更新。
補充原 CFG 論文的 guidance strength 和這裡差了
本篇使用 是 unconditional、 是 conditional 的 convention。Ho 與 Salimans [2] 則把「超出 conditional 的強度」記成 ,其 noise prediction 寫成
兩者是同一個組合,只是本篇的 。閱讀其他論文或程式時,要對照公式,而不是只比較 guidance scale 的數字。
Classifier guidance 也可以加在已經 conditional training 的 model 上,如 Dhariwal 與 Nichol [1] 的實驗。這時原本就有 conditional score,classifier 提供的是額外加強,因此「不額外加強」的係數從 起算;不能直接套用本篇從 unconditional score 出發、 才得到 conditional score 的說法。
補充Negative prompt 改變的是哪個比較基準?
實作上還可以把空 condition 換成一個 negative prompt ,例如希望避免的「模糊」。同一個模型分別看正向 prompt 與 ,再做
這條式子從 的 prediction 出發,沿著兩者的差往 外推。它提供的是相對基準,不是保證某個物件絕不出現的禁止清單;也不再是剛才 conditional 減 unconditional 的 Bayes identity。
補充Flow Matching 也能學兩種回答嗎?
Classifier guidance 與 CFG,實際上差在哪裡?
兩種方法都能在 sampling 時調整 condition 的影響。依照 Dhariwal 與 Nichol [1]、Ho 與 Salimans [2] 的做法,我們可以把差異整理成:
| 項目 | Classifier guidance | CFG |
|---|---|---|
| 額外模型 | 需訓練 noisy classifier,估計 。 | X |
| Conditioning 訓練 | X | 需要 conditional training+unconditional training(conditioning dropout)。 |
| 每一步 sampling | ||
| 用在模型沒看過的新 condition | 可以透過另外訓練或更換 noisy classifier。 | X |
| 主要優點 | 生成與判斷可分開設計。 | 不需額外 classifier 或其 gradient。 |
| 主要限制 | 額外訓練成本;classifier 估計的 準,不代表 gradient 也準。 | 訓練時要考慮兩種 prediction;差值誤差也可能放大。 |
表中的 conditioning 訓練指 generative model;classifier 仍需有類別標籤的資料。這裡的新 condition 指模型沒有相應 conditional prediction 的要求,不是 text-to-image 模型沒見過的一句新 prompt。
不用 classifier,不代表 sampling 一定更快。 一邊多算 classifier 的 gradient,另一邊多算一種 generative-model prediction;實際成本要看模型大小與實作。兩者加強 guidance 時,也都可能犧牲 diversity,不是強度越大就一定越好。
消化一下
參考文獻
- Dhariwal, P., Nichol, A. Diffusion Models Beat GANs on Image Synthesis. NeurIPS 2021.(Classifier guidance 與 fidelity/diversity trade-off。)
- Ho, J., Salimans, T. Classifier-Free Diffusion Guidance. 2022.(CFG、conditioning dropout 與 quality/diversity trade-off。)
- Kawar, B., Ganz, R., Elad, M. Enhancing Diffusion-Based Image Synthesis with Robust Classifier Guidance. 2022.(Classifier gradient 的 robustness。)