
U7.3 Reward 只會打分、不會給方向,還能怎麼引導?
本篇重用3 篇
只知道結果好不好,沒有「往哪裡走」
在 U7.2 中,我們希望高 reward 的結果更常出現,但仍保留 base distribution 中合理的資料,因此定義了 。若 reward 可以微分,還能用去噪結果近似途中該往哪裡改動。
但很多 reward 比較像一位評審:作品完成後,他能打出 0 到 10 分,卻說不出每一個 pixel、token 或分子座標該往哪裡移。人類偏好、外部模擬器、compiler 是否通過、碰撞檢查與 hard constraint 都可能是這種 black-box reward。
下面我們會先考慮 base pretrained model 已經學到最理想的 ;實作時,我們會將它換成模型真正學到的 distribution 。至於 model error 如何影響 steering,會作為補充放在最後。那麼我們現在的問題是:
如果 Reward 只能比較候選資料的好壞時,
我們怎麼改變 sampling 方式來讓結果變得更像 ?
不知道怎麼改,那多畫幾張呢?
想像我們請模型畫一張符合這次要求的圖片。評審看完後,只說這張圖有幾分,卻無法告訴我們該改哪裡。既然不知道怎麼修改,那最自然的想法就是:再畫幾張,讓評審比較,最後留下分數最高的那張。
把這個做法寫成數學,就是先抽 個獨立樣本 ,再輸出
也就是先找出分數最高的編號 ,再回傳那個樣本。這就是 Best-of-:評審只需要替完成的作品打分,不需要 reward gradient,也不改每一條 sampling path。
因此,Best-of- 的 sampling pipeline,就是從 生成 張候選、用 評分,再留下最高分的 :
Best-of-:一次 sampling
數學 pipeline
Pseudocode
輸入:候選數 N、base_sampler、reward R
輸出:一個完成品 x_out

for i = 1, ..., N:
  x[i] ← base_sampler()       # 從 p_data 獨立生成
  score[i] ← R(x[i])

i_star ← argmax_i score[i]
x_out ← x[i_star]
return x_out
這裡每次輸出一張圖片。我們會把整個 pipeline 獨立重複 次,每次都重新生成 張候選。把第 次留下的圖片記成 ,最後收集成一個 sample set:
是每次拿來比較的候選數, 是最後收集的輸出數。這個 set 中各種結果出現的比例,形成我們觀察到的 empirical distribution;我們希望它接近目標 distribution 。 那麼,反覆使用 Best-of- 得到的 ,真的會呈現我們想要的分布嗎?
挑最高分,就等於抽到 嗎?
Best-of- 可以提高每次留下的作品分數,但我們要檢查的是 的分布。只看誰的 reward 最大,並沒有要求不同結果出現的比例符合 。 我們可以沿用作品與評審的情景,把這個差別算出來。
先假設模型只會畫出 三種作品,原本出現的機率相同,也就是 。評審給它們的分數經過 轉成 reward weights,分別是 。所以目標 希望三種作品的比例是 ;例如
分子是 原本的機率乘上 reward weight,分母把三種作品的加權機率加起來。這裡的 是 reward 決定的倍率,不是評審的原始分數。
但如果每次只畫兩張,也就是 Best-of-,只要其中有 ,它就會贏。兩張都不是 的機率是 ,因此每次輸出 是 的機率為
所以,把這個 pipeline 重複很多次, 中 的比例會逐漸穩定在 ,而不是目標的 。因此增加重複次數 ,並不會越來越靠近 。 既然不對,那我們應該怎麼修正呢?
不要只看最好,能不能按照 reward weight 的比例來抽選?
回到評審面前已經畫好的三張作品。若它們的 reward weights 是 ,我們可以讓三張作品分別有 的機率被選中,而不是每次只留最高分。這個動作想做的是:候選仍由原模型生成,但選擇時補上它在 target 中應該增加的相對權重。
為什麼該補的權重是 ?候選原本從 抽出,原本常出現的作品已經比較容易進入候選集合。現在要改成 ,因此在 的位置,我們看的是「目標 density 除以原本抽樣的 density」:
是 U7.2 中讓 正規化的常數,對所有候選都相同。因此比較相對權重時可以消去它,不需要重新計算 。原本的 base probability 由候選出現的頻率反映,選擇時再乘 reward weight。 用 target 與原抽樣 distribution 的比值修正樣本貢獻,正是 importance sampling 的核心;這裡我們的具體做法是先替候選解做 importance weighting,然後再按權重重新抽樣。
補充Importance sampling 的具體數學形式
令 是我們想平均的量,例如作品的 reward 。若 在 下的絕對期望有限,我們想計算 ,但手上能直接抽的是 。由於 是以 為 base 的 tilt,可以把期望改寫成
第一個等號是在期望的積分裡乘上並除以 ,把原本對 target 的平均換成對 base 的加權平均;第二個等號代入正文剛得到的 density 比值。抽樣的來源換成 base,但每個結果的貢獻要乘上 target/base 的比值。
由 的正規化條件,。因此,從 base 獨立抽出 個候選後,可以用樣本平均估計分子與分母,得到
分子把每個候選的 乘上 reward weight,分母則用同一批候選的權重總和做正規化;兩個樣本平均中的 相除後消去。這個有限樣本的比值估計稱為 self-normalized importance sampling;它通常有有限樣本偏差,不能把上面的近似號換成等號。
這個公式直接給出的是加權平均,不必真的抽出一張圖片。正文則再按 normalized weights 選出候選,將權重用在 sampling 的輸出上。
我們試著將演算法寫下來:把第 張候選 的正權重記成 ,並把它除以這一批所有候選的權重總和:
是第 張作品應增加的倍率; 才是在這一批候選中選中它的機率,且 。因此我們以機率 選第 張,輸出 。剛才三張作品的例子,就是 對到 。
因此,固定這一批候選後,sampling pipeline 就是:
IW:一次 sampling
數學 pipeline
Pseudocode
輸入:候選數 N、base_sampler、reward R、強度 lambda
輸出:一個完成品 x_out

for i = 1, ..., N:
  x[i] ← base_sampler()       # 從 p_data 獨立生成
  omega[i] ← exp(lambda * R(x[i]))

omega_bar ← omega / sum(omega)
i ← 按機率 omega_bar[1:N] 抽出一個候選編號
x_out ← x[i]
return x_out
最後一行的 是以機率 抽出的候選編號,而不是 。前面的候選生成相同,改的是最後留下哪張圖片的規則。
每次重新生成候選、按這些機率選出一張,再獨立重複 次,得到的 sample set 記成 。它和 的差別,是 pipeline 最後一步從 argmax 換成隨機選擇。這是在有限候選上近似 ,不是有限 下就精確抽到 。 增加 能看清這個規則的輸出分布;要改善有限候選對 target 的近似,則要讓每次的候選更充分地涵蓋 base distribution,例如增加 。
不過,不管最後挑最高分還是按權重抽樣,每張作品都得完整畫完,才能使用這次評分。 生成 張作品,就要付出 次完整生成與 次評分的成本。U7.0 已算過:若符合要求的機率是 ,至少命中一次的機率就是 。例如 、 時也只有約 ;rare target 需要很多候選。
如果有些草稿畫到一半就已經不太有希望,還要把它們全部畫完嗎?能不能更早估計哪一張草稿有希望,把後續計算分給那些候選?
能不能讓比較有希望的候選繼續生成?
沿用剛才畫圖的情景,我們可以同時畫幾張草稿,畫到一半時先估計它們最後可能得到的結果,再決定哪些繼續畫。比較有希望的多留幾份,較沒希望的停止,把接下來的計算分給留下來的草稿。
但評審原本只能評完成品。畫到一半時,我們可以先請模型猜最後會畫成什麼,也就是對目前的 noisy state 算去噪估計,再讓評審打分;也可以試著把這張草稿完成幾次,對那些結果的 reward weights 取平均。這時得到的是對未來結果的估計,還不是最後的 reward。
若三張草稿在這一段應乘上的正權重是 ,就沿用剛才按權重抽樣的做法,每次以 的機率抽一張,允許重複抽到同一張,抽出三張後繼續畫。第三張可能被抽到不只一次,也可能保留其他草稿;若後續生成有隨機性,同一張草稿的複本還能畫出不同結果。這些中途估計要怎麼變成「這一段應乘的權重」,我們稍後再檢查。
把生成中的候選稱為 particle,同時保留 個; 是途中保留的候選數,和剛才完整生成後才挑選的 分開記。沿用 U1 的時間方向,選幾個檢查點 ,其中 是生成被切成的段數。 表示時間 上第 個 particle 的狀態;從 走到 ,做三件事:
- Propagate: 每個 particle 用原 reverse sampler 從 走到 ,記住新位置與它的來路。
- Weight: 替這一段算出正權重 。上標 指候選,下標 指這一段抵達的 checkpoint;它是這一段新增的倍率。
- Resample: 用 當選中機率,允許重複地抽出 個候選,再繼續生成。
第 個候選平均會被抽到 次,所以高權重者平均有更多複本繼續生成。三張草稿的例子裡,平均複本數是 ;真正抽到的份數是整數,不是照這個平均硬切。
這就是 Sequential Monte Carlo(SMC) 的基本操作。這裡先假設每個 checkpoint 都 resample,抽出的 個 particles 重新具有相同權重 ;我們改的是哪些候選有後代,不是模型的參數。走到 後,從最後的 個 particles 中等機率選一個作為 。把整趟生成獨立重複 次,便得到 ,再檢查它的分布是否接近 。
課堂提問Q1
既然要把計算集中到高 reward 區域,每個 checkpoint 都只保留當下分數最高的 particle,再把它複製成 份,不是最有效率嗎?
先想一想,再展開看整理後的答案
這樣會很快失去 diversity,而且越早期越危險。高 noise 時,一個 particle 的 clean outcome 還有很多可能;當下看起來最好的 denoised estimate,未必是最後 reward 最高的那條路。
若每次只留下最大值,第一次判斷稍微偏掉,所有 particles 就會變成同一個祖先。後面即使還有很多 network evaluations,也只是在很窄的區域重複搜尋。這個現象叫 particle degeneracy。
SMC 使用 normalized weights 做隨機 resampling,而不是只複製冠軍;但權重很集中時,仍可能只剩少數祖先,所以這個做法也不能完全防止退化。
此外,複製後若使用有隨機性的 sampler,後代仍有機會分開探索;若沿同一個 deterministic ODE 走,完全相同的複本會繼續走同一條路,需要另外設計能保留 target 的探索動作。複製份數本身不等於新增不同候選。
所以 particles 的目的不是每一步都立刻選出贏家,而是在集中計算與保留多種可能未來之間取得平衡。
即使保留了不同候選,還有一個問題:這一段的權重到底要怎麼算,才能讓最後的結果近似我們要的 ?
每走一段都乘權重,會不會重複計算?
剛才我們用去噪估計或幾次試畫,估計一張草稿最後的 reward 權重。把時間 、狀態 上的這個正估計記成 。我們可以參考 U7.2 中對所有可能乾淨結果平均 reward weight 的 ,但這裡的便宜估計不要求等於那個精確平均。
但若每走一段就把 再乘一次,同一個高分訊號就會被重複計算。比較自然的做法是只乘新舊估計的比值:例如估計從 變成 ,這一段新增的倍率是 ,不是再乘一次 。於是定義這一段的權重函數,也稱為 potential:
分子是走完這一段後對未來的估計,分母是走之前的估計; 把兩者換成這一段應乘的倍率。把第 個 particle 的新舊狀態代進去,就得到 SMC 使用的 ,再由它算出 resampling 機率 。
我們希望整條路最後只被乘上 ,所以取 、。中間的 可以使用便宜的估計;把各段相乘,就看到它們前後消去:
每個中間估計 都在一段的分子、另一段的分母各出現一次,所以相除後只剩終點 與起點 。 表示開始時不另加權; 則使用完成品真正的 reward weight。
這樣,所有抵達同一個 的 base paths,都只乘上它的 terminal reward weight。把途中狀態積分掉後,終點就是我們要的 。中途估計影響有限計算怎麼分配;在這個構造裡,它不改變理想的 terminal target。
剛才 SMC 的 weight 與 resample,延續了 IW 的想法:補上目標與實際抽樣方式之間的相對權重,再按權重抽選。但只說「使用 SMC」,還沒有指定每一段要近似什麼 target,也還沒有回答這些中途權重累積後會得到什麼終點分布。
這種用 potentials 重新加權路徑的架構,稱為 Feynman–Kac(FK)model。它讓我們把「中途怎麼加權」與「最後想抽到哪裡」連在一起:設計各段 ,檢查它們的乘積是否保留指定的 terminal reward tilt,再用 SMC 去近似這個 target。 沿用畫草稿的例子,我們先檢查一路偏向哪些草稿,最後會不會變成想要的作品比例,再用有限草稿實際執行抽樣。
先把「應占多少比例」寫下來。令 表示原 sampler 的路徑分布, 表示從 到 的整組 checkpoint 狀態。FK model 定義加權後的路徑分布 :
是讓總質量等於 的 normalizing constant,這裡假設它有限且非零。第二行用了剛才 potentials 的消去;把途中狀態積分掉,便得到終點的 。這個 target 的定義裡沒有 particle 數 ,也還沒有真的抽出任何圖片。
那 SMC 真正拿來重抽的 weight,和 FK 的 potential 有什麼關係?令 是原 sampler 走這一段的 transition density, 是實際提出新狀態的 proposal density。沿用每個 checkpoint 都 resample 的設定,上一段的 particles 已有相同權重;這一段的 importance weight 可寫成 [1]
表示這一段 target 相對於 base path 應增加的倍率;後面的 density ratio 則補償「實際從 proposal 抽,而不是從 base transition 抽」的差別,正是 IW 的校正。Proposal 必須涵蓋加權後會有質量的區域。正文使用原 sampler 作為 proposal,所以 ,比值是 ,才得到 。 因此 FK 的 potential 與 SMC 的抽樣 weight 有明確關係,但改動 proposal 後不能把兩者直接當成同一個量。
SMC 使用這些 weights 做 propagate、weight、resample,產生最後的 個 particles。每個 checkpoint 都重抽後,它們有相同權重,因此用它們表示的終點分布是
表示把全部質量放在第 張完成品上的 point mass;例如要算某類圖片的比例,就是數這 張裡有幾張屬於那一類,再除以 。所以 是 FK 指定的路徑 target, 是 SMC 實際算出的隨機近似。有限 時,particles 可能共享祖先,這個近似也不會自動等於 。
那麼論文裡的 FK steering 呢?Singhal 等人 [1] 用這個名稱描述把 FK 構造用在 diffusion 引導的整套 framework:設計中途 reward 估計與 potentials,檢查它們如何保留 terminal target,再用 SMC 等 particle 方法近似加權後的分布。正文的 是其中一種構造;論文也探討其他 potentials、proposal 與重抽時機。FK steering 的 particle 實作可以使用 SMC,因此兩者描述的是同一套方法中的不同層級。
Kim、Kim 與 Park 的 DAS(Diffusion Alignment as Sampling) [2] 也使用 SMC,但著重以 reward tempering 設計中途 targets,逐步增加 reward 的影響。即使沒有使用 FK 這個名稱,也可以從已指定的中途 targets 推導正確的 SMC weights;FK 提供的是把這些設計放回加權路徑分布、檢查 terminal target 的統一表述。
如果一篇論文把 FK 與 SMC 分開介紹,可以先依「target/potentials 的構造」與「particle 抽樣演算法」這兩層來讀;若它把 FK steering 列成一個方法名稱,則要看該方法選了哪些 potentials、proposal 與重抽時機。不能僅由名稱推論兩者使用互斥的抽樣機制。
把剛才的步驟串起來,就是下面這個 SMC sampler。這裡使用原 sampler 作為 proposal,並在每個 checkpoint 按 FK 的增量權重重抽;數學版顯示一段的操作,pseudocode 把整個 段迴圈寫出來。
SMC:使用 FK 增量權重
數學 pipeline
是第 次重抽選中的候選編號,選中 的機率是 ;每次獨立抽編號,所以可以重複選中同一個候選。對 重複這個 pipeline,最後從 的 個 particles 中等機率選一個,輸出 。
Pseudocode
輸入:particle 數 M、檢查點 t[K] > ... > t[0] = 0
    原 sampler 的起點抽樣與 base_step、正估計 H[0:K]
條件:H[K](x) = 1;H[0](x) = exp(lambda * R(x))
輸出:一個完成品 x_out

for i = 1, ..., M:
  x[i] ← 原 sampler 的起點抽樣()

for k = K, ..., 1:
  old ← x                    # 保留走之前的狀態
  for i = 1, ..., M:
      candidate[i] ← base_step(old[i], t[k], t[k-1])
      omega[i] ← H[k-1](candidate[i]) / H[k](old[i])

  omega_bar ← omega / sum(omega)
  for m = 1, ..., M:
      ancestor[m] ← 按 omega_bar 抽一個編號(可重複)
  x ← candidate[ancestor[1:M]]
  # 所有重抽後的 particles 都重新具有相同權重 1/M

i ← 從 1, ..., M 等機率抽一個編號
x_out ← x[i]
return x_out分清楚增加 particles ,和重複生成 次差在哪裡?
SMC 的近似可以用「圖片上的統計量」來檢查。令 是我們想平均的一個有界函數,例如某類圖片的指示函數。在固定 checkpoints、正確的權重與適當的可積分性條件下,SMC 的一致性表示 [1, 2]
左邊平均的是這一趟生成後的 張完成品,右邊則是 target 下的平均;「依機率」表示兩者的差超過任意固定容許值的機率會趨近 。若 是指示函數,這就是某類圖片的 empirical 比例趨近 target 比例。這個極限不要求同一趟的 particles 彼此獨立。
增加 是讓每一趟 SMC 更充分地近似 FK target;增加 則是把固定 的 sampler 獨立重跑,看清它的輸出分布。 只增加 不會消除有限 帶來的偏差。另一方面,若 potentials 的乘積已不是 ,改變的是 FK target 本身;增加 也不會替我們修正這個目標。
補充一定要每一段都 resample 嗎?
不必。常用 effective sample size(ESS)量權重有多集中:
等權重時 ESS 是 ;一個權重接近 時,ESS 則接近 。可以等它低於某個門檻才 resample。若這一輪不 resample,下輪須保留舊權重,再乘新增的 ,而不是每段都從等權重重新開始。
能不能直接改抽哪些起點?
除了在途中重抽候選,還有另一個想法,是沿用原本的生成規則,改抽哪些起點。Q1 已經看到:若同一張草稿往後總會畫成同一個結果,複製更多份也不會增加不同答案。那我們能不能回到生成之前,讓會畫出高分作品的起點更常被抽到?
沿用 U6.0,把 deterministic generator 記成 ,它將起點 送成完成品 ;原本抽起點的 density 是 ,也就是 。一旦 決定,生成的圖片也就決定了。因此,每個起點都有一個可以計算的分數 ;我們可以把資料端的 reward weight 放回起點,定義
是我們現在想抽的起點 distribution: 保留原本起點的相對密度, 則提高會生成高分結果的起點權重。若從 收集到起點 ,資料端收集的樣本就是 。把同一個 用在這些起點上,就得到以 generator 的 output law 為 base 的 reward tilt;不需要先計算資料端的 density。但這個 target 寫得出來,還不表示我們已經知道怎麼從 抽樣。
但只在高 reward 區域附近找,可能一直找到相似的答案。我們可以同時考慮幾個強度 :小的 比較不受 reward 的影響,可以盡可能在原本模型有可能生成的資料中探索;我們通常會搭配比較大的修正步伐,來做 exploration。大的 則偏向在已經得到的高分結果附近做小幅度修正,通常搭配比較小的修正步伐,來做 refinement。Wang 等人的 Source Parallel Tempering(SPT) [3] 就在 source space 同時探索這些 targets:
這裡 是不同強度的編號,第 個 target 使用 。每一條 chain 是一連串 source 候選:從目前的 提出新起點 ,生成 並計算 ,再依新舊 target 權重決定接受它,還是留在 。接受時下一個狀態是 ,拒絕時則仍是 ;不是永遠選高分者,而是用機率接受或拒絕,使這個 Markov transition 保留 。這類抽樣稱為 Markov chain Monte Carlo(MCMC)。
接著,不同強度的 chains 也可以交換候選,讓較容易探索的 chain 把結果帶到目標強度 。交換同樣有接受機率,不能想換就換。SPT 不需要 reward gradient,但每個新起點都要經過生成與評分;有限搜尋也不代表已充分探索 target。
補充接受新起點與交換候選,為什麼不改掉指定 target?
先看一種簡單的 local proposal: 提出 和反向提出的機率相同。Metropolis 接受機率就是新舊 target 的比值,超過 時取 :
Normalizing constant 在比值中消去。這裡比較的是 prior 乘 reward weight,不是只比較 reward;對稱 proposal 配上這個接受機率,正反向的 probability flux 相等,因此保留 。非對稱 proposal 則還要乘反向與正向的 proposal 機率比。
再看兩條 chains 的交換。強度為 、目前位置為 ,它們的 joint target 是兩個 targets 的乘積。交換前後取比值, 因子互相消去,得到
在對稱選擇交換 pair 的情況下,這個機率保留各 chain targets 的乘積。Local sampling 與交換都保留它,並不表示有限步就已到達它;還要檢查 chains 是否探索到不同高分區域。
下面把正文的對稱 local proposal 版本寫成兩種表示。設共有 條 chains,第 條使用 ,其中 是我們要的目標強度。Pseudocode 中的 reward[j] 儲存 ,接受新起點或交換 chains 時也一起更新。
SPT:一次 local update 與交換
數學 pipeline
箭頭後的 表示該操作完成後的目前位置。重複這個 pipeline 後,從強度為 的目標 chain 收集起點,再用 得到完成品。兩種接受機率使用前面補充中的公式;這些 MCMC 輸出可能相關,有限次更新也不代表已充分探索 target。
Pseudocode
輸入:L 條 chains 的起點 z[1:L] 與 reward[1:L]
    強度 lambda[1:L](lambda[L] = 目標 lambda)
    source density p_Z、G、R、對稱的 local proposal
條件:reward[j] = R(G(z[j]))
輸出:更新後的 z[1:L]、reward[1:L]

for j = 1, ..., L:
  z_proposed ← symmetric_proposal(z[j])
  reward_proposed ← R(G(z_proposed))
  accept ← min(1, p_Z(z_proposed) / p_Z(z[j])
      * exp(lambda[j] * (reward_proposed - reward[j])))
  if Uniform(0, 1) < accept:
      z[j] ← z_proposed
      reward[j] ← reward_proposed

(a, b) ← 隨機選一對相鄰 chains(選擇不依賴目前位置)
swap_accept ← min(1, exp((lambda[a] - lambda[b])
  * (reward[b] - reward[a])))
if Uniform(0, 1) < swap_accept:
  交換 z[a], z[b]
  交換 reward[a], reward[b]

return z[1:L], reward[1:L]
# 重複更新並探索後,從目標 chain 輸出 G(z[L])
還有哪些方法可以參考?
除了前面介紹的做法,還有很多方法可以在沒有 reward gradient 的情況下引導生成。我們把這些方法列在最後,給有興趣的讀者繼續看。
回到 SMC 畫草稿的情景,我們用權重決定哪些草稿繼續畫,並檢查了這些權重如何保留終點 target。現在換一個問題:其他草稿除了被留下或被淘汰,能不能參考目前最好的那張,修改自己接下來的畫法?
想像評審挑出一張最有希望的草稿,其他人保留自己的畫,但參考那張草稿預計完成的結果來修改。我們仍然不知道 reward 的微分方向,卻可以比較候選,從它們的差異提出一個改動方向。
把這個動作寫成數學,仍然同時保留 個 particles。時間 上第 個狀態是 ,模型對它的完成品預測是 ;這不是已經生成完的 。先替這些預測打分,再選出當下評分最高的編號
也就是用第 張的去噪結果作為參考。對第 張來說, 是「從自己的預測完成品,移到最好預測完成品」的向量;我們希望沿這個向量改動它。每個 checkpoint 都重新評分,所以 也可能改變。Kim 等人把這種用最好候選引導其他 particles 的做法稱為 Best-of- Guidance(BoNG) [4];這裡仍用 表示途中候選數。
沿用 U1 的 VP 符號,。固定目前的 ,去噪估計的改動就是 score 改動的 倍;因此想把 clean estimate 往冠軍拉,就能換算出要加入的 score,再用 換回 noise prediction:
其中 是原模型的 noise prediction, 是加入引導後交給 sampler 的 prediction; 控制位移的強度,並非原模型參數。括號是剛才的完成品位移, 則把它換成 U1 的 noise prediction 改動。 時沿用原 prediction; 時,固定目前 所算出的新去噪估計會對到最好候選。
因此,BoNG 的動作是比較 → 用完成品位移修改 → 讓各個 繼續生成。它用候選的差異提出方向,不需要對 reward 微分;但這裡沒有像 FK 那樣檢查 terminal weighting 是否等於 ,所以也不自動保證最後收集的樣本近似 。
把這個操作寫成兩種表示如下。Pseudocode 裡的 x_hat[i] 對到 ,epsilon_guided[i] 對到 ;sampler_step 則是讓原 sampler 使用這個改過的 prediction 走一步。
BoNG:一個 reverse step
數學 pipeline
使用正文的位移公式計算。 提供參考完成品,但全部 個候選仍各自走下一步;對每個 的 reverse step 重複這個操作,直到抵達 。
Pseudocode
輸入:目前的 M 個狀態 x[1:M]、時刻 t > 0、下一時刻 t_next
    noise model epsilon_theta、VP schedule、R、強度 w_B
輸出:下一時刻的 M 個狀態 x_next[1:M]

for i = 1, ..., M:
  epsilon[i] ← epsilon_theta(x[i], t)
  x_hat[i] ← (x[i] - sigma(t) * epsilon[i]) / sqrt(alpha_bar(t))
  score[i] ← R(x_hat[i])

i_star ← argmax_i score[i]
for i = 1, ..., M:
  displacement ← x_hat[i_star] - x_hat[i]
  epsilon_guided[i] ← epsilon[i]
      - w_B * sqrt(alpha_bar(t)) / sigma(t) * displacement
  x_next[i] ← sampler_step(x[i], t, t_next, epsilon_guided[i])

return x_next[1:M]補充BoNG 的位移怎麼換成 U1 的 noise prediction?
令 表示要加到 base score 的方向。固定 ,Tweedie 的 affine 換算給出
若希望左邊等於 ,就得到
最後 ,正是正文的式子。原文 [4] 使用 signal amplitude 為 的 Gaussian kernel;這裡保留 ,是為了換成 U1 的 VP 表示,而不是把兩套 noise schedule 混用。 時,改過的去噪估計剛好等於冠軍。
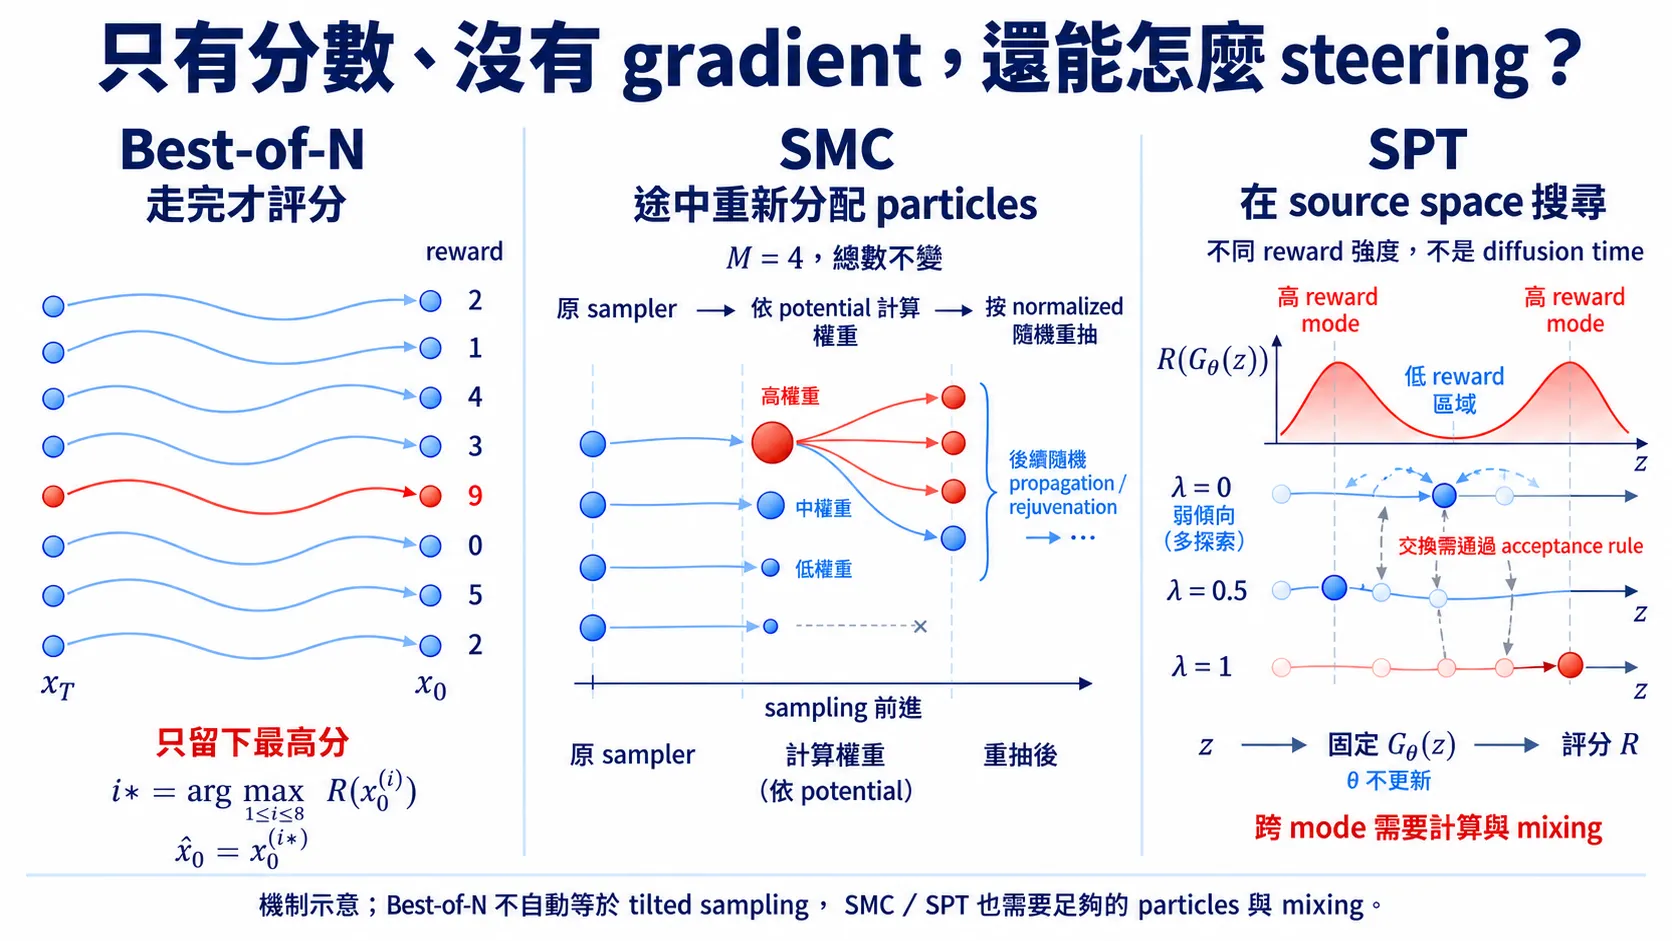
圖:Best-of- 在終點挑選;SMC 按 normalized weights 重抽 particles;SPT 在 source space 提案與交換。後兩者示意 sampling 機制,不表示有限計算下已精確抽到 。
這些方法的差別可以縮成一張表:
| 方法 | Reward 在哪裡使用? | 主要好處 | 主要限制 |
|---|---|---|---|
| Best-of- | 完整樣本的終點 | 最單純、完全 model-agnostic | rare target 需要很大的 |
| Importance weighting + resampling | 完整樣本的終點 | 用 target/base 比值校正候選的選中機率 | 有限 仍是近似,每張候選都要生成完 |
| FK steering/DAS | 多個中間 checkpoints | 途中重新分配 compute | 需要設計 intermediate potentials,可能 particle degeneracy |
| SPT | deterministic generator 的 source space | gradient-free,能用 tempering 跨越 modes | 每個 proposal 都要生成並評分 |
| BoNG | reverse diffusion 的 particle population | Best sample 能在途中影響其他 particles | 不是自動等於 exact tilted sampling |
消化一下
補充Base model 的誤差會如何影響 steering?
正文先假設 base pretrained model 已經學到 。實作時,若模型真正學到的是 ,同樣的 terminal reward weighting 會把 正規化成新的 distribution。也就是說,即使 steering 的抽樣近似已經足夠準確,它逼近的仍是以 為 base 的 reward tilt。 原本較少生成的資料,乘上 reward weight 後仍可能不足;若某個區域在 base distribution 下的機率是零,重新加權也不能讓它出現。因此,提高 reward 並不保證消除原本的 model error。
若還使用有限步的 sampler,base 更精確地說是該 sampler 實際產生的 output distribution,其中也包含離散化帶來的偏差。這與有限 candidates、particles 或 MCMC 搜尋造成的抽樣誤差不同:增加 steering 的計算,可以改善後者的近似,卻不會自動把 base 換成真實的 。
參考文獻
- Singhal, R. et al. A General Framework for Inference-time Scaling and Steering of Diffusion Models. ICML 2025.(FK steering 與 interacting particles。)
- Kim, S., Kim, M., Park, D. Test-time Alignment of Diffusion Models without Reward Over-optimization. 2025.(DAS、SMC 與 reward tempering。)
- Wang, S.-H. et al. Test-Time Guidance for Flow-Based Generative Models via Parallel Tempering on Source Distributions. ICML 2026.(Source Parallel Tempering。)
- Kim, R. L. et al. Best-of- Guidance for Test-time Diffusion Alignment. 2026.(BoNG;近期 preprint。)