學完這篇,你能
從「reward 高又像資料」推出 tilted distribution。 將 entropy 與 log density 一起考慮,推得 p R ( x 0 ) ∝ p d a t a ( x 0 ) e λ R ( x 0 ) p_R(x_0)\propto p_{\mathrm{data}}(x_0)e^{\lambda R(x_0)} p R ( x 0 ) ∝ p data ( x 0 ) e λ R ( x 0 ) 寫出 noisy state 上真正需要的 guidance。 從所有可能的乾淨結果出發,推導 p t R ( x t ) = p t ( x t ) h t ( x t ) / Z R p_t^R(x_t)=p_t(x_t)h_t(x_t)/Z_R p t R ( x t ) = p t ( x t ) h t ( x t ) / Z R h t h_t h t 分清 exact tilt 與常見 plug-in approximation。 說出對 R ( x ^ 0 ) R(\hat x_0) R ( x ^ 0 ) ∇ log h t \nabla\log h_t ∇ log h t
本篇重用 3 篇 一個高分樣本,還是一個高分 distribution?
在 U7.1 中,我們用外部 classifier 的判斷,或模型「有 condition」與「沒有 condition」的兩個回答,調整生成方向。但假如模型訓練完後,我們才拿到一個美感評分程式,它只能看完成的圖片並打分,既沒有對應的 noisy classifier,也沒有 conditional prediction,該怎麼辦?
我們把這個打出的分數記成 R ( x 0 ) R(x_0) R ( x 0 ) reward :輸入是乾淨資料,而輸出是一個數字,數字越大代表越符合這次的要求。它不一定要是個機率,也不一定能微分。
我們首先要釐清的是:它應該如何改變我們想抽的 distribution? 這才能幫助我們決定 sampling 可以怎麼做。
我們一方面希望 reward 越高越好,但又不能只顧 reward。若產生出一張 reward model 給滿分、在人眼看來卻完全不像資料的影像,這就不是一個好的 steering。這裡把「生成結果仍像原本的資料、保有合理的特徵與結構」這個要求稱為 data fidelity 。如果用數學的語言說,我們同時在乎
reward function R ( x 0 ) R(x_0) R ( x 0 )
log density log p d a t a ( x 0 ) \log p_{\mathrm{data}}(x_0) log p data ( x 0 )
補充 為什麼使用 log density,而不直接用 density? 回想 L5.0 中的 maximum likelihood。若乾淨樣本 x 0 ( 1 ) , … , x 0 ( n ) x_0^{(1)},\ldots,x_0^{(n)} x 0 ( 1 ) , … , x 0 ( n ) p d a t a p_{\mathrm{data}} p data p θ p_\theta p θ
L ( θ ) = ∏ i = 1 n p θ ( x 0 ( i ) ) , log L ( θ ) = ∑ i = 1 n log p θ ( x 0 ( i ) ) . \begin{aligned}
L(\theta)&=\prod_{i=1}^n p_\theta(x_0^{(i)}),\\
\log L(\theta)&=\sum_{i=1}^n\log p_\theta(x_0^{(i)}).
\end{aligned} L ( θ ) log L ( θ ) = i = 1 ∏ n p θ ( x 0 ( i ) ) , = i = 1 ∑ n log p θ ( x 0 ( i ) ) . log 把乘法變成加法,而且不改變最大 likelihood 的解。 因為 log 嚴格遞增,arg max θ L ( θ ) = arg max θ log L ( θ ) \arg\max_\theta L(\theta)=\arg\max_\theta\log L(\theta) arg max θ L ( θ ) = arg max θ log L ( θ )
再除以樣本數,就從整批 likelihood 變成每筆資料的平均表現:
1 n log L ( θ ) = 1 n ∑ i = 1 n log p θ ( x 0 ( i ) ) ≈ E x 0 ∼ p d a t a [ log p θ ( x 0 ) ] . \begin{aligned}
\frac1n\log L(\theta)
&=\frac1n\sum_{i=1}^n\log p_\theta(x_0^{(i)})\\
&\approx\mathbb E_{x_0\sim p_{\mathrm{data}}}[\log p_\theta(x_0)].
\end{aligned} n 1 log L ( θ ) = n 1 i = 1 ∑ n log p θ ( x 0 ( i ) ) ≈ E x 0 ∼ p data [ log p θ ( x 0 )] . 這個 expectation 固定真實資料的分布,平均它們在模型下的 log density;若 log density 可積分,隨著獨立樣本數增加,左邊的平均會逼近右邊。它還有一個統計上的意義:在相關期望有限時,展開 KL 的定義可得
E p d a t a [ log p θ ( x 0 ) ] = E p d a t a [ log p d a t a ( x 0 ) ] − D K L ( p d a t a ∥ p θ ) . \begin{aligned}
&\mathbb E_{p_{\mathrm{data}}}[\log p_\theta(x_0)]\\
&\quad=\mathbb E_{p_{\mathrm{data}}}[\log p_{\mathrm{data}}(x_0)]\\
&\qquad-D_{\mathrm{KL}}(p_{\mathrm{data}}\|p_\theta).
\end{aligned} E p data [ log p θ ( x 0 )] = E p data [ log p data ( x 0 )] − D KL ( p data ∥ p θ ) . 第一項與 θ \theta θ
但 log 的單調性不能直接穿過期望值 :E [ log p θ ( x 0 ) ] \mathbb E[\log p_\theta(x_0)] E [ log p θ ( x 0 )] E [ p θ ( x 0 ) ] \mathbb E[p_\theta(x_0)] E [ p θ ( x 0 )] A , B A,B A , B 0.9 : 0.1 0.9:0.1 0.9 : 0.1 q , 1 − q q,1-q q , 1 − q
目標(對真實資料取平均) 最佳 q q q 平均 probability 0.9 q + 0.1 ( 1 − q ) 0.9q+0.1(1-q) 0.9 q + 0.1 ( 1 − q ) 1 1 1 平均 log probability 0.9 log q + 0.1 log ( 1 − q ) 0.9\log q+0.1\log(1-q) 0.9 log q + 0.1 log ( 1 − q ) 0.9 0.9 0.9
前者只希望 q q q 真實會出現、卻被模型分配極低機率的事件,會受到 log 很強的懲罰。
這裡的 MLE 固定資料分布、調整模型 p θ p_\theta p θ p d a t a p_{\mathrm{data}} p data
用 λ > 0 \lambda>0 λ > 0 一個點 ,可以最大化 λ R ( x 0 ) + log p d a t a ( x 0 ) \lambda R(x_0)+\log p_{\mathrm{data}}(x_0) λ R ( x 0 ) + log p data ( x 0 ) p ~ \widetilde p p
要讓整個 distribution 同時偏向高 reward、
把 data fidelity、reward 與 diversity 放進同一個 objective
最自然的嘗試,是比較不同 distributions 生成的結果,哪一個平均表現最好。想像我們反覆從 p ~ \widetilde p p λ R ( x 0 ) + log p d a t a ( x 0 ) \lambda R(x_0)+\log p_{\mathrm{data}}(x_0) λ R ( x 0 ) + log p data ( x 0 )
所以,我們要找的是讓整批平均分數最高的 p ~ \widetilde p p
max p ~ E x 0 ∼ p ~ [ λ R ( x 0 ) + log p d a t a ( x 0 ) ] . \max_{\widetilde p}\;
\mathbb E_{x_0\sim \widetilde p}
\big[\lambda R(x_0)+\log p_{\mathrm{data}}(x_0)\big]. p max E x 0 ∼ p [ λ R ( x 0 ) + log p data ( x 0 ) ] . 這裡 R R R p d a t a p_{\mathrm{data}} p data λ \lambda λ p ~ \widetilde p p x 0 x_0 x 0
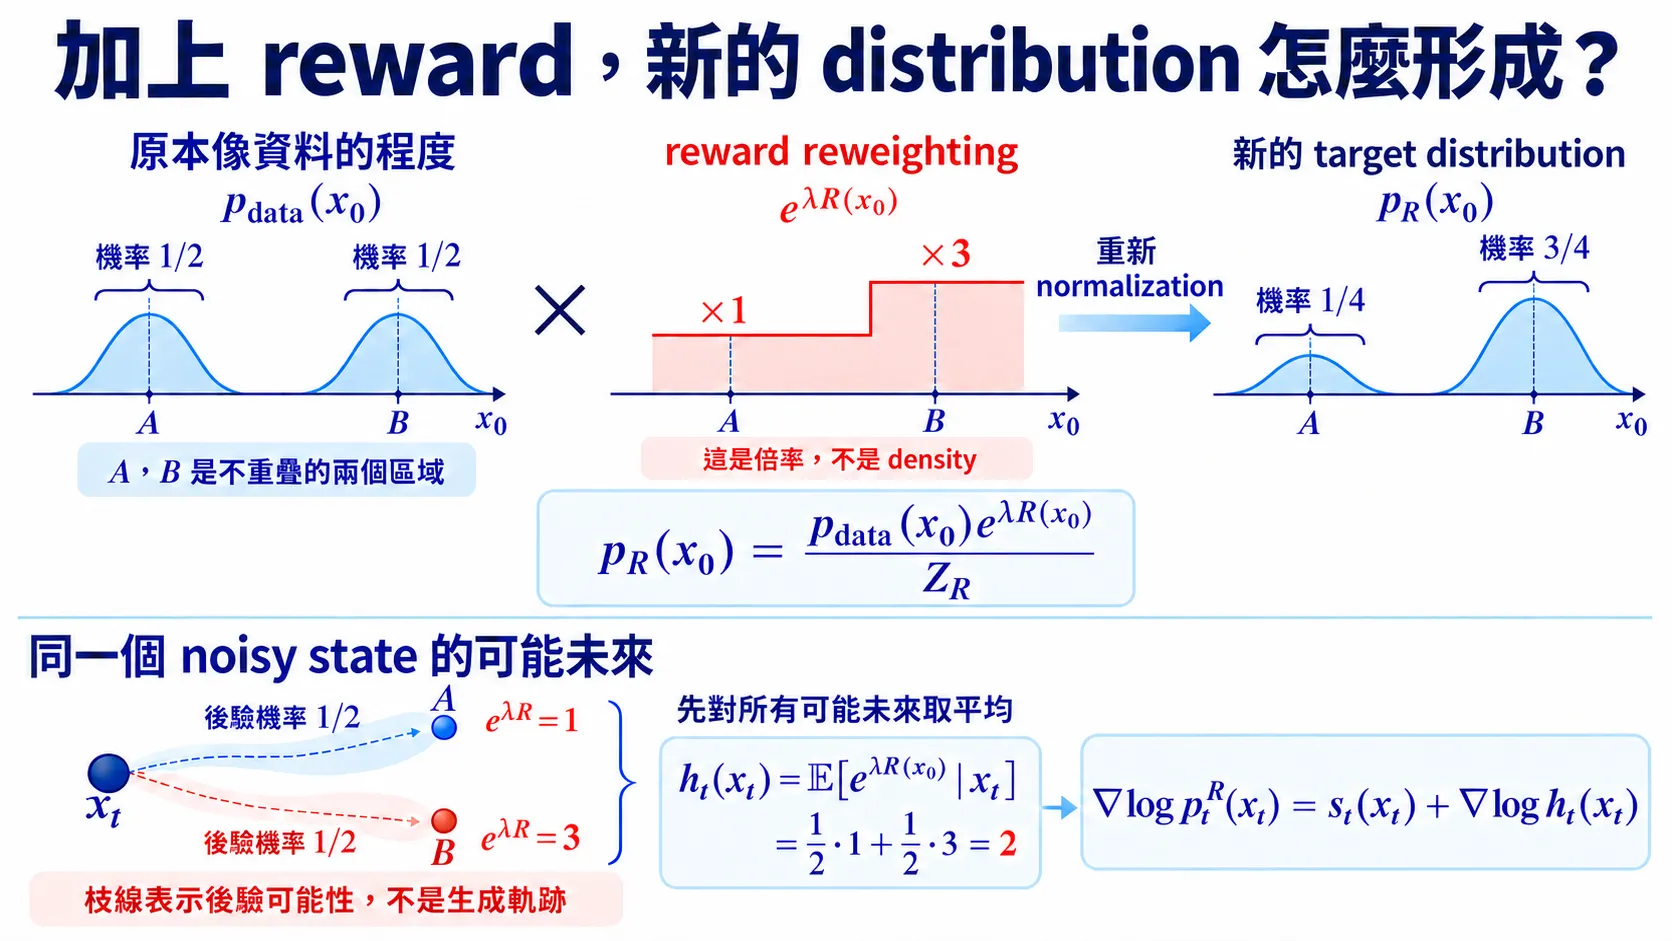
先把相簿簡化成兩張都合理的照片 A A A B B B 1 / 2 1/2 1/2 0 0 0 1 1 1 q q q B B B
( 1 − q ) ( 0 + log 1 2 ) + q ( λ + log 1 2 ) = − log 2 + λ q . \begin{aligned}
&(1-q)(0+\log\tfrac12)\\
&\quad+q(\lambda+\log\tfrac12)\\
&=-\log2+\lambda q.
\end{aligned} ( 1 − q ) ( 0 + log 2 1 ) + q ( λ + log 2 1 ) = − log 2 + λ q . 只要 λ > 0 \lambda>0 λ > 0 q q q B B B 兩張照片原本都合理,但這個 objective 沒有要求保留另一個答案。
少掉的要求是不要過度集中。我們用 entropy H ( p ~ ) = − E p ~ [ log p ~ ( x 0 ) ] H(\widetilde p)=-\mathbb E_{\widetilde p}[\log \widetilde p(x_0)] H ( p ) = − E p [ log p ( x 0 )]
max p ~ E p ~ [ λ R ( x 0 ) + log p d a t a ( x 0 ) ] + H ( p ~ ) . \max_{\widetilde p}\;
\mathbb E_{\widetilde p}\big[\lambda R(x_0)+\log p_{\mathrm{data}}(x_0)\big]
+H(\widetilde p). p max E p [ λ R ( x 0 ) + log p data ( x 0 ) ] + H ( p ) . 因為 expectation 是 linear 的,把 entropy 展開後,三項可以放進同一個 log:
E p ~ [ λ R ( x 0 ) + log p d a t a ( x 0 ) ] + H ( p ~ ) = E p ~ [ log p d a t a ( x 0 ) e λ R ( x 0 ) p ~ ( x 0 ) ] . \begin{aligned}
&\mathbb E_{\widetilde p}\big[\lambda R(x_0)+\log p_{\mathrm{data}}(x_0)\big]+H(\widetilde p)\\
&\qquad=\mathbb E_{\widetilde p}\left[
\log\frac{p_{\mathrm{data}}(x_0)e^{\lambda R(x_0)}}{\widetilde p(x_0)}
\right].
\end{aligned} E p [ λ R ( x 0 ) + log p data ( x 0 ) ] + H ( p ) = E p [ log p ( x 0 ) p data ( x 0 ) e λ R ( x 0 ) ] . 分子已經告訴我們如何重新加權:原本的 data density 乘上 e λ R ( x 0 ) e^{\lambda R(x_0)} e λ R ( x 0 ) 1 1 1 Z R Z_R Z R
Z R = ∫ p d a t a ( x 0 ) e λ R ( x 0 ) d x 0 , p R ( x 0 ) = 1 Z R p d a t a ( x 0 ) e λ R ( x 0 ) . Z_R=\int p_{\mathrm{data}}(x_0)e^{\lambda R(x_0)}\,\mathrm dx_0,
\qquad
p_R(x_0)=\frac{1}{Z_R}p_{\mathrm{data}}(x_0)e^{\lambda R(x_0)}. Z R = ∫ p data ( x 0 ) e λ R ( x 0 ) d x 0 , p R ( x 0 ) = Z R 1 p data ( x 0 ) e λ R ( x 0 ) . 把 p d a t a e λ R = Z R p R p_{\mathrm{data}}e^{\lambda R}=Z_Rp_R p data e λ R = Z R p R
E p ~ [ log p d a t a e λ R p ~ ] = log Z R + E p ~ [ log p R p ~ ] = log Z R − D K L ( p ~ ∥ p R ) . \begin{aligned}
\mathbb E_{\widetilde p}\left[
\log\frac{p_{\mathrm{data}}e^{\lambda R}}{\widetilde p}
\right]
&=\log Z_R+\mathbb E_{\widetilde p}\left[\log\frac{p_R}{\widetilde p}\right]\\
&=\log Z_R-D_{\mathrm{KL}}(\widetilde p\|p_R).
\end{aligned} E p [ log p p data e λ R ] = log Z R + E p [ log p p R ] = log Z R − D KL ( p ∥ p R ) . Z R Z_R Z R λ \lambda λ p ~ \widetilde p p 0 < Z R < ∞ 0<Z_R<\infty 0 < Z R < ∞ p ~ = p R \widetilde p=p_R p = p R
p R ( x 0 ) = 1 Z R p d a t a ( x 0 ) e λ R ( x 0 ) . \boxed{
p_R(x_0)=\frac{1}{Z_R}p_{\mathrm{data}}(x_0)e^{\lambda R(x_0)}
}. p R ( x 0 ) = Z R 1 p data ( x 0 ) e λ R ( x 0 ) . 我們把原本的 data density p d a t a ( x 0 ) p_{\mathrm{data}}(x_0) p data ( x 0 ) e λ R ( x 0 ) e^{\lambda R(x_0)} e λ R ( x 0 ) Z R Z_R Z R p R ( x 0 ) p_R(x_0) p R ( x 0 ) Reward 越高,乘上的係數就越大;但新的相對權重仍由 p d a t a ( x 0 ) e λ R ( x 0 ) p_{\mathrm{data}}(x_0)e^{\lambda R(x_0)} p data ( x 0 ) e λ R ( x 0 ) 這個做法稱為 exponential tilting 或 reward tilting 。
回到剛才兩張照片的例子,tilting 後的相對權重成為 1 : e λ 1:e^\lambda 1 : e λ B B B e λ / ( 1 + e λ ) e^\lambda/(1+e^\lambda) e λ / ( 1 + e λ ) λ \lambda λ A A A
這裡的 p d a t a p_{\mathrm{data}} p data p θ p_\theta p θ
課堂提問 Q1
既然我們在乎的就是 reward 與 log density,把 entropy H ( p ~ ) H(\widetilde p) H ( p )
先想一想,再展開看整理後的答案 拿掉 entropy 後,objective 對 p ~ \widetilde p p F ( x 0 ) = λ R ( x 0 ) + log p d a t a ( x 0 ) F(x_0)=\lambda R(x_0)+\log p_{\mathrm{data}}(x_0) F ( x 0 ) = λ R ( x 0 ) + log p data ( x 0 )
max p ~ E p ~ [ F ( x 0 ) ] \max_{\widetilde p}\ \mathbb E_{\widetilde p}[F(x_0)] p max E p [ F ( x 0 )] 在離散情況會把全部 mass 放到 F F F
剛才 A A A B B B 只最大化平均分數,不會得到正文的 p R p_R p R
補充 同一個 tilted distribution,在論文裡還有哪些常見寫法? 先把正文的 objective 展成三項。固定 reward、base distribution 與 λ > 0 \lambda>0 λ > 0 p ~ \widetilde p p
max p ~ λ E p ~ [ R ( x 0 ) ] + E p ~ [ log p d a t a ( x 0 ) ] + H ( p ~ ) . \begin{aligned}
\max_{\widetilde p}\quad
&\lambda\mathbb E_{\widetilde p}[R(x_0)]\\
&+\mathbb E_{\widetilde p}[\log p_{\mathrm{data}}(x_0)]\\
&+H(\widetilde p).
\end{aligned} p max λ E p [ R ( x 0 )] + E p [ log p data ( x 0 )] + H ( p ) . 下面的比較沿用正文的條件:相關期望與 entropy 有限,且 0 < Z R < ∞ 0<Z_R<\infty 0 < Z R < ∞
KL-regularized reward maximization:
這個寫法把「原本的 log density」與「新 distribution 的 entropy」合成一個 KL 項。把 KL 的定義展開,就看得到:
D K L ( p ~ ∥ p d a t a ) = E p ~ [ log p ~ ( x 0 ) p d a t a ( x 0 ) ] = − H ( p ~ ) − E p ~ [ log p d a t a ( x 0 ) ] . \begin{aligned}
&D_{\mathrm{KL}}(\widetilde p\|p_{\mathrm{data}})\\
&\quad=\mathbb E_{\widetilde p}\left[
\log\frac{\widetilde p(x_0)}{p_{\mathrm{data}}(x_0)}
\right]\\
&\quad=-H(\widetilde p)\\
&\qquad-\mathbb E_{\widetilde p}[\log p_{\mathrm{data}}(x_0)].
\end{aligned} D KL ( p ∥ p data ) = E p [ log p data ( x 0 ) p ( x 0 ) ] = − H ( p ) − E p [ log p data ( x 0 )] . 因此,正文後兩項就是 − D K L ( p ~ ∥ p d a t a ) -D_{\mathrm{KL}}(\widetilde p\|p_{\mathrm{data}}) − D KL ( p ∥ p data ) λ \lambda λ p ~ \widetilde p p
max p ~ E p ~ [ R ( x 0 ) ] − 1 λ D K L ( p ~ ∥ p d a t a ) . \begin{aligned}
\max_{\widetilde p}\quad
&\mathbb E_{\widetilde p}[R(x_0)]\\
&-\frac1\lambda D_{\mathrm{KL}}(\widetilde p\|p_{\mathrm{data}}).
\end{aligned} p max E p [ R ( x 0 )] − λ 1 D KL ( p ∥ p data ) . 所以它不是另外一個目標:正文的「log density + entropy」,正好就是限制新 distribution 偏離 base 的 KL penalty。 λ \lambda λ 1 / λ 1/\lambda 1/ λ
Constrained formulation:
另一個問法是:先指定「最多能偏離 base 多少」,再在這個範圍內提高 reward。用 δ ≥ 0 \delta\ge0 δ ≥ 0
max p ~ E p ~ [ R ( x 0 ) ] 條件: D K L ( p ~ ∥ p d a t a ) ≤ δ . \begin{aligned}
\max_{\widetilde p}\quad
&\mathbb E_{\widetilde p}[R(x_0)]\\
\text{條件:}\quad
&D_{\mathrm{KL}}(\widetilde p\|p_{\mathrm{data}})\le\delta.
\end{aligned} p max 條件: E p [ R ( x 0 )] D KL ( p ∥ p data ) ≤ δ . 要把限制放進 objective,可以用 1 / λ 1/\lambda 1/ λ Lagrange multiplier ,也就是限制的懲罰係數,扣掉 1 λ ( D K L − δ ) \frac1\lambda(D_{\mathrm{KL}}-\delta) λ 1 ( D KL − δ )
E p ~ [ R ( x 0 ) ] − 1 λ D K L ( p ~ ∥ p d a t a ) + δ λ . \begin{aligned}
&\mathbb E_{\widetilde p}[R(x_0)]\\
&\quad-\frac1\lambda D_{\mathrm{KL}}(\widetilde p\|p_{\mathrm{data}})\\
&\quad+\frac\delta\lambda.
\end{aligned} E p [ R ( x 0 )] − λ 1 D KL ( p ∥ p data ) + λ δ . 對固定的 λ , δ \lambda,\delta λ , δ p ~ \widetilde p p δ \delta δ λ \lambda λ
一個具體的對應是取 δ = D K L ( p R ∥ p d a t a ) \delta=D_{\mathrm{KL}}(p_R\|p_{\mathrm{data}}) δ = D KL ( p R ∥ p data ) p R p_R p R p ~ \widetilde p p
E p ~ [ R ( x 0 ) ] ≤ E p R [ R ( x 0 ) ] + 1 λ ( D K L ( p ~ ∥ p d a t a ) − δ ) ≤ E p R [ R ( x 0 ) ] . \begin{aligned}
\mathbb E_{\widetilde p}[R(x_0)]
&\le\mathbb E_{p_R}[R(x_0)]\\
&\quad+\frac1\lambda\bigl(
D_{\mathrm{KL}}(\widetilde p\|p_{\mathrm{data}})-\delta
\bigr)\\
&\le\mathbb E_{p_R}[R(x_0)].
\end{aligned} E p [ R ( x 0 )] ≤ E p R [ R ( x 0 )] + λ 1 ( D KL ( p ∥ p data ) − δ ) ≤ E p R [ R ( x 0 )] . 第一個不等式是把前一種 objective 的最佳性移項;第二個用到 D K L ≤ δ D_{\mathrm{KL}}\le\delta D KL ≤ δ p R p_R p R p R p_R p R
Bayesian posterior:
假如手上只有一張模糊照片 y y y x 0 x_0 x 0 y y y p ( y ∣ x 0 ) p(y\mid x_0) p ( y ∣ x 0 ) λ = 1 \lambda=1 λ = 1
R ( x 0 ) = log p ( y ∣ x 0 ) . R(x_0)=\log p(y\mid x_0). R ( x 0 ) = log p ( y ∣ x 0 ) . 現在把這個選擇代進正文的 tilted density,而不是另外假設一個 posterior:
p R ( x 0 ) ∝ p d a t a ( x 0 ) e R ( x 0 ) = p d a t a ( x 0 ) p ( y ∣ x 0 ) ∝ p ( x 0 ∣ y ) . \begin{aligned}
p_R(x_0)
&\propto p_{\mathrm{data}}(x_0)e^{R(x_0)}\\
&=p_{\mathrm{data}}(x_0)p(y\mid x_0)\\
&\propto p(x_0\mid y).
\end{aligned} p R ( x 0 ) ∝ p data ( x 0 ) e R ( x 0 ) = p data ( x 0 ) p ( y ∣ x 0 ) ∝ p ( x 0 ∣ y ) . 第二行用 e log p ( y ∣ x 0 ) = p ( y ∣ x 0 ) e^{\log p(y\mid x_0)}=p(y\mid x_0) e l o g p ( y ∣ x 0 ) = p ( y ∣ x 0 ) base distribution 在這裡是 prior,reward 的指數變成 measurement likelihood。 正文的 normalization 也變成
Z R = ∫ p d a t a ( x 0 ) p ( y ∣ x 0 ) d x 0 = p ( y ) . \begin{aligned}
Z_R
&=\int p_{\mathrm{data}}(x_0)p(y\mid x_0)\,\mathrm dx_0\\
&=p(y).
\end{aligned} Z R = ∫ p data ( x 0 ) p ( y ∣ x 0 ) d x 0 = p ( y ) . 因此在 0 < p ( y ) < ∞ 0<p(y)<\infty 0 < p ( y ) < ∞ p R ( x 0 ) = p ( x 0 ∣ y ) p_R(x_0)=p(x_0\mid y) p R ( x 0 ) = p ( x 0 ∣ y ) y y y c c c
RLHF:
把情境換成語言模型。RLHF(Reinforcement Learning from Human Feedback)用人類偏好提供 reward 訊號;固定一個 prompt 後,x 0 x_0 x 0 p r e f p_{\mathrm{ref}} p ref policy ,我們要調整的 policy 仍記成 p ~ \widetilde p p
Ouyang 等人 [4] 的目標包含提高 reward、同時限制偏離 reference policy 的部分。以我們的符號寫成
max p ~ E p ~ [ R ( x 0 ) ] − β D K L ( p ~ ∥ p r e f ) , β > 0. \begin{aligned}
\max_{\widetilde p}\quad
&\mathbb E_{\widetilde p}[R(x_0)]\\
&-\beta D_{\mathrm{KL}}(\widetilde p\|p_{\mathrm{ref}}),
\qquad\beta>0.
\end{aligned} p max E p [ R ( x 0 )] − β D KL ( p ∥ p ref ) , β > 0. 用前面展開的 KL 定義,再把整個 objective 除以 β \beta β
max p ~ 1 β E p ~ [ R ( x 0 ) ] + E p ~ [ log p r e f ( x 0 ) ] + H ( p ~ ) . \begin{aligned}
\max_{\widetilde p}\quad
&\frac1\beta\mathbb E_{\widetilde p}[R(x_0)]\\
&+\mathbb E_{\widetilde p}[\log p_{\mathrm{ref}}(x_0)]\\
&+H(\widetilde p).
\end{aligned} p max β 1 E p [ R ( x 0 )] + E p [ log p ref ( x 0 )] + H ( p ) . 逐項和最上面的正文 formulation 比較:base 換成 p r e f p_{\mathrm{ref}} p ref λ = 1 / β \lambda=1/\beta λ = 1/ β 因此在理想的分布最佳化下,最佳 policy 同樣滿足 p ~ ( x 0 ) ∝ p r e f ( x 0 ) e R ( x 0 ) / β \widetilde p(x_0)\propto p_{\mathrm{ref}}(x_0)e^{R(x_0)/\beta} p ( x 0 ) ∝ p ref ( x 0 ) e R ( x 0 ) / β
這裡只比較 reward 與 KL 的部分;原論文的 PPO-ptx 還加入預訓練資料項。實際 RLHF 會訓練 policy 的參數,本單元則固定 pretrained model、在 sampling 時 steering;共同的是 objective 的結構,不是訓練與取樣的流程 。
若 reward 可以微分,直接把 gradient 加上去嗎?
在乾淨資料 x 0 x_0 x 0 t = 0 t=0 t = 0 p R p_R p R
∇ x 0 log p R ( x 0 ) = ∇ x 0 log p d a t a ( x 0 ) + λ ∇ x 0 R ( x 0 ) . \nabla_{x_0}\log p_R(x_0)
=\nabla_{x_0}\log p_{\mathrm{data}}(x_0)
+\lambda\nabla_{x_0}R(x_0). ∇ x 0 log p R ( x 0 ) = ∇ x 0 log p data ( x 0 ) + λ ∇ x 0 R ( x 0 ) . 這裡 ∇ x 0 R \nabla_{x_0}R ∇ x 0 R λ = 1 \lambda=1 λ = 1 R ( x 0 ) = log p ( c ∣ x 0 ) R(x_0)=\log p(c\mid x_0) R ( x 0 ) = log p ( c ∣ x 0 )
但 diffusion sampling 大部分時間拿到的是 noisy x t x_t x t x 0 x_0 x 0 要判斷這張草稿值不值得保留,就得一起考慮這些可能結果,而不是假裝它已經是一張完成的圖片。
我們想知道的,是高 reward 的乾淨結果加噪後,會如何分布在這些 x t x_t x t p R p_R p R p t R p_t^R p t R q ( x t ∣ x 0 ) q(x_t\mid x_0) q ( x t ∣ x 0 )
p t R ( x t ) = ∫ q ( x t ∣ x 0 ) p R ( x 0 ) d x 0 . p_t^R(x_t)=\int q(x_t\mid x_0)p_R(x_0)\,\mathrm dx_0. p t R ( x t ) = ∫ q ( x t ∣ x 0 ) p R ( x 0 ) d x 0 . 把 p R p_R p R
p t R ( x t ) = 1 Z R ∫ q ( x t ∣ x 0 ) p d a t a ( x 0 ) e λ R ( x 0 ) d x 0 . (1) p_t^R(x_t)
=\frac{1}{Z_R}\int q(x_t\mid x_0)
p_{\mathrm{data}}(x_0)e^{\lambda R(x_0)}\,\mathrm dx_0.\tag{1} p t R ( x t ) = Z R 1 ∫ q ( x t ∣ x 0 ) p data ( x 0 ) e λ R ( x 0 ) d x 0 . ( 1 ) 接下來,我們希望把目標 density p t R p_t^R p t R p t p_t p t p t p_t p t p t R p_t^R p t R
我們可以先在積分裡乘除 p t ( x t ) p_t(x_t) p t ( x t ) q ( x t ∣ x 0 ) p d a t a ( x 0 ) q(x_t\mid x_0)p_{\mathrm{data}}(x_0) q ( x t ∣ x 0 ) p data ( x 0 )
q ( x t ∣ x 0 ) p d a t a ( x 0 ) p t ( x t ) = p ( x 0 ∣ x t ) . (2) \frac{q(x_t\mid x_0)p_{\mathrm{data}}(x_0)}{p_t(x_t)}
=p(x_0\mid x_t).\tag{2} p t ( x t ) q ( x t ∣ x 0 ) p data ( x 0 ) = p ( x 0 ∣ x t ) . ( 2 ) p ( x 0 ∣ x t ) p(x_0\mid x_t) p ( x 0 ∣ x t ) 看到目前的 noisy state x t x_t x t x 0 x_0 x 0 這是對乾淨來源的 conditional density,也叫 posterior density 。
有了它,如果想估計目前這個 x t x_t x t x 0 x_0 x 0 R ( x 0 ) R(x_0) R ( x 0 ) p ( x 0 ∣ x t ) p(x_0\mid x_t) p ( x 0 ∣ x t )
E [ R ( x 0 ) ∣ x t ] = ∫ R ( x 0 ) p ( x 0 ∣ x t ) d x 0 . \mathbb E[R(x_0)\mid x_t]
=\int R(x_0)p(x_0\mid x_t)\,\mathrm dx_0. E [ R ( x 0 ) ∣ x t ] = ∫ R ( x 0 ) p ( x 0 ∣ x t ) d x 0 . 不過,我們現在要算的是 tilted density p t R p_t^R p t R e λ R ( x 0 ) e^{\lambda R(x_0)} e λ R ( x 0 ) R ( x 0 ) R(x_0) R ( x 0 )
h t ( x t ) : = ∫ e λ R ( x 0 ) p ( x 0 ∣ x t ) d x 0 = E [ e λ R ( x 0 ) ∣ x t ] . h_t(x_t):=\int e^{\lambda R(x_0)}p(x_0\mid x_t)\,\mathrm dx_0
=\mathbb E\!\left[e^{\lambda R(x_0)}\mid x_t\right]. h t ( x t ) := ∫ e λ R ( x 0 ) p ( x 0 ∣ x t ) d x 0 = E [ e λ R ( x 0 ) ∣ x t ] . 回到前面得到的 p t R p_t^R p t R
p t R ( x t ) = 1 Z R ∫ q ( x t ∣ x 0 ) p d a t a ( x 0 ) e λ R ( x 0 ) d x 0 . p_t^R(x_t)
=\frac{1}{Z_R}\int q(x_t\mid x_0)
p_{\mathrm{data}}(x_0)e^{\lambda R(x_0)}\,\mathrm dx_0. p t R ( x t ) = Z R 1 ∫ q ( x t ∣ x 0 ) p data ( x 0 ) e λ R ( x 0 ) d x 0 . 利用式(2)的 Bayes rule,再把不隨 x 0 x_0 x 0 p t ( x t ) p_t(x_t) p t ( x t ) h t h_t h t
p t R ( x t ) = p t ( x t ) Z R ∫ e λ R ( x 0 ) p ( x 0 ∣ x t ) d x 0 = p t ( x t ) h t ( x t ) Z R . p_t^R(x_t)=\frac{p_t(x_t)}{Z_R}\int e^{\lambda R(x_0)}p(x_0\mid x_t)\,\mathrm dx_0=\frac{p_t(x_t)h_t(x_t)}{Z_R}. p t R ( x t ) = Z R p t ( x t ) ∫ e λ R ( x 0 ) p ( x 0 ∣ x t ) d x 0 = Z R p t ( x t ) h t ( x t ) . 現在像 U7.1 一樣取 log、對 x t x_t x t Z R Z_R Z R x t x_t x t
∇ x t log p t R ( x t ) = s t ( x t ) + ∇ x t log h t ( x t ) . \boxed{
\nabla_{x_t}\log p_t^R(x_t)
=s_t(x_t)+\nabla_{x_t}\log h_t(x_t)
}. ∇ x t log p t R ( x t ) = s t ( x t ) + ∇ x t log h t ( x t ) . 也就是說,我們可以在原本 pretrained model 估計的 score function 上,加上 ∇ x t log h t ( x t ) \nabla_{x_t}\log h_t(x_t) ∇ x t log h t ( x t ) p R p_R p R
圖:reward 重加權乾淨端的機率;在 noisy state 上,h t h_t h t e λ R e^{\lambda R} e λ R
補充 Exact tilted sampling 還需要匹配起始的 noisy distribution 和 U7.1 一樣,精確方向還需要配合正確的起始 distribution。Sampling 從 t = T t=T t = T p t R p_t^R p t R p T R p_T^R p T R p T p_T p T t = T t=T t = T
p T R ( x T ) = p T ( x T ) h T ( x T ) Z R . p_T^R(x_T)=\frac{p_T(x_T)h_T(x_T)}{Z_R}. p T R ( x T ) = Z R p T ( x T ) h T ( x T ) . 想像不管原圖是貓、狗,還是其他內容,加噪到 t = T t=T t = T x 0 x_0 x 0 q ( x T ∣ x 0 ) = p T ( x T ) q(x_T\mid x_0)=p_T(x_T) q ( x T ∣ x 0 ) = p T ( x T ) x T x_T x T x 0 x_0 x 0
因此,看到 x T x_T x T p T ( x T ) p_T(x_T) p T ( x T )
p ( x 0 ∣ x T ) = p d a t a ( x 0 ) . p(x_0\mid x_T)=p_{\mathrm{data}}(x_0). p ( x 0 ∣ x T ) = p data ( x 0 ) . 這時 h T h_T h T h T h_T h T
h T ( x T ) = ∫ e λ R ( x 0 ) p d a t a ( x 0 ) d x 0 = Z R . \begin{aligned}
&h_T(x_T)\\
&=\int e^{\lambda R(x_0)}p_{\mathrm{data}}(x_0)\,\mathrm dx_0\\
&=Z_R.
\end{aligned} h T ( x T ) = ∫ e λ R ( x 0 ) p data ( x 0 ) d x 0 = Z R . 最後一行正好是前面 Z R Z_R Z R Z R Z_R Z R
p T R ( x T ) = p T ( x T ) Z R Z R = p T ( x T ) . p_T^R(x_T)=\frac{p_T(x_T)Z_R}{Z_R}=p_T(x_T). p T R ( x T ) = Z R p T ( x T ) Z R = p T ( x T ) . 在這個條件下,我們就可以沿用原本的 p T p_T p T 看起來像 Gaussian noise,不等於已經和 x 0 x_0 x 0 此時 h T ( x T ) h_T(x_T) h T ( x T ) Z R Z_R Z R p T R p_T^R p T R p T p_T p T
所以,直接沿用原 Gaussian 起點,也可能有起始 distribution 的 approximation。這和 guidance 的估計誤差是兩件事:一個是起點的 distribution 沒對上,一個是途中使用的方向沒估準。
實作上的近似,近似的是哪一項?
回顧一下,h t ( x t ) h_t(x_t) h t ( x t ) x t x_t x t x 0 x_0 x 0 e λ R ( x 0 ) e^{\lambda R(x_0)} e λ R ( x 0 ) p ( x 0 ∣ x t ) p(x_0\mid x_t) p ( x 0 ∣ x t ) x 0 x_0 x 0
h t ( x t ) = E [ e λ R ( x 0 ) ∣ x t ] = ∫ e λ R ( x 0 ) p ( x 0 ∣ x t ) d x 0 . \begin{aligned}
h_t(x_t)
&=\mathbb E\!\left[e^{\lambda R(x_0)}\mid x_t\right]\\
&=\int e^{\lambda R(x_0)}p(x_0\mid x_t)\,\mathrm dx_0.
\end{aligned} h t ( x t ) = E [ e λ R ( x 0 ) ∣ x t ] = ∫ e λ R ( x 0 ) p ( x 0 ∣ x t ) d x 0 . 但我們不知道完整的 p d a t a ( x 0 ) p_{\mathrm{data}}(x_0) p data ( x 0 ) p ( x 0 ∣ x t ) p(x_0\mid x_t) p ( x 0 ∣ x t )
既然精確地算出 h t ( x t ) h_t(x_t) h t ( x t )
我們可以先試著替目前的 x t x_t x t U1.3 的 Tweedie formula 嗎?只要 signal 尚未完全消失(α ˉ t > 0 \bar\alpha_t>0 α ˉ t > 0 x t x_t x t s t ( x t ) s_t(x_t) s t ( x t )
E [ x 0 ∣ x t ] = x t + σ t 2 s t ( x t ) α ˉ t . \mathbb E[x_0\mid x_t]
=\frac{x_t+\sigma_t^2s_t(x_t)}{\sqrt{\bar\alpha_t}}. E [ x 0 ∣ x t ] = α ˉ t x t + σ t 2 s t ( x t ) . 把理想 score 換成 pretrained model 的估計 s t ( x t ) ≈ − ϵ θ ( x t , t ) / σ t s_t(x_t)\approx-\epsilon_\theta(x_t,t)/\sigma_t s t ( x t ) ≈ − ϵ θ ( x t , t ) / σ t
x ^ 0 ( x t , t ) = x t − σ t ϵ θ ( x t , t ) α ˉ t . \hat x_0(x_t,t)
=\frac{x_t-\sigma_t\epsilon_\theta(x_t,t)}{\sqrt{\bar\alpha_t}}. x ^ 0 ( x t , t ) = α ˉ t x t − σ t ϵ θ ( x t , t ) . 分子先扣掉預測 noise,分母再還原 signal amplitude。
有了這個估計,我們可以先用單一的 x ^ 0 \hat x_0 x ^ 0 h t ( x t ) h_t(x_t) h t ( x t ) e λ R ( x ^ 0 ( x t , t ) ) e^{\lambda R(\hat x_0(x_t,t))} e λ R ( x ^ 0 ( x t , t ))
h t ( x t ) ≈ e λ R ( x ^ 0 ( x t , t ) ) . h_t(x_t)
\approx e^{\lambda R(\hat x_0(x_t,t))}. h t ( x t ) ≈ e λ R ( x ^ 0 ( x t , t )) . 這類先估計 x ^ 0 \hat x_0 x ^ 0 plug-in estimation(代入估計) ,也可以稱為 plug-in approximation 。這個近似手法在 test-time guidance 的研究中很常見 [1, 5]。
取 log-gradient 後,我們得到 guidance term 的近似:
∇ x t log h t ( x t ) ≈ λ ∇ x t R ( x ^ 0 ( x t , t ) ) , \nabla_{x_t}\log h_t(x_t)
\approx\lambda\nabla_{x_t}R(\hat x_0(x_t,t)), ∇ x t log h t ( x t ) ≈ λ ∇ x t R ( x ^ 0 ( x t , t )) , 這個近似方法在 Bansal 等人的論文 [1] 中被稱為 forward universal guidance 。
這是在問:「稍微改動 x t x_t x t
∇ x t R ( x ^ 0 ( x t , t ) ) = ( ∂ x ^ 0 ∂ x t ) ⊤ ∇ x 0 R ( x ^ 0 ( x t , t ) ) . \nabla_{x_t}R(\hat x_0(x_t,t))
=\left(\frac{\partial\hat x_0}{\partial x_t}\right)^{\!\top}
\nabla_{x_0}R(\hat x_0(x_t,t)). ∇ x t R ( x ^ 0 ( x t , t )) = ( ∂ x t ∂ x ^ 0 ) ⊤ ∇ x 0 R ( x ^ 0 ( x t , t )) . 右邊先算乾淨結果的 reward gradient,再用 ∂ x ^ 0 / ∂ x t \partial\hat x_0/\partial x_t ∂ x ^ 0 / ∂ x t θ \theta θ
雖然這個方法提供了一個近似,但它不保證得到 exact tilt,因為一般來說
h t ( x t ) = E [ e λ R ( x 0 ) ∣ x t ] ≠ e λ R ( E [ x 0 ∣ x t ] ) . \begin{aligned}
h_t(x_t)
&=\mathbb E\!\left[e^{\lambda R(x_0)}\mid x_t\right]\\
&\neq e^{\lambda R(\mathbb E[x_0\mid x_t])}.
\end{aligned} h t ( x t ) = E [ e λ R ( x 0 ) ∣ x t ] = e λ R ( E [ x 0 ∣ x t ]) . 而用這個近似算出的 log-gradient,也不保證與 ∇ x t log h t ( x t ) \nabla_{x_t}\log h_t(x_t) ∇ x t log h t ( x t )
補充 近期研究如何處理實作 guidance 與精確 target 的差距? 問題不是只有「guidance 強度怎麼調」。我們原本需要的是 h t ( x t ) = E [ e λ R ( x 0 ) ∣ x t ] h_t(x_t)=\mathbb E[e^{\lambda R(x_0)}\mid x_t] h t ( x t ) = E [ e λ R ( x 0 ) ∣ x t ] posterior、這個平均,以及最後的取樣過程 。研究可以從不同的地方處理這些誤差。
以下以 2024–2026 年的正式會議論文為主,並保留兩篇 2023 年的研究,幫助我們看清後續方法在改什麼。涉及 inverse problems 時,取 λ R ( x 0 ) = log p ( y ∣ x 0 ) \lambda R(x_0)=\log p(y\mid x_0) λ R ( x 0 ) = log p ( y ∣ x 0 )
(一)不要只評分平均圖片,改成平均多個可能結果的權重。
如果同一張模糊圖片可能來自不同的乾淨結果,只評分它們的平均,會漏掉這些可能性。Song 等人的 Loss-Guided Diffusion/LGD-MC(ICML 2023) [6] 改成先抽多個候選,再平均 e λ R e^{\lambda R} e λ R
x 0 ( i ) ∼ p ^ 0 ∣ t ( ⋅ ∣ x t ) , h ^ t ( x t ) = 1 K ∑ i = 1 K e λ R ( x 0 ( i ) ) . \begin{aligned}
x_0^{(i)}&\sim\hat p_{0\mid t}(\cdot\mid x_t),\\
\hat h_t(x_t)&=\frac1K\sum_{i=1}^K e^{\lambda R(x_0^{(i)})}.
\end{aligned} x 0 ( i ) h ^ t ( x t ) ∼ p ^ 0 ∣ t ( ⋅ ∣ x t ) , = K 1 i = 1 ∑ K e λ R ( x 0 ( i ) ) . 這裡的 p ^ 0 ∣ t \hat p_{0\mid t} p ^ 0 ∣ t p ( x 0 ∣ x t ) p(x_0\mid x_t) p ( x 0 ∣ x t ) log h ^ t \log\hat h_t log h ^ t 增加 K K K ,不會自動把 p ^ 0 ∣ t \hat p_{0\mid t} p ^ 0 ∣ t
Geyfman 等人的 Calibrated Bayesian Guidance/CBG(ICML 2026) [2] 更進一步:要求候選來自 p ( x 0 ∣ x t ) p(x_0\mid x_t) p ( x 0 ∣ x t )
ω i = e λ R ( x 0 ( i ) ) , x ˉ 0 , R = ∑ i ω i x 0 ( i ) ∑ i ω i , s t R ( x t ) ≈ α ˉ t x ˉ 0 , R − x t σ t 2 . \begin{aligned}
\omega_i&=e^{\lambda R(x_0^{(i)})},\\
\bar x_{0,R}&=\frac{\sum_i\omega_i x_0^{(i)}}{\sum_i\omega_i},\\
s_t^R(x_t)&\approx
\frac{\sqrt{\bar\alpha_t}\,\bar x_{0,R}-x_t}{\sigma_t^2}.
\end{aligned} ω i x ˉ 0 , R s t R ( x t ) = e λ R ( x 0 ( i ) ) , = ∑ i ω i ∑ i ω i x 0 ( i ) , ≈ σ t 2 α ˉ t x ˉ 0 , R − x t . 也就是讓高 reward 的可能來源在平均時有較大的權重,再用 Tweedie 的關係換成 score;減掉 base score s t s_t s t 在 posterior 取樣正確、相關平均存在的條件下,K → ∞ K\to\infty K → ∞ ,但有限 K K K
(二)如果仍要用 Gaussian 近似,能不能把 uncertainty 算得更好?
只保留 x ^ 0 \hat x_0 x ^ 0 x 0 x_0 x 0 Free Hunch(ICLR 2025) [7] 處理的是 posterior covariance Σ t = Cov ( x 0 ∣ x t ) \Sigma_t=\operatorname{Cov}(x_0\mid x_t) Σ t = Cov ( x 0 ∣ x t ) y = A x 0 + ξ y=Ax_0+\xi y = A x 0 + ξ ξ ∼ N ( 0 , τ 2 I ) \xi\sim\mathcal N(0,\tau^2I) ξ ∼ N ( 0 , τ 2 I )
p ( y ∣ x t ) ≈ N ( y ; A x ^ 0 , C t ) , C t = τ 2 I + A Σ t A ⊤ . \begin{aligned}
p(y\mid x_t)&\approx\mathcal N(y;A\hat x_0,C_t),\\
C_t&=\tau^2I+A\Sigma_tA^\top.
\end{aligned} p ( y ∣ x t ) C t ≈ N ( y ; A x ^ 0 , C t ) , = τ 2 I + A Σ t A ⊤ . τ 2 I \tau^2I τ 2 I A Σ t A ⊤ A\Sigma_tA^\top A Σ t A ⊤ linear inverse problems 中分析 covariance 不準造成的 guidance 偏差,並改善重建結果;但補上 covariance 不等於還原多峰 posterior,論文也沒有給任意 reward 的 exact sampling 保證。
另一個方向是不直接從 x t x_t x t Midpoint Guidance/MGPS(ICLR 2025) [8] 先引入噪聲較小的中間 state,將 reverse transition 拆成「先抽這個中間 state,再經 Gaussian bridge 回到下一步」。中間 state 更接近乾淨資料,likelihood 的近似可以較容易;但從目前 state 到它的 conditional 也更難算,因此方法用 Gaussian variational distribution、最小化一個 KL 上界來折衷。它在 linear/nonlinear inverse problems 中驗證效果,仍是在取樣 surrogate posterior,而不是證明這些近似全都消失 。
(三)近似 guidance 可以留下,但能不能在取樣時修正它?
想像目前的導航只是幫我們提出「可能往哪裡走」;我們也可以同時記錄,每條被提出的路在真正 target 下應有多少權重。這類方法維持多條生成軌跡,稱為 particles ,逐步更新權重並重抽,稱為 sequential Monte Carlo(SMC) 。重抽是按權重抽選,不是只保留最高 reward 的一條路。
Wu 等人的 Twisted Diffusion Sampler/TDS(NeurIPS 2023) [9] 就把近似 guidance 用來建立 proposal,再用包含「模型 transition/proposal」比例的 importance weights 修正。其定理要求最終的 twisting function 等於真實 likelihood、相關權重正且有界、twisting 的 log-gradient 有界,並讓 proposal variance 大於模型 transition variance 等條件。在這些條件下,particles 數量增加時,對 pretrained diffusion model 的 conditional distribution 得到一致估計 。這不等於有限幾個 particles 已經精確,也不保證 pretrained model 本身就是 p d a t a p_{\mathrm{data}} p data
Singhal 等人的 Feynman–Kac steering(ICML 2025) [10] 把這個想法推廣到一般 reward 與離散 diffusion。每步用一個 potential G t G_t G t
∏ t = 0 T G t ( x T : t ) = e λ R ( x 0 ) . \prod_{t=0}^{T}G_t(x_{T:t})=e^{\lambda R(x_0)}. t = 0 ∏ T G t ( x T : t ) = e λ R ( x 0 ) . 這裡的乘積指沿著 T , T − 1 , … , 0 T,T-1,\ldots,0 T , T − 1 , … , 0 中間的 reward estimate 可以不精確,但最後的總權重不能任意改掉 。正確的權重與適當 SMC 條件給出對模型 tilted distribution 的一致近似;有限 particles 仍可能漏掉罕見 modes,或在重抽後只剩少數不同的路徑。
Skreta 等人的 Feynman–Kac Correctors/FKC(ICML 2025) [11] 處理相關但不同的問題:就算把多個模型的 scores 混合成所設計的 density 的 score,照原本 reverse dynamics 走,也未必真的走過那組中間 distributions。他們從 Fokker–Planck equation 找出缺少的項,改用帶權重的 dynamics 與 SMC 修正,涵蓋 CFG、temperature annealing 與 product of experts。這提醒我們,不只要檢查 score 公式,也要檢查它與所選 dynamics 是否一致。 其加權表示在理想 scores/連續 dynamics 下成立;有限步、有限 particles 與 score 誤差仍要另算,且它設計的中間 path 不必就是本篇的 p t R p_t^R p t R
Wu 等人的 Reverse Diffusion SMC/RDSMC(NeurIPS 2025) [13] 也用 weights 修正近似 score 與離散化造成的 proposal 偏差,並在其條件下得到一致的 target estimates。差別是它的設定要求 能評估未正規化的 target density ,不是只給一支 pretrained score model 加上 reward;我們這裡通常不能直接評估 p d a t a ( x 0 ) e λ R ( x 0 ) p_{\mathrm{data}}(x_0)e^{\lambda R(x_0)} p data ( x 0 ) e λ R ( x 0 )
(四)也可以不估計 ∇ log h t \nabla\log h_t ∇ log h t
Zihui Wu 等人的 PnP-DM(NeurIPS 2024) [12] 引入輔助變數,交替進行兩個 sampling steps:一步讓結果符合 measurement likelihood;另一步使用 diffusion model 抽 Gaussian denoising posterior,而不是只回傳 denoiser mean。它使用 split Gibbs sampling,讓兩個原本纏在一起的要求分開處理。理論需要正確的條件取樣與相應假設;固定的 splitting parameter ρ > 0 \rho>0 ρ > 0 ρ → 0 \rho\to0 ρ → 0
延伸閱讀:為什麼 mode 選對了,仍可能不是 exact tilt?
Dandapanthula 與 Boffi 的 Are We Really Tilting? [3] 是 2026 年 preprint ,不列入上面的正式會議論文。它分析的是用有限 conditional particles 估計 reward 平均的 guidance,不只本文的單一 posterior-mean 代入。在 Gaussian/mixture 的可分析例子中,它區分「是否走向正確 mode」與「mode 內是否過度偏移、過度縮窄」,並研究 reward damping schedule;特定 Gaussian 情況的修正,不能直接當成一般 reward 的通用解。
所以讀這些結果時,要確認三件事:它修正的是哪一層近似?保證是在增加 samples、減小步長,還是特殊模型的條件下成立?target 是真實資料的 p R p_R p R Reward 上升,是評分變好;是否抽到指定的 distribution,則是另一個要檢查的問題。
消化一下
現在我們知道具體想 sampling 的 reward-tilted distribution 是
p R ( x 0 ) = 1 Z R p d a t a ( x 0 ) e λ R ( x 0 ) . p_R(x_0)=\frac{1}{Z_R}p_{\mathrm{data}}(x_0)e^{\lambda R(x_0)}. p R ( x 0 ) = Z R 1 p data ( x 0 ) e λ R ( x 0 ) . 我們要兼顧 reward R ( x 0 ) R(x_0) R ( x 0 ) p d a t a ( x 0 ) p_{\mathrm{data}}(x_0) p data ( x 0 )
但萬一 reward 是一個封閉的 API,只能回答「這張圖幾分」,或機器人模擬器只能回報「有沒有碰撞」,根本無法直接取得 reward gradient,告訴我們輸入稍微改動後分數怎麼變呢?又或者它是由某個 model 提供的代理分數(proxy),求 gradient 很貴,或估計出的方向不準確呢?
下一篇 U7.3 ,我們會介紹如何只計算、比較 reward R ( x 0 ) R(x_0) R ( x 0 )
下一篇:U7.3 Reward 只會打分、不會給方向,還能怎麼引導? →
參考文獻
Bansal, A. et al. Universal Guidance for Diffusion Models.
Geyfman, D. et al. Calibrated Test-Time Guidance for Bayesian Inference.
Dandapanthula, S., Boffi, N. M. Are We Really Tilting? The Mechanics of Reward Guidance in Flow and Diffusion Models.
Ouyang, L. et al. Training Language Models to Follow Instructions with Human Feedback.
Chung, H. et al. Diffusion Posterior Sampling for General Noisy Inverse Problems.
Song, J. et al. Loss-Guided Diffusion Models for Plug-and-Play Controllable Generation.
Rissanen, S., Heinonen, M., Solin, A. Free Hunch: Denoiser Covariance Estimation for Diffusion Models Without Extra Costs.
Moufad, B. et al. Variational Diffusion Posterior Sampling with Midpoint Guidance.
Wu, L. et al. Practical and Asymptotically Exact Conditional Sampling in Diffusion Models.
Singhal, R. et al. A General Framework for Inference-time Scaling and Steering of Diffusion Models.
Skreta, M. et al. Feynman-Kac Correctors in Diffusion: Annealing, Guidance, and Product of Experts.
Wu, Z. et al. Principled Probabilistic Imaging using Diffusion Models as Plug-and-Play Priors.
Wu, L. et al. Reverse Diffusion Sequential Monte Carlo Samplers.