Lumi 有翅膀的鹿
「如果畫到一半,狗的腿越來越長,我們能不能先請一位朋友看看:現在這張圖,還有多像柯基?」
Lumi 想找的是一個看得懂帶噪聲圖片、能判斷品種的模型。先請它看目前的圖,再找出哪些小修改會提高它判斷為柯基的機率。這條做法稱為 classifier guidance;classifier 是負責判斷的幫手,guidance 是把它的判斷接到生成途中。
用同一個雙峰分布實際跑 classifier guidance 與 CFG;完整讀完兩條方法路徑後,再比較工具前提並判讀新情境。
想連著讀? 技能書 連續閱讀版 · U7.1 →
我們想一個具體的情況:模型已經訓練好了,這次我們想請它畫一隻在雪山上滑雪板的柯基。即使模型能接收文字描述,把這句話交給它,就能保證最後畫出我們想要的圖片嗎?
也許牠確實在雪山上滑雪,卻變成了哈士奇;也許畫出了柯基和雪山,牠卻只是站在雪地裡。我們這次想保留模型參數,趁圖片還沒完成,就給它一些修改的線索。
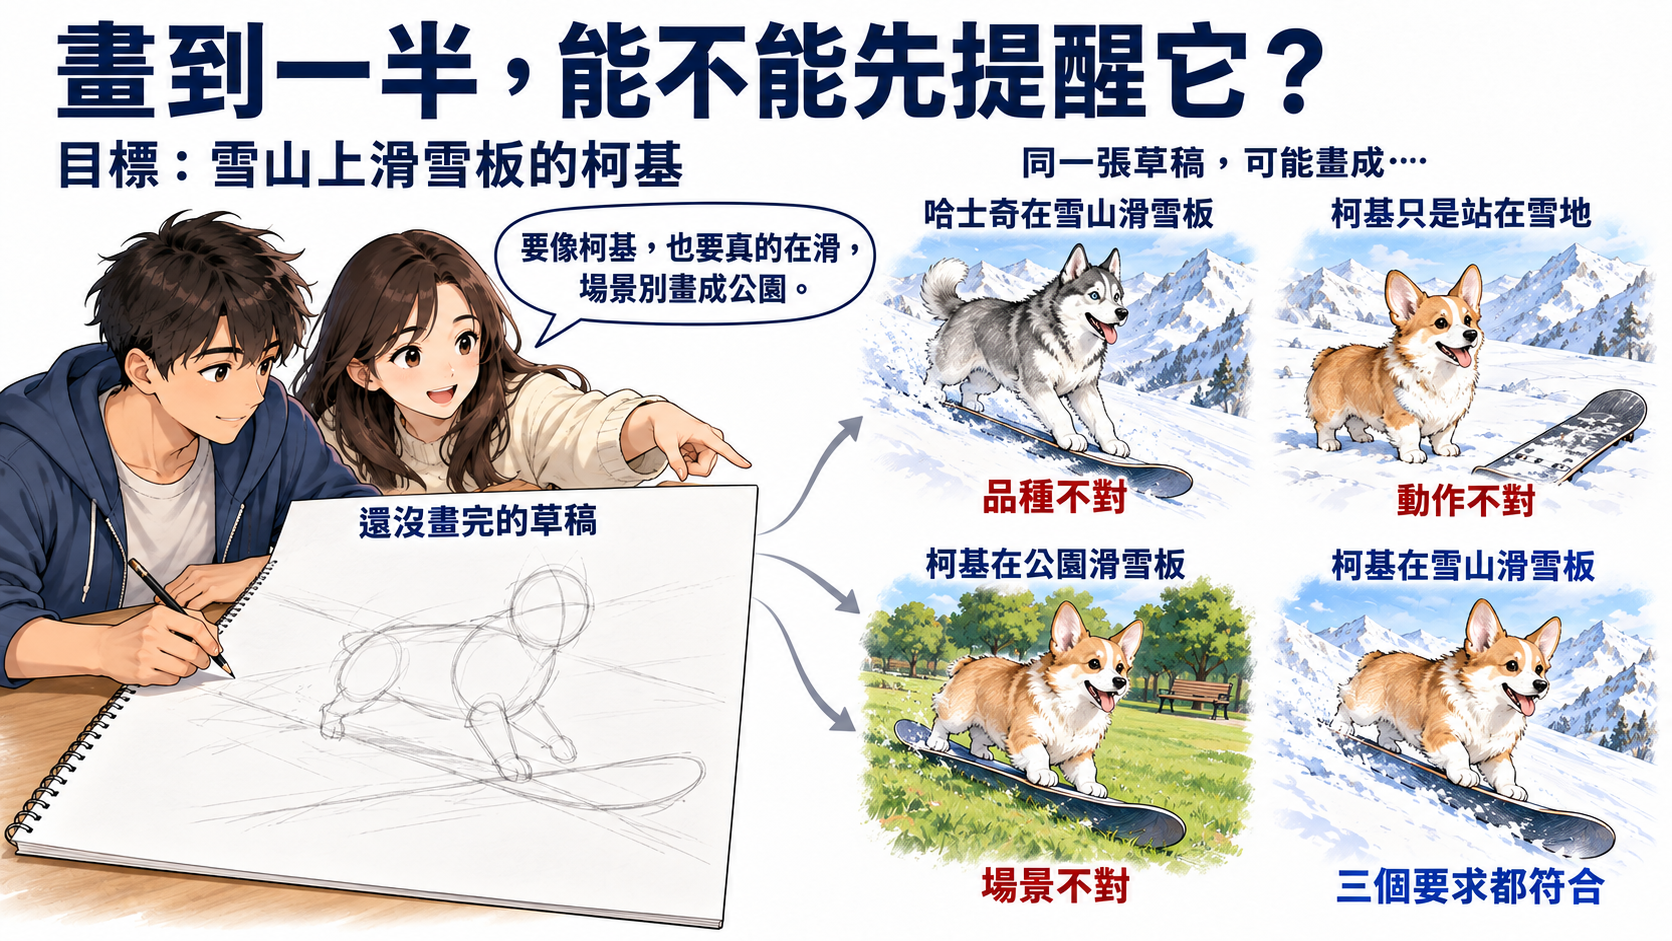
同一張草稿,繼續畫下去可能得到不同的結果。這次先只處理「是不是柯基」;雪山與滑雪動作還是另外的要求。
點圖可放大「如果畫到一半,狗的腿越來越長,我們能不能先請一位朋友看看:現在這張圖,還有多像柯基?」
Lumi 想找的是一個看得懂帶噪聲圖片、能判斷品種的模型。先請它看目前的圖,再找出哪些小修改會提高它判斷為柯基的機率。這條做法稱為 classifier guidance;classifier 是負責判斷的幫手,guidance 是把它的判斷接到生成途中。
「如果模型本來就會讀描述,我們能不能把同一張草稿問它兩次?一次說『請畫柯基』,另一次不指定品種。兩個回答差在哪裡?」
Mugi 想比較的是同一個生成模型,有描述與沒有描述時的 prediction,再加強要求多出的部分。這條做法稱為 classifier-free guidance(CFG)。它不需要另一個 classifier,但需要模型真的學過這兩種輸入。
「這兩個想法都能寫出來,可是我們的幫手如果只看過乾淨照片,現在滿是噪聲,它還看得懂嗎?模型如果每次都拿到描述,突然不給,它會怎麼回答?」
Nori 想先檢查生成前學過什麼。接下來每走一步,我們都先問:現在需要誰的回答?它真的學過這種輸入嗎? 再看看 Lumi 和 Mugi 的提案怎麼接到眼前這張圖。
我們不想等整張圖完成才挑選,而是想在現在這一步得到提醒。你會先把什麼交給幫手?
途中修改需要根據目前的狀態。幫手得看得懂帶有噪聲的圖片,才有理由把它的判斷用在這一步。
完成的照片適合拿來挑選結果,但我們現在還沒有那張照片。要在途中提醒,得處理目前拿得到的輸入。
原本資料裡柯基的比例,不能告訴我們眼前這張圖片像什麼。現在的判斷需要看這張圖。
想像你正在畫這張圖,草稿還只有幾條模糊的線,動物看起來有點像狗,卻還看不出是哪個品種。旁邊的朋友看看草稿,提醒你「腿再短一點,會不會更像柯基?」我們就可以試著修改眼前的草稿,不必等整張畫完才重來。
在 diffusion 中,眼前實際是還帶有噪聲的圖片,記成 ;希望它符合的「柯基」記成 condition 。沿用 U1 的時間: 越大噪聲越多,sampling 往 的乾淨圖片走。帶噪聲的圖是這樣來的:
是原本乾淨的照片, 是保留的訊號比例, 是加進去的 noise, 決定它的幅度。於是我們找來一個練習過不同 noise levels 的判斷模型,先請它回答類別的問題。
把目前的 交給幫手,問:「這張帶噪聲的圖,原本有多可能來自柯基照片?」哪個量是在回答這個問題?
條件右邊是已經看到的圖片,左邊是還想判斷的類別。
換一張圖片,資料裡柯基所占的比例仍然相同。這個量還沒有讀取眼前的圖片。
是「先指定柯基,看看柯基照片加噪後如何分布」; 是「先看到眼前的圖,再判斷它來自哪個類別」。現在交給幫手的是一張圖,它直接回答的是後者。
我們想生成的是前者描述的那群圖片。兩個量能接起來,但要用它們的關係推一步,不能直接把記號對調。
想像先把資料裡的柯基照片挑出來,再用原本 forward process 加噪。這群 noisy images 的 density 是 ,就是指定品種後,我們想使用的分布。
沒錯!又是使用 Bayes rule 的時候:
原本的 包含各種圖片,乘上「來自柯基」的機率後,較可能來自柯基的圖就得到較大的相對權重。分母 把總量調回 。這個式子把幫手的判斷,接到了我們想生成的那群圖片。
剛才的 是一整條 noisy distribution:先從指定品種的乾淨資料抽 ,再用剛才同一個加噪規則。 越大,原圖通常越模糊。
若終點 的 很小,指定品種後的 也接近標準 Gaussian,於是能從近似的噪聲開始 reverse sampling。但有限的加噪不一定完全抹掉品種資訊,不能直接說 精確等於 Gaussian。Score identity、網路的估計、起點的近似和離散 sampler,是不同的步驟。
現在固定 noise level、柯基這個要求和原本資料,只稍微改動圖片。把 Bayes 式裡的三個量,按它們是否依賴圖片分類。
有了 density,還得找目前圖片能往哪裡改。回想 score 是對 density 取 log,再對圖片輸入求 gradient;先取 log,Bayes 裡的乘法就變成加法:
現在對 求 gradient。原本資料的那一項給出 base score,剛才固定的那一項微分為零。指定柯基多出的方向,應該來自哪一項? 先試著寫出它的 gradient。
也可以先在心裡想,再看整理。文字只留在這個頁面,重新載入就會消失。
把 conditional score 記成 、base score 記成 ,剛才逐項微分得到
最後一項指出稍微往哪裡改動 ,能讓「來自柯基」的 log-probability 增加得最快。能把兩支方向相加,是因為 Bayes 的乘法取 log 後成了加法。
這是精確 density 與 score 的關係。實際上要請網路估計,再交給 reverse-time sampler 使用;score 本身不是圖片要移動的距離。對圖片微分時繞過了 ,也不表示我們已經算出它的數值。
沿用 U7.0:,左右兩群分別是 。先把「生成柯基」換成「選擇其中一群」,圖的橫軸是資料 ,沒有把數字當成真正的狗照片。
這個分布的 noisy density、類別機率與 score 都可解析計算,因此先用理想工具實際跑 reverse sampler,觀察固定參數後樣本怎麼改。每條路接著完整檢查:真實網路要怎麼學會所需的回答,以及公式如何換成 noise prediction。
順序由你選。每條路都包含預測、真正抽樣畫圖、必要推導與限制;按最後的返回才標記「已完整探索」。中途可以先回列表,稍後接著讀。
請 noisy classifier 提供方向
先用上面已定義的理想 noisy classifier。執行 A/B 後看兩張直方圖,再讀下方同一個 xₜ 的方向與 sampler 一步。
先預測,再觀察分布
固定模型,從不加提醒改成 w = 1:樣本會靠近哪一群?同一個 xₜ 的 classifier gradient 和 sampler 更新是一樣的量嗎?
A 用 w = 0;B 用你選的 w。兩次使用同一批初始噪聲與隨機種子。
灰線先畫出原本雙峰資料。執行後才會加上實際樣本;參考曲線不代表已經抽到了它。
用剛才的圖與數字說明
Classifier 提供 log 類別機率對 xₜ 的導數,和 base score 合成後,才交給 reverse SDE。實際一步還包含 drift、步長和隨機 noise。這裡使用解析的 noisy classifier 與 score,沒有訓練網路;w = 1 的終點只應接近條件分布,仍有有限起始時間與離散步誤差。
這是標準對照的機制說明;自由改條件或 Python 後,以你實際執行的設定與圖為準。
VP:ᾱₜ = exp(−8t)。從精確的 base p₁ 抽起點,以 Euler–Maruyama 往 t = 0;每步 Δx = (4x + 8s̃)Δt + √(8Δt)ξ。黑色點線是 w = 1 的條件參考;w > 1 時沒有宣稱它是輸出的精確 target。
可以改參數,也可以改抽樣規則。按執行時才載入 Python;運算在你的瀏覽器進行。每次執行從這段程式重新開始,文字不會存檔。
首次展開會帶入上方的控制項設定;之後重開會保留你改過的程式。帶入的是條件,不包含上方累積訓練的參數或生成樣本,因此兩邊的有限抽樣圖不必完全相同。
程式包含相同方法的完整計算與 Matplotlib 分布圖。首次展開套用目前控制項;每次執行重新抽樣。先改最上方一個參數,其他條件保持相同。原生圖不會假裝成你改過的 Python 結果。
import math
import numpy as np
import matplotlib.pyplot as plt

# 1. SETTINGS -- change one, run again, and explain the plotted evidence.
strength = 1
condition = 1  # 0 = left, 1 = right
noise_time = 0.35
observed_x = 0
steps = 600
rng = np.random.default_rng(42)
sigma = 0.55
grid = np.linspace(-6, 6, 481)
dx = grid[1] - grid[0]

# 2. FIXED MODEL -- analytic functions, no network training in this cell.
def pdf(x, mu=0.0, var=1.0):
    return np.exp(-0.5 * (x-mu)**2 / var) / np.sqrt(2*np.pi*var)
def moments(t):
    a = np.exp(-8*t)
    return np.sqrt(a), a*sigma**2 + 1-a
def sample_base(size, t=0.0):
    signal, var = moments(t)
    mu = np.where(rng.random(size) < 0.5, -2.0, 2.0)
    return signal*mu + np.sqrt(var)*rng.normal(size=size)
def sigmoid(v):
    return np.exp(-np.logaddexp(0, -v))
base = 0.5*pdf(grid, -2, sigma**2)+0.5*pdf(grid, 2, sigma**2)
reference = base.copy()
reference_label = "Conditional reference at w=1"
extra_figure = None

# 3. GENERATION -- reverse VP SDE, Euler-Maruyama; beta = 8.
def base_score(x, t):
    signal, var = moments(t)
    right = sigmoid(4*signal*x/var)
    return (2*signal*(2*right-1)-x)/var
def conditional_score(x, t):
    signal, var = moments(t)
    return ((2 if condition else -2)*signal-x)/var
def classifier_log_gradient(x, t):
    signal, var = moments(t)
    right = sigmoid(4*signal*x/var)
    return 4*signal/var*((1-right) if condition else -right)
def guided(x, t):
    return base_score(x, t)+strength*classifier_log_gradient(x, t)
samples = sample_base(1000, 1.0)
dt = 1/steps
for k in range(steps, 0, -1):
    t = k*dt
    samples += (4*samples+8*guided(samples, t))*dt + np.sqrt(8*dt)*rng.normal(size=samples.size)
reference = pdf(grid, 2 if condition else -2, sigma**2)
reference_label = "Conditional reference at w=1 (not an exact w>1 target)"
print("Fixed analytic scores; finite-time and Euler error remain.")
print("Reverse steps:", steps, "sampler updates:", 1000*steps)
print("Signals per update: base score + classifier input gradient")
print("At x_t, base / conditional / classifier gradient:", base_score(observed_x, noise_time), conditional_score(observed_x, noise_time), classifier_log_gradient(observed_x, noise_time))

# 4. PLOT AND CHECK -- the histogram is from the samples above.
fig, ax = plt.subplots(figsize=(8, 3.6))
ax.plot(grid, base, "--", color="gray", label="Original base")
ax.plot(grid, reference, ":", color="black", label=reference_label)
ax.hist(samples, bins=np.linspace(-6,6,49), weights=np.ones(len(samples))/(len(samples)*0.25), alpha=0.5, label="Actual generated samples")
ax.set(xlabel="clean x0", ylabel="density", xlim=(-6,6))
ax.legend(fontsize=8)
fig.tight_layout()
print("Outputs:", len(samples), "mean:", np.mean(samples), "right share:", np.mean(samples > 0))
print("Outside the plotted window:", np.sum(np.abs(samples)>6))
plt.show()
把 noisy classifier 寫成 , 是它的參數,生成模型的參數仍是 。現在想保留幫手的判斷方式,改動它正在看的圖片,讓類別的 log-probability 增加。該對誰求 gradient?
Input gradient 描述輸入改變時,這個判斷如何變化;它不是網路參數的更新方向。
更新生成模型參數,會讓模型重新學習這次的偏好。我們要取得的是目前圖片的修改線索。
想像圖片留著,只改 classifier 的 。它也許會給出不同的判斷,但圖片裡的狗有因此變成柯基嗎?我們希望保留它的判斷方式,改的是 。
所以需要 。反向傳播也能用來計算 input gradient;計算微分和更新參數,是不同的動作。
有兩個候選:甲只用乾淨照片學過品種分類;乙用不同 noise levels 的圖片學過同一件事。生成途中仍是 noisy image,哪一個至少具備我們這次需要的訓練前提?
Noise level 改變了圖片裡可見的資訊。幫手需要學過在這些輸入下如何判斷類別。
在乾淨照片上分得準,沒有保證也看得懂帶噪聲的輸入。這次需要的能力,要看它實際學過什麼。
它們接收的輸入不同。網路大小或名字相同,不能代替看過相應輸入的訓練。
「既然途中有很多種模糊程度,我們就把同一張有品種標籤的照片,加上不同程度的噪聲。狗雖然越來越難認,原本的品種標籤還在,對吧?」
把幫手的參數記成 。從資料抽 、抽 noise level 和 Gaussian noise ,按剛才的規則得到 。請它替正確品種給出機率,訓練 loss 是
正確品種的機率越高,負 log 越小。這就是 noisy classifier 的分類練習;可以直接加噪訓練照片,不必等生成模型先畫圖。噪聲很多時,照片本來就可能辨認不出來,合理的回答也可以很不確定。
訓練時改的是 ,所以用 ;現在請它幫忙修改圖片,則固定 ,用 。同樣在算 gradient,想改的對象不同。
用已訓練好的 base model 估計 ,再加上幫手提供的 input gradient:
是這次提醒的強度。從 unconditional base 出發時, 留下 base;若兩個估計都精確, 給出剛才的 conditional score。實際上,我們把這支合成 score 交給 reverse sampler,由 sampler 決定下一步圖片怎麼更新。這就是 Lumi 的 classifier guidance 提案。
剛才從 unconditional base 出發。如果手上已是 conditional score,再多加 classifier 的方向,那是在原本要求上額外加強;額外係數為 時就保留原本 conditional prediction。不能把兩種起點的「不加強」都叫 。讀公式時先看 base 是哪支回答,再看額外項的係數。
U1 的網路通常輸出 noise prediction 。在帶噪聲的時刻,沿用 noise amplitude ,換成 score 是
先看 classifier guidance:在不接收 的 base score 上,加 倍 classifier 的 input gradient。換成 noise prediction 時,這個額外項前面的正負號與倍率會怎樣? 試著把 score 組合式兩邊乘上 。
也可以先在心裡想,再看整理。文字只留在這個頁面,重新載入就會消失。
將 score 組合式乘上 ,得到
負號與 都來自剛才的換算。這裡從 unconditional base 加 classifier 提醒,所以 才是不加提醒;和 CFG 從 conditional 出發、以 為基準不同。
我們剛才用到的是機率隨圖片改變的 gradient。就像兩片地形高度很接近,局部坡度仍可能不同,類別機率估得準,也不自動保證 input gradient 準。
上面這條路,生成模型可以原本不接收 ,另外請 noisy classifier 提供要求。另一條方法路徑會檢查:如果我們已經有一個學會 condition 的生成模型,能不能從它自己的回答找出這個方向?
分類正確率只檢查答案。Guidance 還要用到圖片附近的局部變化,所以我們也想知道:只做很小的輸入擾動,它的判斷是否穩定?一個能分類的網路,可能在很小的擾動下就大幅改變回答;不能只靠乾淨圖片的準確率,推論途中 input gradient 的品質。這是檢查方向的理由,不是宣稱穩定就保證生成成功。Kawar、Ganz 與 Elad 的研究討論了 robust classifier 用於 guidance 的問題。
你已用固定模型生成樣本,區分 input gradient 與參數更新,也讀過 noisy classifier 的 loss、score 組合、noise 換算和限制。回列表後再探索另一種取得方向的方法。
比較同一模型的兩種回答
暫時假設這個現成模型,也能回答「不指定品種」的情況。把同一張 、同一個 問兩次:指定柯基時怎麼預測,不指定品種時又怎麼預測?要取出這次要求多出的部分,該怎麼比較?
Bayes 給出的關係是 conditional 等於 base 加額外方向。這次只在兩邊扣掉 base,不必重做整段推導。
兩種回答的平均仍然保留共同的 base。我們想取出的是指定品種多出的影響。
剛才得到 conditional score 等於 base score 加上 condition 的額外方向。把整支 conditional score 再加到 base 上,原本的 base 也會多加一遍。
我們想留下的是 condition 的影響,所以得扣掉共同的 base。比較的是同一張圖片的兩種回答,不是兩張完成圖片的差。
把剛才的 exact score identity 移項:
「有要求的方向」扣掉「原本的方向」,剩下的正是 condition 多出的部分。Mugi 的提案就是請生成模型估計右邊兩項,再相減。同一張圖、同一個時刻才是在比較兩種要求,不能拿兩張生成結果相減代替。
先用這個 toy 的解析 conditional 與 unconditional score。兩支回答在相同的 xₜ、t 上計算;接著才檢查真實網路提供它們的訓練前提。
先預測,再觀察分布
同一張 xₜ 問有/沒有 condition 兩次,從 w = 1 改成較強的提醒,樣本群內的位置和分散程度會怎麼變?
A 保留原本 conditional prediction(w = 1);B 用你選的 w。c、步數與隨機種子保持相同。
灰線先畫出原本雙峰資料。執行後才會加上實際樣本;參考曲線不代表已經抽到了它。
用剛才的圖與數字說明
CFG 改的是同一個輸入上兩支 prediction 的組合。這個 toy 使用解析的理想回答,w = 1 保留 conditional;改大 w 會改變生成結果,但變化大小依資料與 condition 而定,不保證每次更集中。兩個方法在理想回答、相同 w 與 sampler 下應一致;真實網路的前提和估計誤差則不同。
這是標準對照的機制說明;自由改條件或 Python 後,以你實際執行的設定與圖為準。
同一個 VP sampler、同一組固定參數。s̃ = sᶜ + (w−1)(sᶜ−s∅)。這裡用解析回答觀察組合,後面仍完整檢查 conditioning dropout;沒有把未學過空輸入的網路當成已經準備好。
可以改參數,也可以改抽樣規則。按執行時才載入 Python;運算在你的瀏覽器進行。每次執行從這段程式重新開始,文字不會存檔。
首次展開會帶入上方的控制項設定;之後重開會保留你改過的程式。帶入的是條件,不包含上方累積訓練的參數或生成樣本,因此兩邊的有限抽樣圖不必完全相同。
程式包含相同方法的完整計算與 Matplotlib 分布圖。首次展開套用目前控制項;每次執行重新抽樣。先改最上方一個參數,其他條件保持相同。原生圖不會假裝成你改過的 Python 結果。
import math
import numpy as np
import matplotlib.pyplot as plt

# 1. SETTINGS -- change one, run again, and explain the plotted evidence.
strength = 3
condition = 1  # 0 = left, 1 = right
noise_time = 0.35
observed_x = 0
steps = 600
rng = np.random.default_rng(42)
sigma = 0.55
grid = np.linspace(-6, 6, 481)
dx = grid[1] - grid[0]

# 2. FIXED MODEL -- analytic functions, no network training in this cell.
def pdf(x, mu=0.0, var=1.0):
    return np.exp(-0.5 * (x-mu)**2 / var) / np.sqrt(2*np.pi*var)
def moments(t):
    a = np.exp(-8*t)
    return np.sqrt(a), a*sigma**2 + 1-a
def sample_base(size, t=0.0):
    signal, var = moments(t)
    mu = np.where(rng.random(size) < 0.5, -2.0, 2.0)
    return signal*mu + np.sqrt(var)*rng.normal(size=size)
def sigmoid(v):
    return np.exp(-np.logaddexp(0, -v))
base = 0.5*pdf(grid, -2, sigma**2)+0.5*pdf(grid, 2, sigma**2)
reference = base.copy()
reference_label = "Conditional reference at w=1"
extra_figure = None

# 3. GENERATION -- reverse VP SDE, Euler-Maruyama; beta = 8.
def base_score(x, t):
    signal, var = moments(t)
    right = sigmoid(4*signal*x/var)
    return (2*signal*(2*right-1)-x)/var
def conditional_score(x, t):
    signal, var = moments(t)
    return ((2 if condition else -2)*signal-x)/var
def classifier_log_gradient(x, t):
    signal, var = moments(t)
    right = sigmoid(4*signal*x/var)
    return 4*signal/var*((1-right) if condition else -right)
def guided(x, t):
    sc, su = conditional_score(x, t), base_score(x, t)
    return sc+(strength-1)*(sc-su)
samples = sample_base(1000, 1.0)
dt = 1/steps
for k in range(steps, 0, -1):
    t = k*dt
    samples += (4*samples+8*guided(samples, t))*dt + np.sqrt(8*dt)*rng.normal(size=samples.size)
reference = pdf(grid, 2 if condition else -2, sigma**2)
reference_label = "Conditional reference at w=1 (not an exact w>1 target)"
print("Fixed analytic scores; finite-time and Euler error remain.")
print("Reverse steps:", steps, "sampler updates:", 1000*steps)
print("Signals per update: conditional prediction + unconditional prediction")
print("At x_t, base / conditional / classifier gradient:", base_score(observed_x, noise_time), conditional_score(observed_x, noise_time), classifier_log_gradient(observed_x, noise_time))

# 4. PLOT AND CHECK -- the histogram is from the samples above.
fig, ax = plt.subplots(figsize=(8, 3.6))
ax.plot(grid, base, "--", color="gray", label="Original base")
ax.plot(grid, reference, ":", color="black", label=reference_label)
ax.hist(samples, bins=np.linspace(-6,6,49), weights=np.ones(len(samples))/(len(samples)*0.25), alpha=0.5, label="Actual generated samples")
ax.set(xlabel="clean x0", ylabel="density", xlim=(-6,6))
ax.legend(fontsize=8)
fig.tight_layout()
print("Outputs:", len(samples), "mean:", np.mean(samples), "right share:", np.mean(samples > 0))
print("Outside the plotted window:", np.sum(np.abs(samples)>6))
plt.show()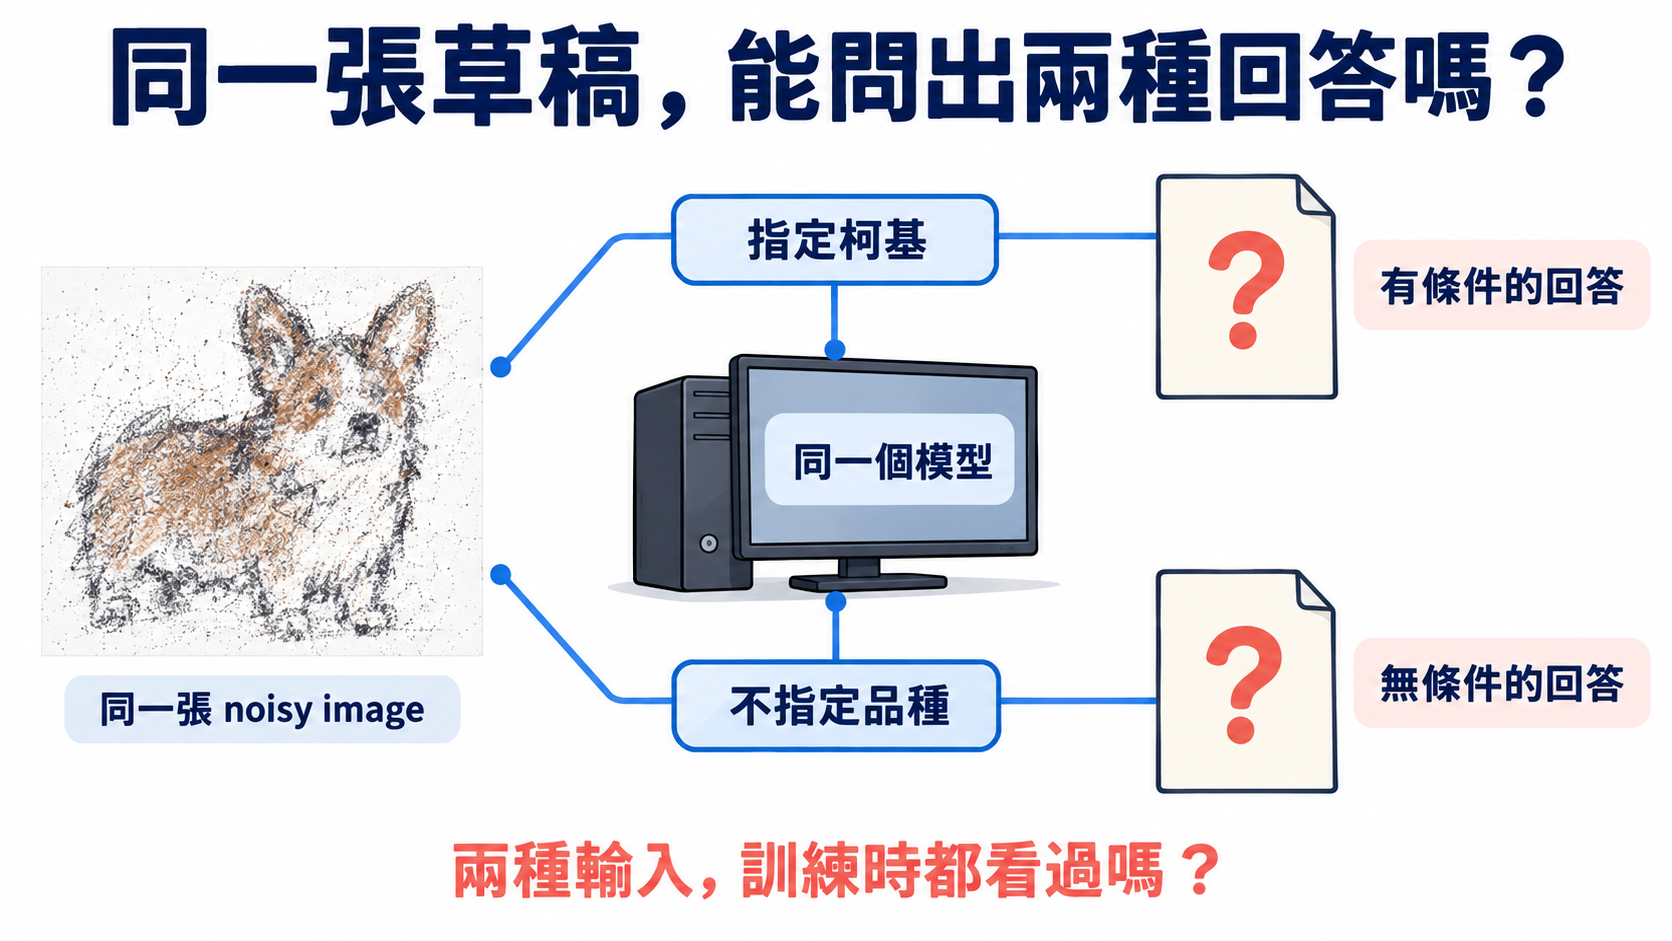
兩條線是同一模型的兩次詢問,不是兩個模型,也不是圖片先後生成的步驟。
點圖可放大如果這個模型訓練時每次都給描述,現在突然拿掉描述,未必知道怎麼預測。回頭看準備模型的階段:可以加哪種練習,讓它有機會回答兩種輸入?
拿掉 condition 的機率要與資料無關,才不會讓沒有 condition 的那批資料被挑成另一種分布。
少掉的是圖片資訊,描述仍然在。這沒有讓模型練習不看描述時怎麼預測。
每次練習都有提示,突然拿走提示,不代表就會回答。模型原本學的是看到 時怎麼預測;沒給 是另一種輸入。
公式裡寫得出 unconditional score,不代表網路已經學會估計它。需要的是準備模型時讓這種輸入也出現,並非每次 sampling 又重新訓練。
這個準備動作稱為 conditioning dropout。空 condition 記成 ,意思是這次不指定品種或 prompt,不是要求圖片裡沒有柯基。原本的圖片、noise level 與加入的 noise 都保留,網路仍預測那個 noise,只是有時不能看描述。
把這次給網路看的 condition 記成 :它有時是原本的 ,有時是空 condition。那 training loss 就是
Expectation 平均的是資料、時刻、加進去的 noise,以及這次是否拿掉 condition 的隨機選擇。要預測的標籤仍是 。若只拿掉某幾個品種的 condition,空輸入就會對應到被挑過的資料;與資料無關地拿掉,才讓它練習整體 base 的回答。
模型準備好後,sampling 用同一套 取得 和 ,分別估計 conditional 與 unconditional score。相減,就能估計要求多出的方向。這條路需要的是已練習過兩種輸入的模型,不是叫我們現在把未準備好的模型重新訓練。
這個模型在訓練時已學過有描述與空 condition。現在生成時詢問兩次,取得兩種 prediction。這兩次計算可以保留同一套 嗎?
模型原本就能根據 condition 生成。我們這次願意少一些變化,試著讓品種特徵更容易辨認,於是沿著兩種回答的差,多加一些提醒。強度記成 ,從原本 conditional prediction 出發:
哪個 會留下原本的 conditional prediction,不額外加強?
這裡從 conditional prediction 出發,額外項的係數是 w−1,所以基準是 w=1。
代入 w=0,會從 conditional 減掉一次差值,最後剩下 unconditional。連原本 condition 的影響也拿掉了。
代入 w=2,會在原本 conditional 回答上,多加一次兩種回答的差。這已經加強了提醒。
把剛才的式子展開,得到另一種完全相同的寫法:
這裡只是暫時把同一個 的兩種回答縮寫成 、,方便看係數。 是 unconditional; 是 conditional; 則沿差值超過原本 conditional 的回答。
先固定一個 ,並假設用的是 exact scores。這支組合是以下相對權重取 log 後的 gradient:
因為乘法取 log 成加法,次方變係數;不隨 變的正規化項微分為零。若總量有限,可以把這個時刻的相對權重正規化。
可是每個時刻都寫得出這種 density,還不表示它們共同來自同一條 forward process。沿這些組合 scores 生成,也不能只靠這個固定時刻的等式,宣稱最後精確抽到 。
有些文獻從 conditional 回答多加 倍差值,寫成 。在我們這裡,。兩者表示同一個組合,只是命名的強度從不同基準算起;看到數字先代回公式。
把 從 調大,condition 的影響更強了。這表示原本 conditional score 被估得更精確,還是我們刻意改變了 sampling 的品質與多樣性取捨?
在同一個 ,兩支回答都使用 ,其中 。將整個 CFG 等式乘上 ,再檢查共同因子與係數。
對同一張 和同一個 ,兩種 prediction 共用相同的 score/noise 換算因子。把剛才的 CFG 組合換成 noise prediction,組合係數會怎樣?
兩種 score 都乘上同一個負的 noise amplitude,不能只把差值那一項改號。
如果只把差值改成相減,卻保留其他項,就沒有對整個等式做同一個換算。
共同的縮放因子會消去;這次換的是 prediction 的表示法,不是重新定義強度基準。
所以 CFG 的 noise 組合仍然是
把合成的 noise prediction 放進原 sampler,才由它產生往較低 noise level 走的下一張圖片。Classifier 的 、生成模型的 都可以保持固定;改變的是這次 sampler 使用的 prediction。
「假如我們不想要模糊照片,把原本空輸入換成『模糊』,再從『清楚的柯基』往遠離『模糊』的方向推,可以嗎?」
這是 negative prompt 的想法。把不想要的描述記成 ,同一個 的 noise prediction 縮寫為 、,組合可以寫成
如果明天換了一句新的描述,模型可能仍能組合已學過的詞語,不必逐句重訓;可是新的 condition 類型,不會因為我們寫得出公式就突然學會。Classifier guidance 可以另準備理解它的幫手,CFG 的兩支回答則依賴生成模型自己的 condition 能力。
它換掉了比較的基準。 的回答也需要模型學過相應輸入;這不等於「模糊圖片的機率設成零」,也不能再把它直接解讀成 unconditional base 的 Bayes identity。
Conditional training 也能讓 velocity 接收 。以一條已知的 reference path 做練習:例如從 noise 到資料 的 ,標籤是 。這裡 ,和本篇 diffusion 往 去噪的方向不同。
Conditioning dropout 的 loss 是
Expectation 平均 reference endpoints、時刻與是否拿掉 condition;label 仍是 reference velocity。學好兩種輸入後,也能組合
把這支 learned field 交給 ODE solver,才得到 generated trajectory。對常見的 Gaussian affine interpolation,velocity 和 score 有相應的換算關係,可以接回上面的直覺;一般 reference path 則不能只看「兩支 velocity 相減」,就宣稱它一定是 classifier 的 log-gradient。
你已實際跑 CFG,讀過 conditioning dropout 的 loss、強度基準、noise prediction、negative prompt 與 Flow Matching 對應。這些是方法的不同角色;同樣畫得出一張圖,不代表訓練前提與計算成本相同。
Lumi 提出 Classifier guidance,Mugi 提出 CFG。把實際動作放回對應夥伴;每列完成後,先讀整理,再比較下一列。
模型已學過有/沒有文字的輸入,這次仍在它理解的品種類型內,手上沒有額外 classifier。你會先試什麼?
兩種必要輸入都已準備好;生成時組合 prediction 即可。
空輸入是沒有指定要求,不是否定要求。
這個情境的兩種輸入已學過,並沒有新增未學會的類型。
現在手上只有乾淨照片的 classifier,以及訓練時每次都給描述的生成模型;後者沒有練習過空 condition。立刻套用上面兩種做法,哪個判斷比較合理?
乾淨照片上的判斷,沒有提供目前 noisy image 的可靠類別機率與 input gradient。
模型有 conditional 回答,還不表示它學過沒有 condition 時的回答。相減所需的另一支 prediction 尚未準備好。
前者需要 noisy classifier;後者需要學過空 condition 的生成模型。這個情境還沒有準備好它們。
在 toy 中,classifier guidance 和 CFG 使用相同 c、w、步數與種子,樣本直方圖幾乎重疊。哪個解釋符合共同推導?
Bayes identity 讓兩種理想訊號相等,並沒有取消網路準備與 sampler 的需求。
圖中用的是解析理想回答,不能代替真實網路的訓練。
w 改變合成 score,且有限步與起點仍有近似。
我們現在能把品種要求接到生成途中:先找出 condition 多出的方向,再依手上的工具估計它。這一步先處理柯基的類別,還沒有保證完整的雪山與滑雪動作。
使用者接著說:「這幾張品種都對,但我比較喜歡某些構圖與光線。」他交給我們的程式只會替完成圖片打分,沒有能看 noisy image 的 classifier,模型也沒學過這個新的偏好。要讓高分圖片更常出現,我們應該先決定什麼?
Bayes、兩種 guided noise prediction 與模型準備的細節,可以在 U7.1 不重新訓練,怎麼取得這次要求的引導方向? 連著讀。