
U4.2 不知道原句,怎麼學到推動 PMF 的規則?
本篇重用3 篇
先假設我們知道原句
在 U4.1,我們把離散的 velocity 寫成跳躍 rate,也知道要用流入減流出檢查分布。現在要反過來:已經指定 PMF path,怎麼找到生成方向的 rate?
先用最容易追蹤的 MASK。固定原句 ,位置 在時間 的 PMF 是
這格不是原字,就是 MASK。假設我們偷看了原文,知道被遮的是 想,生成時就只需要決定:現在這群 MASK 裡,有多少要翻回 想?
本篇維持 data、 noise, 非增,生成從 退到 ,。這段時間可見比例要由 增至 ;需要翻回的質量是兩者之差,來源 MASK 比例則是 。因此每個 MASK 的翻開機率為
所以每個 MASK 的 reveal rate 是 。例如 ,在 有一半樣本是 MASK;退回 要補回 的總質量,因此這群 MASK 各有約 的翻開機率,rate 是 。
用 表示把整句 的第 格換成 ,其他位置不動。已知原句時,翻開一定填原字,所以對 、,
指示量 只在原字是 時為 。已經可見的位置不再跳;對角元素仍是負的總流出。上標 cond 表示這條規則還需要原句, 的橫線則表示沿生成方向倒著走,並不是先前已簡化掉的保留係數符號。
條件時間方向與端點怎麼處理?
以下先在 的內部時間使用可微的 schedule。 以正的生成時間長度 定義:,。因此它要滿足的是 。若 rate 在端點發散,需使用極限或另外指定端點轉移,不能把無限 rate 直接乘上有限步長。
生成時不知道原句,能不能參考所有可能?
真正生成時,只看到「我/今天/[MASK]/吃/[MASK]」。我們沒有原句,不知道第三格應該跳成 想 還是 要。但回想 U2.2:同一個街口可能有多條 reference paths,我們參考的是所有相容路徑給出的方向。
這裡也一樣。先固定時間 和目前序列 ,只考慮能產生這個 的原句,再按它們的 posterior 機率平均 conditional rates。例如相容原句在第三格有 是 想、 是 要,總 reveal rate 為 ,就分別給 想 rate 、要 rate 。
把可能原句提供的 rates 取條件平均,
能不能得到只看目前序列就能使用的生成規則?
用 表示 reference noisy state,固定 後,仍隨機的是原句 。我們想平均的 label 是這些原句各自提供的 conditional rate:
不知道原字時,該用哪個跳躍 rate?
- 固定時間 ,目前在 ,想算跳向另一個狀態 的 rate。
- 只參考這時能造出目前序列的原句:。
- 若知道原句 ,我們就能算出 conditional rate。
- 對 平均這些 rates,得到只依賴目前狀態與時間的規則。
把剛才的指示量代入,便得到對 MASK 位置的生成 rate:
指示量的條件平均,就是原字為 的 posterior probability。前面的係數決定翻得多快,後面的機率決定翻成哪個字。 我們沒有平均 token 編號,也不需要先列出整張 joint PMF。
課堂提問Q1
既然有些原句比較可能,能不能只選最可能的原句,再使用它提供的 conditional rate?
先想一想,再展開看整理後的答案
這會改變轉移的比例。若目前 context 下,原字為 想、要 的 posterior 是 、,總 reveal rate 是 ,posterior average 分別給它們 、 的 rate;只選最可能的原句,則會給 想 rate 、要 rate 。
我們要重現的是各種可能原句所貢獻的 flows,所以需要按 posterior 加權,不能用最可能的一句取代整個平均。接著就用這個 flow 關係檢查分布。
為什麼平均後仍推動原本的分布?
只平均出一條合法 rate 還不夠,還要檢查它是否推動我們指定的 。沿用 U4.0 的混合式,。在 的狀態,Bayes 給出相容原句的權重:
把它放進平均 rate,再乘回來源狀態的機率:
右邊正是各原句提供的 conditional flows,按資料機率加起來。每一組 conditional process 都有正確的流入減流出;加總後,就得到 。因此,在正確的 noise 起點與可適當定義的精確動態下,這條 rate 會倒著經過原本的 joint PMF path;不要求某條生成 trajectory 認回某一句 training 原文。
這是 U1.2 的 conditional trick 在跳躍規則上的版本。先設計 conditional probability path、建立能推動它的 conditional rates,再取 posterior average,便得到 Discrete Flow Matching(DFM) 的建構方式;Gat 等人 [1] 與 Campbell 等人 [2] 系統化了這類離散生成流程。
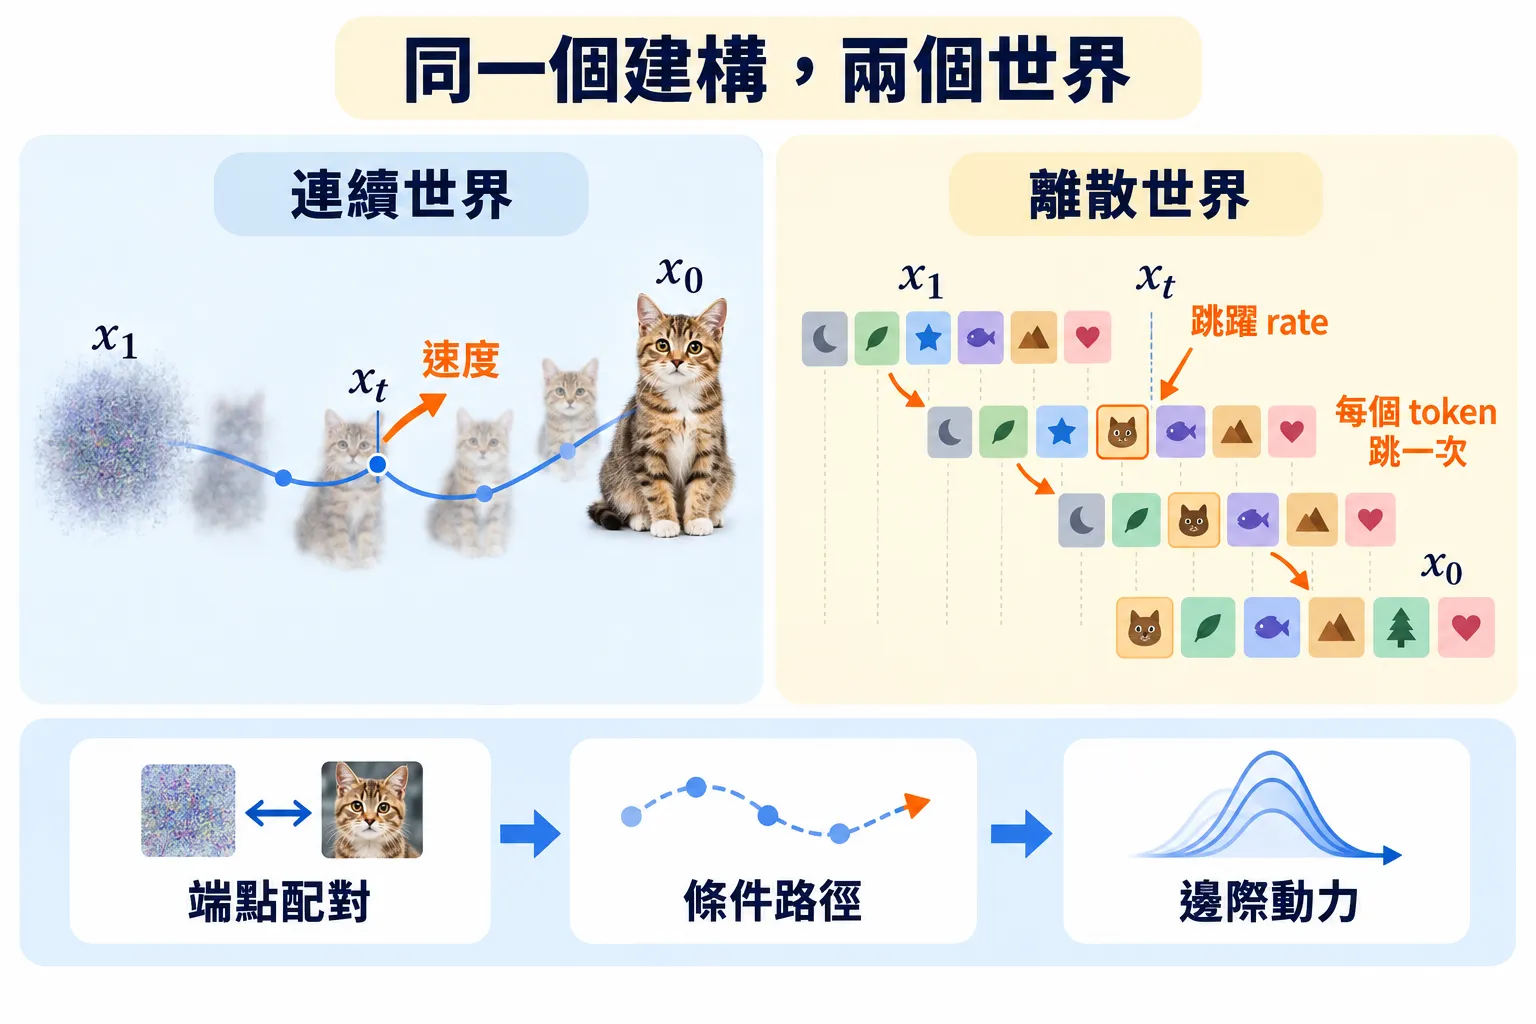
圖:連續情況平均 reference velocities;離散情況平均 conditional rates。兩者都以機率守恆確認平均後的動態能走過指定的 probability path。
未知的 posterior,要用什麼 label 學?
U2 用平方誤差對準 reference velocity,理想解就是相容 velocities 的條件平均。這裡也可以沿用同一個做法:固定一個內部時間 ,以剛才的 conditional rate 為 label 做平方誤差 regression,理想解就是我們已經推得的 posterior-average rate。
不過,剛才的公式還告訴我們:時間係數 已知,真正未知的只剩指示量的條件平均,也就是 。因此可以先讓模型預測這張原字 PMF,再乘回已知係數,組成生成時的 rate。 這仍是在學推動分布的規則,只是改用原字機率來參數化它。
讓模型讀取整句 與時間 ,在每個位置輸出一張字典上的機率表:
對 加總為 ;模型不必把 MASK 當成原字的候選。這個預測原始資料的模型,仍稱為 denoiser。每個 output 可以參考整句 context;輸出每格的 posterior,不代表假設原句各位置獨立。
接下來選擇用 cross-entropy 學這張 PMF。我們沒有真 posterior 當 label,但製造 noisy input 時,手上還保有原文。先抽 、,按已知 抽出 ;模型只看 ,被遮位置的 label 就是 。用 cross-entropy 衡量它給原字多少機率:
用能製造的 training pairs 學原字機率
- 先抽原文 與時間 ,再依 conditional PMF 製造 。
- 模型只看 ,替各個原字候選給出機率。
- 在 MASK 位置,以已知的 當正確類別,計算負 log-probability。
- 對時間、原文與遮罩隨機性平均;反覆訓練時,相容的原字會按其機率成為 label。
固定一個 masked input 和位置,將它的真 posterior 簡記為 、模型機率記為 。把可能的原字 labels 平均,loss 就是 。加減同一項,可寫成
第一項不隨模型改變,第二項在 時為零,因此理想最佳輸出正是真 posterior。每次只給一個原字 label,反覆訓練卻能學到整張條件機率表;不需要事先知道這張表。
MASK denoiser:一次 training update
數學 pipeline
Pseudocode
輸入:資料集、保留係數 alpha(t)、模型 f_theta
x0 ← 從資料集抽一句原文
t ← Uniform(0, 1)
xt ← copy(x0)
for ell = 1, ..., L:
  以機率 1 - alpha(t),將 xt[ell] 換成 MASK
prediction ← f_theta(xt, t)     # 每格一張原字典上的 PMF
loss ← 對所有 MASK 位置加總 -log prediction[ell, x0[ell]]
以 loss 的 gradient 更新 theta
Training 只要抽 snapshot,不必先模擬完整的跳躍過程。 學完後,用 取代 rate 裡的 posterior;理想 rate 與網路近似是兩個層次,實際生成還要選取樣方法。
補充換時間權重,還是在學同一張 posterior 嗎?
若只在 loss 乘上與原字 label 無關、對所學時間為正的 ,固定 input 下的最佳機率表仍是 posterior。有限模型會共用參數,權重仍可能影響實際學習。這裡先用容易理解的 CE 建立模型;U4.3 的補充再從 discrete diffusion 的 ELBO 解釋特定 weighting。
展開細節換成 uniform,能沿用同一個建構嗎?
可以。對 ,在生成方向選擇「以 rate 重設成原字」。這個操作對候選 的淨變化為
因此它也實現同一條 conditional PMF path。對所有原句取 posterior average 後,對 有
MASK 時,已見字的原字 posterior 是 point mass,所以不能再跳;uniform 時,當前字也可能被換掉,所以所有位置都可能需要預測。Training 可以對所有位置計算 CE。
這是一個實現指定 path 的生成規則。Uniform D3PM 的 forward chain 可以反覆重抽,反轉它會得到另一個 generator;兩者雖可有相同 snapshots,不能宣稱 trajectory law 相同。
展開細節若 source 不是 iid noise,端點配對要怎麼加入?
先抽配對 , 是 data、 是 source; 指定兩端如何配在一起,兩個 marginals 分別是所需的資料與 source 分布。固定兩端,令
各位置條件獨立,再按端點配對混合:
同樣可以選擇生成方向以 的 rate 重設成 data token,再對兩端的 posterior 平均。正文的 iid noise 版本,相當於令 source 與 data 獨立,再將 source 平均掉。
配對不同,中間 PMF 與 endpoint posterior 可能不同;這不等於 U3 的幾何拉直,也不保證有限模型更容易學。這裡仍沿用 ;原 DFM 論文 [1] 的時間方向相反,不能直接照搬其下標。
展開細節閱讀應用論文時,要對照哪些設計?
先看狀態、中間 PMF、模型輸出與 sampler。例如 MDLM [3] 用 absorbing masking 和原字預測;Multiflow [2] 同時處理蛋白質的離散序列與連續結構;DiGress [4] 對圖的 node、edge 類別設計離散 corruption。
類別合法不代表化學或生物限制必定滿足;除了 path 與模型,仍需檢查任務條件與評估方式。
快速回顧一下
參考文獻
- Gat, I. et al. Discrete Flow Matching. NeurIPS 2024.
- Campbell, A. et al. Generative Flows on Discrete State-Spaces: Enabling Multimodal Flows with Applications to Protein Co-Design. ICML 2024.
- Sahoo, S. S. et al. Simple and Effective Masked Diffusion Language Models. NeurIPS 2024.
- Vignac, C. et al. DiGress: Discrete Denoising Diffusion for Graph Generation. ICLR 2023.