
U4.3 有了模型,要怎麼一步步抽出句子?
本篇重用5 篇
現在真的從全 MASK 開始
在 U4.2,我們學到 denoiser ,並把它接到生成 rate。對目前為 MASK 的位置,模型使用
這裡用 區分網路近似與理想 rate。既然 對所有原字加總為 ,每個 MASK 的總 reveal rate 就是 ;翻成哪個字,再按 抽樣。已填位置直接保留。
讓 表示真正生成的隨機序列, 是某次抽到的結果。Reference noisy state 用來製造 training pairs; 則是從 noise 出發、依模型走出的過程,兩者先不要視為相同。若 ,生成起點 是確定的全 MASK。
模型給的是每單位時間的 rate,
電腦一次走一小段時間時,應該怎麼抽下一句話?
先把一小步的轉移寫出來
對兩個不同的完整序列 ,rate 的定義給出
留在 的機率,則是 減掉所有跳走的機率。先只看一個 MASK 位置,省略高階項後,這一步使用的機率表為
也就是先決定這一格是否翻開,再按預測抽原字。這是只用步首 rate 的一階小步規則;至少需要 ,才不會出現負機率。完整序列若用「一步最多跳一次」的轉移表,還要用整句的總流出 rate 檢查步長。
實作也可以讓各位置依同一份舊 context 平行更新。一小段時間內兩格都改變的機率是高階項,所以在適當條件下可作小步近似;有限大步時,這不等於精確模擬整個跳躍過程。真正跳出一個字後,其餘位置的 posterior 可能已經改變。
MASK 的翻開機率,能不能直接算一整段?
可以,這條 path 有更直接的答案。先固定原文,從 到 加噪時,仍可見的比例由 降成 ;兩者之差是這段時間才首次被遮的質量。現在已知這格在 是 MASK,所以在比例 的群體裡,倒著走應翻開的比例是
例如 、,要補回 的總質量,而當下 MASK 有 ,所以每個 MASK 以 機率翻開。這個式子描述整段機率,不必把 rate 乘上大步長。
它也能由 rate 積分得到。沒有翻開的存活機率為
第二行用了 。總 reveal rate 不依賴句子的字,所以「是否翻開」能精確算整段;翻出的 token 如何搭配,還是另一個問題。
例如選 ,就有 。這個特殊 schedule 下,一階的 恰好等於整段翻開機率;不能因此把所有 schedule 的 rate 乘步長都當成精確式。
補充凍結 rate,再抽 exponential waiting time 呢?
若把步首總 rate 凍結一整段 ,翻開機率會是 。它在小步時等於 ,卻一般不同於積分實際隨時間變化的 rate。對 ,兩者分別是 與 。實作 B 會把這個時間近似單獨量出來。
把預測和抽樣接成完整流程
選時間格點 。每一段先讓模型看目前整句,再決定哪些 MASK 翻開,並依各格預測抽 token。更新完 context,下一段要重新預測。
從全 MASK 生成一次序列
數學 pipeline
對每段 ,從目前序列 開始:
各 MASK 的翻開硬幣與 token 抽樣,在給定這份 後各自獨立。對所有時間段重複,最後輸出 。在 下,最後一段的 ,所以剩下的 MASK 都會被填完。
Pseudocode
輸入:模型 f_theta、時間格點 1 = t[N] > ... > t[0] = 0
x ← 全 MASK 的長度 L 序列
for n = N, ..., 1:
  t ← t[n]; s ← t[n-1]
  old ← copy(x)
  prediction ← f_theta(old, t)
  w ← (alpha(s) - alpha(t)) / (1 - alpha(t))
  for ell = 1, ..., L:
      if old[ell] == MASK:
          以機率 w,按 prediction[ell] 抽一個 token 放進 x[ell]
      # 原本已填的位置保留;這一步所有預測共用 old
return x
這是一趟生成。獨立重跑 趟,得到 ;這批樣本的 empirical PMF 是
增加 會讓我們看清固定模型與 sampler 的輸出分布。它是否接近 ,仍取決於模型和抽樣規則;反覆生成本身不會消除它們的偏差。
互動 demo:觀察每段翻開後,新的可見字如何成為下一段的 context。每次完整執行只產生一串;需要重複抽樣,才能比較輸出分布。
課堂提問Q1
既然 是精確的,模型也可能精確學到每格的 posterior,那一次把所有 MASK 都獨立填完,是否就是精確的整句抽樣?
先想一想,再展開看整理後的答案
還不是。這裡精確的是各位置的翻開機率;用理想 denoiser,也能給出各位置的 reverse conditional marginal。但多個位置的答案可能相依,將它們獨立抽出來,仍不等於抽它們的 joint。下一篇會用只有四種原文的例子,算出漏掉這個相依會發生什麼事。
展開細節接回 D3PM:離散時間的矩陣與 reverse posterior
Austin 等人的 D3PM [1] 從 forward Markov chain 建構離散 diffusion。這裡用 表示整數步, 表示對應的連續時間,避免把兩種時間混用。設 ,每列都是 noise PMF,一步轉移為
由 ,兩步相乘仍是 與 的組合;繼續相乘得到
乘積係數表示每步都選保留分支;至少重抽一次後,分布就是 。給定非增的 ,在分母非零時可設 ;已到零時可令後續 。Uniform 的重抽也可能抽回原字,所以這個係數不是最後仍為原字的總機率。
固定原字 、現在 token ,上一整數步為 的 posterior 由 Bayes 得到:
分子是先從 到 再到 的 joint weight;分母是所有到 的機率。D3PM 的 -parameterization,再按 denoiser 對候選原字的機率混合這些已知 posteriors。只在分母為正、與觀察相容的候選上使用;MASK 的可見字則直接複製。
對 MASK,這個 Bayes 計算就回到正文的 。對 uniform,這條反覆重抽的 forward chain,與 U4.2 補充中「生成時重設到資料端」的建構,可以有相同 PMF snapshots,卻有不同的生成 dynamics。
展開細節為什麼 masked diffusion 的 ELBO 也會得到 weighted CE?
固定原句,MASK 的單位置 reverse posterior 與模型 kernel 分別是
未遮位置兩者都複製輸入,KL 為零。被遮位置在 MASK 上的機率相同,只有原字那一項留下:
對整句,已知原文時的 posterior 逐位置獨立,我們也選擇逐位置乘積的 model kernel,所以這個 conditional KL 是各位置的和。沿用 U1.2 的 negative ELBO 分解,將各時間段的 reverse KL 與 reconstruction 項合起來:
是與模型無關的 prior KL,精確全 MASK endpoint 下為零; 包含最後的 reconstruction。Expectation 對原文與其 noisy snapshot 平均。這個 loss 是資料 negative log-likelihood 的上界;它與單純 CE 的逐 input 理想最佳解相同,但權重與 objective 的解讀不同。
在連續時間極限,,因此和式對應以 reveal rate 加權的 masked CE 積分;Sahoo 等人的 MDLM [2] 使用這個 absorbing 結構。推導 ELBO 選用的逐位置 model kernel,並沒有證明真 reverse joint 也能逐位置獨立抽。
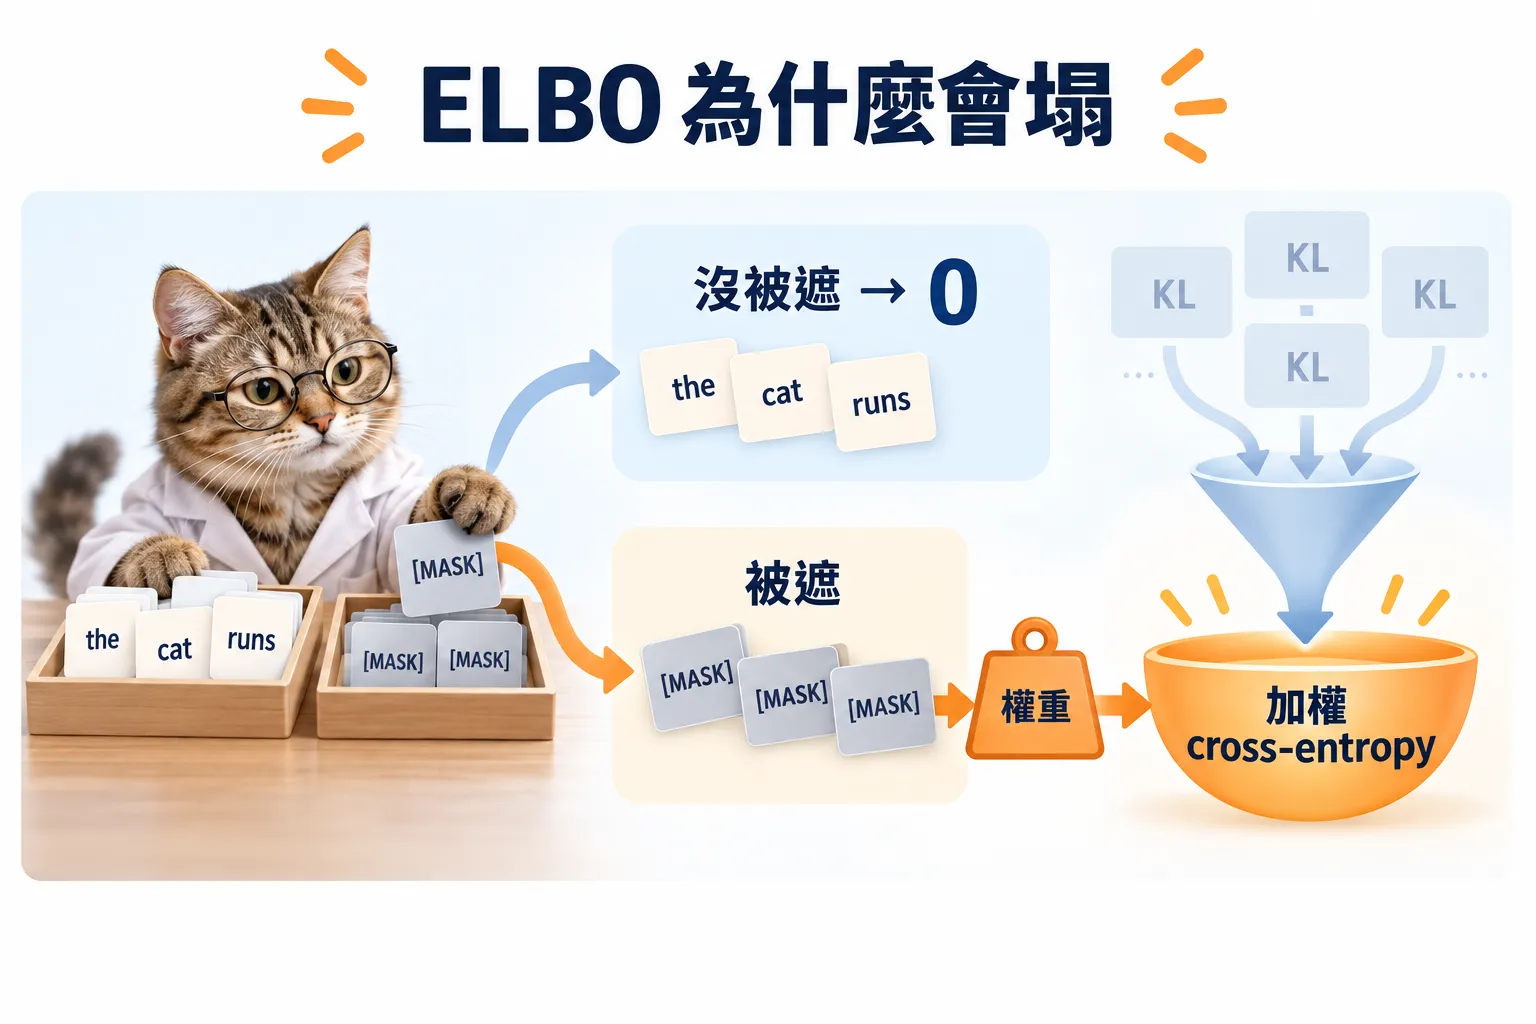
圖:未遮位置的 KL 為零;MASK 項相消,原字項留下已知權重乘上 cross-entropy。
展開細節延伸閱讀:反向 rate、PMF ratio 與 SEDD 是另一種寫法
Forward 的門會開,倒著走該怎麼開?
U4.1 已經用 決定資料怎麼逐漸被破壞。但生成時,我們站在 noisy state ,想問的是:現在落在這裡的樣本,剛才有多少是從另一個狀態 過來的?
沿用房間的例子,A 往 B 的門每個人都能走,但 B 裡的人有多少原本來自 A,還要看 A 與 B 各有多少人。不能把門上的方向倒過來,就宣稱頻率也相同。下面把房間換成完整序列的狀態 ,用 Bayes 算真正的比例。
令 表示生成時,從目前的 跳向 的 reverse rate:經過正的時間長度 ,diffusion 時間從 退到 。對 ,想求的是 ;只在 的狀態使用 Bayes:
Forward 的短時間轉移是 ,且 。除以 再取極限:
式子中的 是原來那扇門:forward 從 走到 ,reverse 才沿它退回去。例如某時刻 、,而 ,則 。同一股流量 ,對來源比例 與 的兩群樣本,就對應不同的每人頻率。
Forward rate 已知;未知的部分是兩個完整狀態的機率比。 Campbell 等人 [5] 用這個時間反轉公式建構 discrete denoising models。接下來的訓練目標,就是要補上這份資料分布的資訊。
兩個狀態之間,要學哪一種比較?
連續空間的 score 告訴我們附近哪裡密度比較高。離散空間沒有「朝某個字移動一點點」,所以先保留一個有限的比較:
這個 ratio 回答「 出現的機率是 的幾倍」。它可以大於 ,例如上面的 ratio 是 ;它也不要求對不同鄰居加總為 。因此,直接預測 ratio 的網路要輸出非負數值,不能把所有 ratio 用 softmax 正規化成一張 categorical distribution。
若只知道未正規化的 weights,分子與分母的共同 normalizing constant 仍會相消。Meng 等人 [4] 提出 concrete score 的離散比較觀點;Lou、Meng 與 Ermon 的 SEDD [3] 直接學這些比值。這裡的新物件是「比較兩個狀態的相對可能性」,不是 token 編號的導數。
符號Concrete score 有兩種常見寫法
原始 concrete score matching 常用 ,也就是本篇 ratio 減 。本篇跟隨 SEDD 使用 ,方便直接乘進 reverse rate。兩者資訊相同,但公式中的常數不能混用。
用 表示把完整序列 的第 格換成 、其他格原封不動。這樣的 就是 的一個鄰居。在逐位置 corruption 的精確 CTMC 裡,一次跳躍只改一個位置;reverse 因此也只需要這些鄰居的 ratio,而不是輸出所有 個序列的機率。這裡的「一次跳躍」與電腦用有限步一次更新多格,是兩個層次。
可是整個 算不出來,Label 從哪裡來?
若要直接把 當 label,就得先知道整個資料分布,這正是我們沒有的東西。不過回想 U1.2 的 conditional trick:卡在 marginal object 時,可以先盤點自己製造 training pair 時還知道什麼。
我們其實不只看到 ,還保有抽到的原文 ,而且已經會算 。所以可以先為這筆 training pair 算一個 conditional ratio label:
同一個 noisy input 可能來自不同原文,這個 label 也可能不同。固定時間 ,只看能產生目前 的那些原文,按它們的 posterior 機率平均會得到什麼?先假設我們比較的鄰居滿足下面補充中的 support 條件,讓分母有定義、約分後也不漏掉原文:
第一步用 Bayes,把「給定 後原文是誰」的 posterior 寫出來;第二步約掉相同的 ;最後分子把所有原文造成的 加起來,正是 。這個 expectation 平均的是固定目前 input 後,仍可能的原文所給出的 labels,不是把所有 noisy inputs 的 ratios 混在一起。
所以,單筆 label 不需要等於 marginal ratio;我們要設計的 loss,是讓固定 input 下的理想最佳輸出等於這些 labels 的 posterior average。下面的 score entropy loss 就完成這個動作。
補充這個約分要有什麼條件?
我們在 的位置使用 ratio,且要求分子有質量的原文也能產生 :
這樣求和才不會漏掉 denominator 為零的原文。Uniform corruption 在內部時間有完整 support;absorbing 則對 reverse 所需的 MASK 字鄰居成立。不能對任意兩個離散狀態,不檢查 support 就直接套公式。
展開細節SEDD 怎麼把 conditional ratio 寫成 training loss?
固定時間 ,以原文 與加噪結果 做一筆資料。把上面的 conditional ratio 簡寫成 label ;模型 則要預測這條鄰邊的 marginal ratio。
SEDD 的 denoising score entropy [3],略去不含 的項後是
這裡對時間、原文與 corruption randomness 平均; 是不依賴未知原文的邊權重。為了看最佳解,固定 ,只把仍可能的 labels 平均,記其平均為 。Scalar loss 便成為 ,對預測值 微分得到 。若 ,它在 唯一最小;若 ,最小值在邊界 ,正值參數化可逼近它。於是最佳預測正好是正文算出的 marginal ratio。
這個機制用到 label 只在線性的 中出現。它不是把 ratio labels 先正規化成類別機率;一般情況下 也不是 。取 ,就會對 reverse 需要的 edges 加權。要解讀成 CTMC 的 likelihood bound,還需保留常數與 prior term。
對 absorbing 的一個 MASK 位置,把正文的 代入,再用 。乘上 masking rate 後,模型相關的那一部分變成
其中 不依賴模型參數: 是常數, 則拆成已知係數的 log 與 。因此在這個參數化下,absorbing score entropy 與 weighted masked cross-entropy 的模型相關部分相同;比較兩組預測的 loss 差值時,常數便相消。這個換算在實作 B 的選讀實驗中檢查。
原本的 masked denoiser,其實已經給了 ratio
先回到熟悉的 MASK,看看這份 ratio 資訊和 U4.2 的猜字機率有什麼關係。令 ,把這格填成 得到 。固定原文 後,、 的其他位置完全相同,所以那些 conditional probability factors 都能約掉。
剩下的第 格,在 中被遮的機率是 ;在 中保持為 的機率是 ,但必須原字本來就是 。因此
符號 在原字是 時為 、否則為 。把這個指示量對仍可能的原文取 posterior average,就是原字為 的 conditional probability,因此得到
因此 U4.2 的 denoiser 可以直接換成 ratio:
Forward 每單位時間要遮掉的總質量是 ,來源可見比例則是 ,所以每個未遮字的 masking rate 為 。將它乘上剛才的 ratio:
所以一個 MASK 的總翻開 rate 是 ,翻成哪個字則按 denoiser 的 categorical distribution 抽樣。Ratio 與 masked posterior,在這條 chain 上是同一份資訊的兩種寫法。
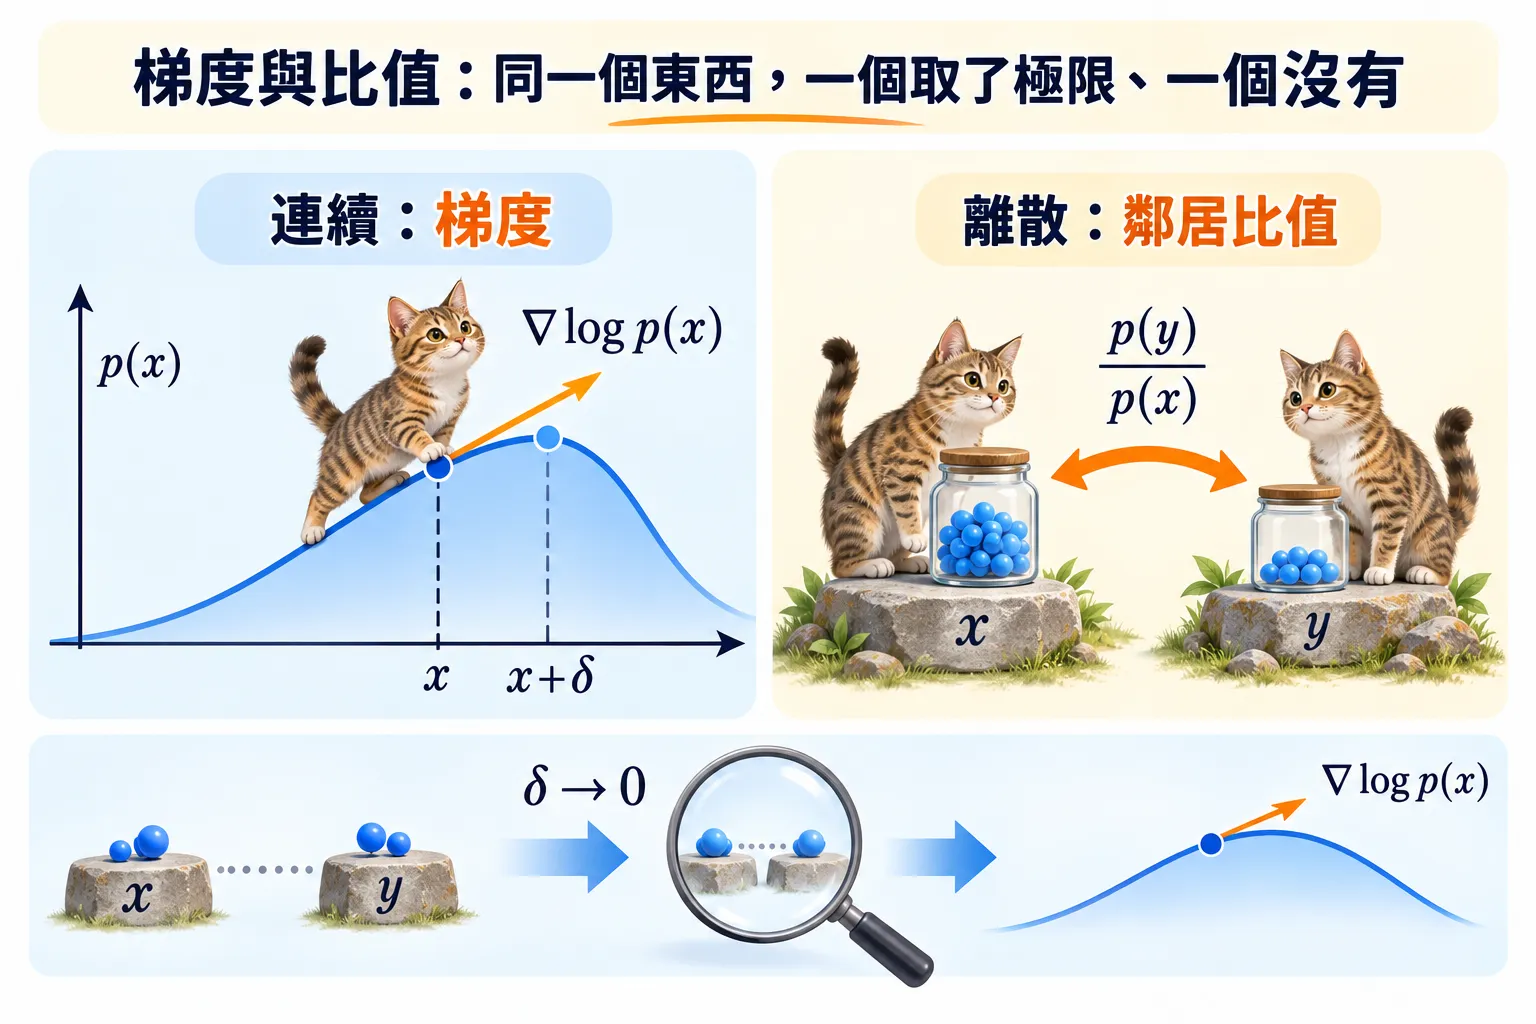
圖:連續空間用局部梯度比較密度;離散空間則比較鄰居的機率比。
快速回顧一下
參考文獻
- Austin, J. et al. Structured Denoising Diffusion Models in Discrete State-Spaces. NeurIPS 2021.
- Sahoo, S. S. et al. Simple and Effective Masked Diffusion Language Models. NeurIPS 2024.
- Lou, A., Meng, C., Ermon, S. Discrete Diffusion Modeling by Estimating the Ratios of the Data Distribution. ICML 2024.
- Meng, C. et al. Concrete Score Matching: Generalized Score Matching for Discrete Data. NeurIPS 2022.
- Campbell, A. et al. A Continuous Time Framework for Discrete Denoising Models. NeurIPS 2022.