
U4.4 每格都猜對,整句話就會對嗎?
本篇重用3 篇
問題可能不在網路
在 U4.3,每個 MASK 都有一個原字的預測分布。我們可以一次呼叫網路,平行填入很多字;這看起來比一格一格生成快得多。但一句話的合理性不是每個字各自合理就夠了:前面選了「一隻」,後面接「貓」或「桌子」,結果並不一樣。
U4.0 已經用「吃/晚餐」與「打/籃球」區分 joint 和 marginals。現在多了一份可見 context:對「我/今天/[MASK]/吃/[MASK]」,第三格和第五格各有一張 conditional marginal PMF;我們需要檢查的是,這兩張表能不能直接組成 conditional joint。
模型可以看整句 context 才算出這兩張表,但若接著各自抽一個詞,這兩次抽樣仍沒有看見彼此剛選的答案。先假設兩張表都完全正確,把網路誤差拿掉:光是把它們獨立抽出來,還可能出錯嗎?
只有 0、1,就能看出差別
考慮長度 的 bit 序列。資料只有偶數 parity,也就是 的數量為偶數:
沒有列出的另外四種序列,資料機率都是 。從全 MASK 看,第一格在四筆合法資料中有兩次是 、兩次是 ;其他兩格也一樣。因此每一格的 conditional marginal 都是 。
如果照這三張正確的表獨立抽樣,某一串(例如 )的機率就是
其他七種排列也各有 ,所以合法的四種加起來只有 。每格各自的 、 比例都對,卻把一半機率放到資料中不可能出現的組合。
另一種做法是先填一格,再根據新 context 算下一格。前兩格可以是 、、、,各有 ;但到最後一格時,已填的兩格會決定答案。例如前兩格是 ,最後一格只能填 ,才能讓 的數量變回偶數。
所以四種合法序列最後各有 ,不合法序列的機率是 。這次不只合法率是 ,整個 distribution 也正確。差別是後一格有機會根據前面剛抽出的結果,更新自己的 conditional。
各格的機率都算對了,
那一次填完時,到底漏掉了什麼?
漏掉的是同一步裡的相依
把上面的差別寫成可比較的兩個分布。令 是已看見的位置集合, 是這一步要填的位置集合; 表示那些可見位置的 token, 表示這次要一起填出的那一組。例如先看見第一格、再同時填後兩格,就是 、。
固定可見的 ,真正需要的是這一組 token 的 conditional joint:
它會替每種搭配分配機率。若每個位置都只根據同一份舊 context 獨立抽樣,實際用的則是各張機率表的乘積:
我們用 KL 比較這兩張「所有搭配的機率表」,再考慮資料中可能看見的不同 contexts。這個量稱為 factorization error(因子化誤差):
外面的 expectation 按 對可見 context 加權;裡面的 KL 則在固定 context 下,對 的各種搭配比較機率。它等於 ,表示在這些 contexts 下,這批位置確實可以 conditional independent 地抽;大於 ,則表示這個乘積漏掉了相依。Zheng 等人 [1] 分析平行 decoding 重用舊 conditional 的近似;這裡先用精確 conditional marginals,將同一步漏掉的相依單獨量出來。
在全 MASK 的 parity 例子,真實 joint 對四種合法序列各給 ,乘積分布則各給 ,所以
即使模型已經完美,這個誤差仍然存在。
補充每個 head 獨立抽樣,不代表網路只能看一個字
Transformer 的每個 output head 可以看整句 context,學到的位置機率也可以完全正確。因子化發生在同一步怎麼抽出多個 token:它們還沒看見彼此剛抽出的答案。問題不是 attention 看不到其他位置,而是 conditional marginals 不能替代 conditional joint。
課堂提問Q1
在 parity toy 裡,先填很多格,最後只剩一格;或者每一步都填得很少,但最後還有兩格一起填。哪一種能保證合法?這表示「步數越多一定越好」嗎?
先想一想,再展開看整理後的答案
用精確 conditional 時,最後只剩一格就能補對 parity;前面怎麼填都還有合法的 completion。若最後兩格一起獨立填,它們的 marginals 仍各半,合法率只有 。
因此這個例子看的是「最後剩下的相依有沒有被一起拆掉」,不是步數本身。增加步數通常讓同時填的格數變少,但不能不看實際的 reveal schedule,就宣稱每次加一步都一定改善。
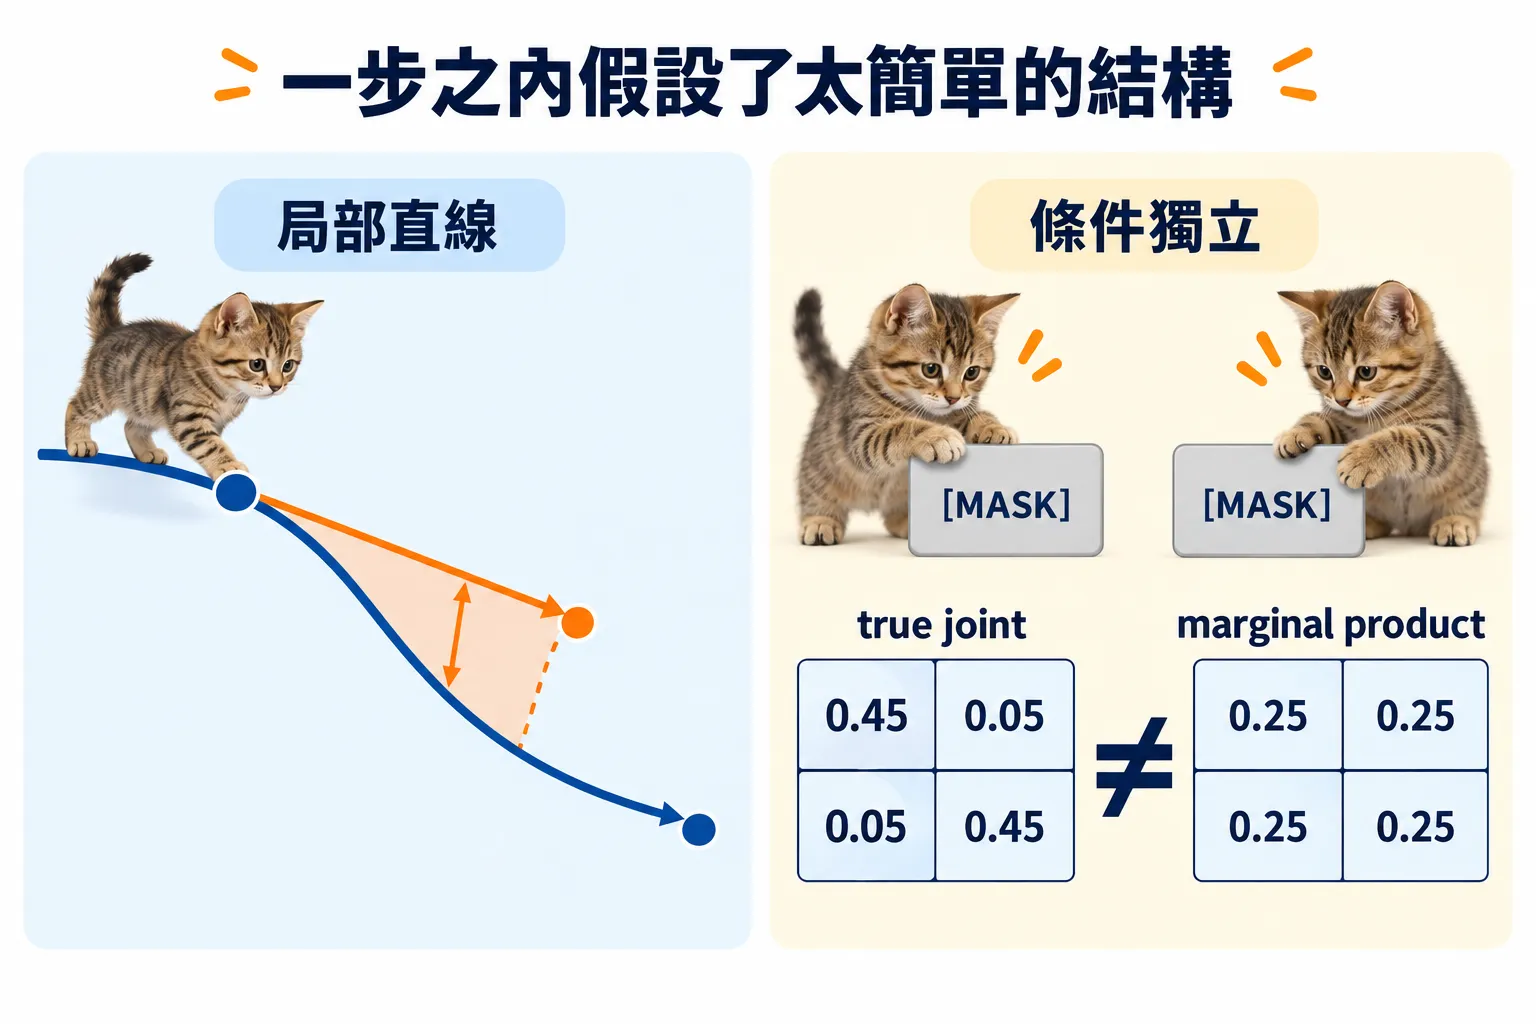
圖:逐格填時,下一格會看見前一格的結果;同時獨立填時,這批 token 之間的限制可能被漏掉。
展開細節每一步的因子化誤差怎麼連到整個生成分布?
先固定一個與資料無關的 reveal partition ,令 是第 步前已填的位置。假設所有 conditional marginals 都精確,生成分布為
真實資料可以按相同順序用 chain rule 分解:
把兩者代入 KL,先拆開 log,再對已填位置取期望:
若 reveal order 本身隨機,這個等式先對固定的 order成立;把 order 平均掉後,由 KL 的凸性,terminal KL 不超過各 order 的 KL 平均。若順序還依賴模型信心,就要另外分析那個選擇規則,不能直接沿用等式。
少填幾格,為什麼會有幫助?
如果 只包含一格,上面的 joint 本來就只有一個變數,和它的 marginal 相同,這一步的 FE 為 。若每次都只填一格並重新計算精確 conditional,就能按照 chain rule 組成正確的整句分布;順序不必固定為從左到右。
平行填字節省的是重新計算 context 的次數,代價是這一批新字沒有彼此條件化。增加步數常讓每批變小,但 parity 的提問已經顯示:要看真正的分組與相依結構,不能只用步數判斷。有限模型還有預測誤差,這也不會因為 FE 變小就自動消失。