
U4.6 實作 A:每格機率都對,整串還會錯嗎?
本篇重用2 篇
怎麼確定錯的是網路,還是抽樣?
前面已經建立 PMF path、rate、denoiser 和 sampler,也用 U4.4 說明:即使每格的 conditional marginal 都正確,一起獨立填完仍可能出錯。要驗證這件事,最直接的方法就是選一個小到可以列出所有合法資料的問題,先把網路拿掉。
這次使用長度 的 bit 序列,每格只能是 或 。資料只允許 的數量為偶數,稱為偶數 parity;例如 與 合法, 不合法。全部 種序列中,一半有偶數個 ,所以資料共有 條,各以 抽到。
這份小資料的好處是:可以直接列出「目前看到的字還可能來自哪些合法原文」,不必先訓練網路。這種直接使用精確答案的預測器稱為 oracle。它在這裡替我們排除 prediction error,讓實驗只比較抽樣規則。
下載實作 A notebook:Discrete diffusion 與 factorization error
Notebook 需要 NumPy 與 Matplotlib,依序執行 cells。程式使用完整列舉的 conditional probabilities;訓練自己的模型是最後的延伸練習。
第一步:找出這張 snapshot 可能的原文
Notebook 用整數陣列儲存序列,以 表示 MASK;這只是程式的標記,不會把 當成有數值距離的 token。先用 U4.4 的三格例子想一次:若看到 ,合法原文只可能是 或 。各有一半機率,因此後兩格各自的 、 比例也是一半。
Joint sampler 會從 、 直接抽一整串;factorized sampler 則依各格的比例獨立抽,還可能得到 或 。這四個動作對應到 notebook 的四個函式:
| 函式 | 計算的物件 |
|---|---|
compatible_states(xt) | 所有與 相容的合法原文 |
exact_conditional(xt) | 每個位置的 、 |
sample_joint(xt) | 從相容原文中抽一整串 |
sample_factorized(xt) | 按各位置 conditional marginal,獨立填入 MASK |
因為資料均勻、absorbing 的同一個 mask pattern 對所有相容原文有相同機率,相容原文的 posterior 也均勻。這就是列舉能直接給出正確 conditional 的原因。
第二步:只換抽樣方式
固定被遮的格數,先從真實資料造出 snapshot,再分別用 joint 與 factorized sampler 填完。對每個設定重複抽樣,量「 的數量為偶數」的比例。
先寫下預測:只剩一格 MASK 時,兩種方法會不會不同?若兩格或更多一起填,factorized 的合法率大約是多少?接著執行比較 cell,再用下面的條件檢查結果。
Joint 直接從合法原文抽,所以每次都合法;只剩一格 MASK 時,parity 唯一決定那格的值,factorized 也會補對。剩兩格或更多時,每格的 marginal 都是一半,獨立填完的偶數 parity 機率則是 。Notebook 每個 MASK 數量重複抽 次,所以看到的比例會在真值附近波動;比較時記錄 seed 與樣本數,別把一次曲線的起伏當成新規律。兩邊都沒有使用網路,因此這個差別來自抽樣結構。
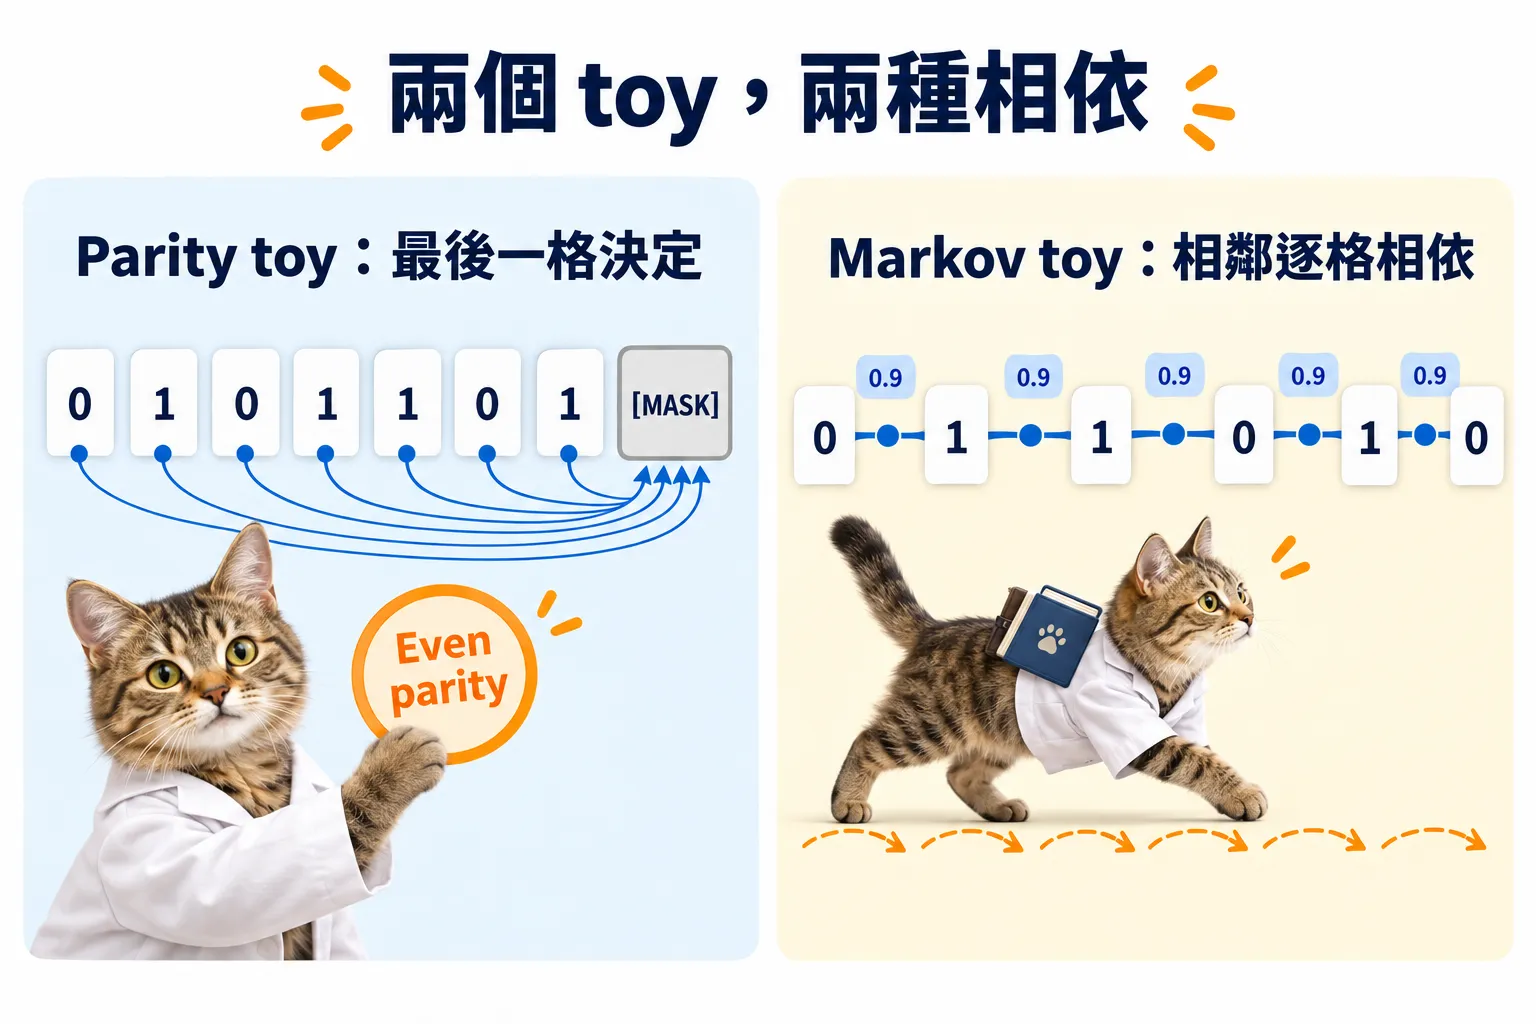
圖:本次先用全域 parity 檢查相依;延伸到 Markov toy 時,相依則分布在相鄰位置。
課堂提問Q1
如果 factorized sampler 的合法率只有 ,把訓練資料增加十倍,這個實驗會改善嗎?
先想一想,再展開看整理後的答案
不會。這裡已經使用真實資料分布算出的精確 conditional marginals,沒有 estimation error 可以改善。要改的是抽樣規則,例如先填一部分、重新計算 conditional,再填剩下的部分;或用能表達 joint dependence 的抽樣方式。這是 U4.4 的結構性誤差。
第三步:把誤差來源分開記錄
Notebook 另檢查 forward MASK 比例是否跟 一致。它回答的是 snapshot 有沒有造對,不是 joint reverse 有沒有抽對。
再換到下面的 Markov toy demo:這次不是 notebook 的全域 parity,而是相鄰 bit 有關係的序列。Demo 把精確 conditional prediction 人為往均勻分布拉一點,做出可控制的 prediction error。先固定每步填字數,只改 prediction error;再固定 prediction error,只改每步填幾格。
把每組實驗記成「預測從哪裡來、每步填幾格、重算幾次 conditional、量什麼統計量」。這樣才能分辨:是給出的機率表偏了,還是把正確的表用獨立抽樣組合時漏掉相依。
Demo 的「模型誤差」是明確設定的 surrogate,不是實際訓練結果。切換率是摘要統計量,不等於整個 distribution 的 KL。
延伸練習
- 把資料改成「 的數量可被 整除」,同時修改合法性判斷。不同 MASK 數量下,哪些位置 marginals 看不出 joint constraint?
- 將一次填完改成每次只填一格,每次都重新查 conditional。確認偶數 parity 的合法率如何改變。
- 訓練自己的 denoiser:輸入 token sequence 與時間,輸出每位置 logits;用 U4.2 的 masked cross-entropy。先比較 logits 的 conditional KL,再放入相同 sampler 比較合法率。這兩個評估分別檢查預測與生成。
- 換成相鄰 bit 有相依的 Markov toy,觀察每步填字數的影響。不要只記步數,也記每步實際填幾格、seed 與抽樣數。
快速回顧一下
參考文獻
- Austin, J. et al. Structured Denoising Diffusion Models in Discrete State-Spaces. NeurIPS 2021.
- Sahoo, S. S. et al. Simple and Effective Masked Diffusion Language Models. NeurIPS 2024.