Mugi 有柴犬臉的柯基
「既然程式能打分,那我們先畫很多張,再留下最高分的那一張。使用者如果明天再來,就把這張拿給他?」
這確實用到了評分,也能挑出高分結果。可是回頭看看使用者的話:他還想要幾張不同的結果。只留下最高分,這個要求有放進來嗎?
從喜歡的照片比例走到連續分布實作;畫出 posterior、平均圖片與 hₜ,檢查 plug-in 省掉的不確定性。
想連著讀? 技能書 連續閱讀版 · U7.2 →
使用者看了幾張雪山上的柯基,說:「這些都沒畫錯,但我比較喜歡這種光線和構圖。可以多給我幾張不同的結果嗎?」他交給我們一個美感程式,輸入完成圖片,就會得到一個分數。
把完成的乾淨圖片記成 ,分數記成 reward ;越高,越符合這次的評分標準。它可以只是美感分數,不必是機率,也不一定能微分;先把「我們希望怎麼抽」說清楚,之後才檢查計算方向所需的條件。這次沒有能看 noisy image 的 classifier,模型也沒學過這個新的偏好。先不急著改 sampler,我們希望這個分數怎麼影響回傳的結果?
「既然程式能打分,那我們先畫很多張,再留下最高分的那一張。使用者如果明天再來,就把這張拿給他?」
這確實用到了評分,也能挑出高分結果。可是回頭看看使用者的話:他還想要幾張不同的結果。只留下最高分,這個要求有放進來嗎?
「如果不想每次都給同一張,那我們像以前一樣抽圖片,多抽幾次就有不同結果了。」
Nori 保留了原本的變化。可是使用者還特別說喜歡某種光線與構圖;如果出現比例完全不變,這次的評分有影響結果嗎?
「我們能不能讓喜歡的照片更常出現,但別把其他合理照片的機會全拿走?例如四次裡比較常看到喜歡的風格,偶爾也能看到別種構圖。」
Lumi 想改的是各種圖片被抽到的比例。這次不只找一張最高分圖片,也不只沿用原本比例。接下來要問:用什麼目標,才能把這個想法說清楚?
使用者希望喜歡的結果更常出現,也希望保留不同的合理答案。哪個做法比較符合這兩個要求?
這能找到高分結果,但每次同一張,沒有表達希望看到不同答案的需求。
提高喜歡結果的出現頻率,仍保留其他可能性,是在選一個新的抽樣分布。
維持原本比例能保留變化,但這次新取得的評分還沒有影響結果。
「如果評分程式特別喜歡一團亮白色,但那團根本不是柯基,我們還想讓它很常出現嗎?」
我們也想保留原本資料的影響。用 表示 base distribution:離散結果是機率,連續圖片是 density。這項告訴我們原本資料在哪些區域有較多權重;它不是另一個美感分數,也沒有保證每個高 density 的結果都好。
為了把原本權重和 reward 放進同一個目標,先用 。Log 把乘法變成加法;後面將會看到,它能接到 distribution 之間的 KL。原本沒有機會的結果,在有限 reward 下也不會只靠重新加權就出現。
先換到訓練情境:手上有獨立抽到的資料 ,正在改的是 model parameters 。這裡的下標 編資料,不是 diffusion 的時間。資料 likelihood 與 log-likelihood 是
Log 嚴格遞增,所以對同一個 likelihood 取 log,不改變最佳參數;還把很多小數相乘改成相加,較容易計算。除以固定的 也不改變最佳參數。用資料平均估計母體期望時,得到 。若相關量有定義,
資料分布固定,最大化平均 log-likelihood 就是在最小化這個方向的 KL。這裡是固定資料、改模型;我們接下來是固定 base、改新抽樣分布 ,別把兩個情境對調。
可是「log 不改變大小順序」能讓我們把 log 和平均交換嗎?假設資料 的機率是 ,模型替 分配 、替 分配 。平均 probability 是 ,會想把 推到 ;平均 log probability 是
在 對 求導,得到 ,為零時 ;二階導數為負,所以這裡最大。它會保留資料裡較少見的 。先平均再取 log,和先取 log 再平均,正在最佳化不同的目標。
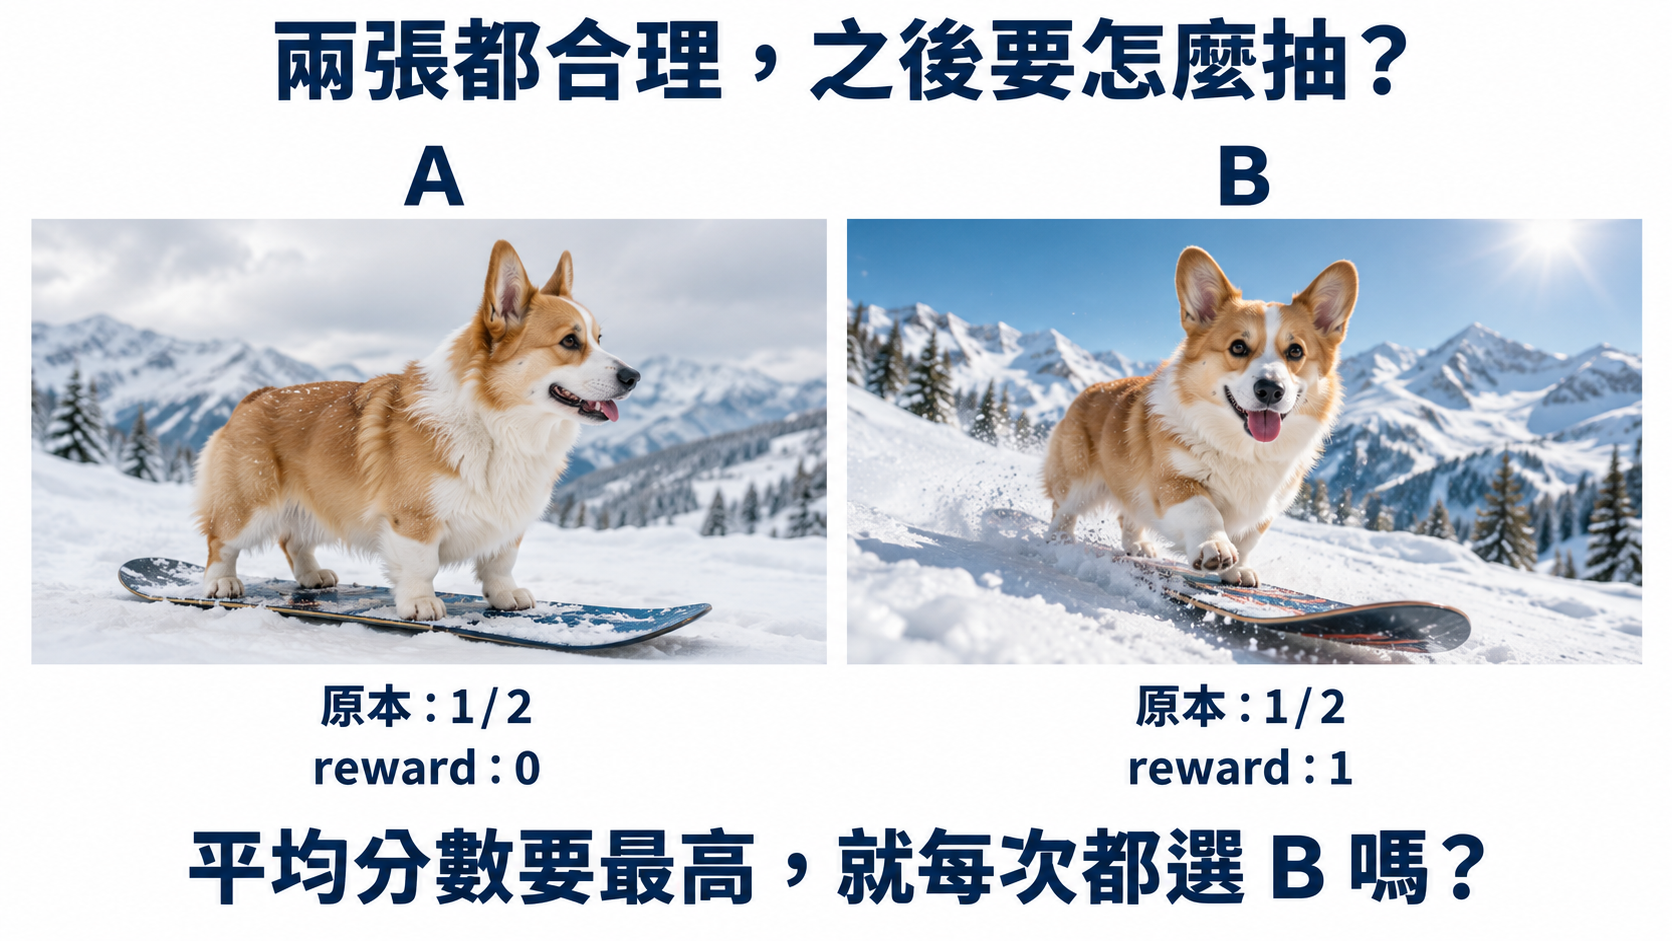
兩張都合理,只是光線和姿勢不同。這裡假設程式比較喜歡 B;機率與評分是例子給定的數字,不是模型實測。
點圖可放大先把可能結果簡化成 ,原本各以 機率出現,reward 分別是 、。把正在選擇的新 distribution 記成 ,它決定之後各種結果出現的比例。
我們想讓 reward 高,也想保留原本資料的影響,於是替每張算 。其中 決定 reward 的影響, 是原本的 base distribution。這裡只有兩個離散結果,兩張原本的機率都是 ;連續圖片才使用 density。
想像反覆從 抽圖片,把這個分數取平均。只要求平均最高,會留下兩張,還是每次都選 ? 先猜一個結果,再想想為什麼。
也可以先在心裡想,再看整理。文字只留在這個頁面,重新載入就會消失。
兩張的 log base probability 都是 ,只有 reward 不同。選 的機率是 ,選 的是 ,兩者加起來為 ,所以平均分數是
只要 ,把更多機率給 ,平均就更高,最後每次都回傳 。兩張原本都合理,但這個平均分數沒有要求保留另一個答案。
若只有有限個候選,把固定的每張分數記成
那新分布的平均 不會超過最高的 。把所有機率放在最高分候選就能達到它;若有多張同為最高分,也可以在它們之間分配,但目標仍不鼓勵留下其他答案。
連續空間要更小心:普通 density 未必能取得單點集中這個最大值,可能只有越來越集中的序列逼近它。共同的缺口是目標只平均固定的逐張分數,沒有額外衡量新分布的集中程度。
剛才同時算了 reward 和 log base probability,最後仍只選 。要表達一開始的完整需求,目標還缺哪件事?
原本的目標只比較每張的分數,再取平均,沒有衡量整個分布是否過度集中。
Reward 已經出現在目標中。增加它的影響,在這個例子只會更偏向 B,沒有補上保留其他答案的需求。
兩張的 base probability 已經放進計算,而且相同。缺口是目標沒有衡量新分布的集中程度。
我們可以用 entropy 描述分布有多不集中,定義為 。在剛才的兩張照片裡,每次都選 時是 ,各占一半時則是 。把它加到目標,不集中在單一答案也能有貢獻:
這裡的 expectation 都平均新 抽出的 。評分程式、base 與 固定;我們改的是各種結果出現的比例。
把 entropy 展開,三項對同一個 平均,目標值就成了
用 ,再想想 log 裡的乘法與除法。你會怎麼把裡面的三項寫成一個 log 比值? 可以先只寫分子和分母。
也可以先在心裡想,再看整理。文字只留在這個頁面,重新載入就會消失。
相加的兩個 log 放在分子,相減的放在分母,得到
看看分子:原本的權重被乘上 ,reward 高的結果會得到較大的倍率。這像是我們想做的重新加權,但乘完後,它已經是機率了嗎?
仍用原本各占 、reward 為 、 的兩張照片。取 ,倍率就是 、,乘完得到 的權重 、 的權重 。你會怎麼解讀?
相對權重可以大於 1,機率不可以;正規化把所有權重的總量調回 1。
B 的數值已超過 1,而且兩張相加是 2,不能直接當成機率。
超過 1 的是相對權重,不代表倍率不能用。要補的是正規化,不必把權重截掉。
把權重的總和或積分記成 ,再除掉它,定義候選 distribution:
對兩張照片, 是權重的總和;對連續圖片,則對所有 積分。假設 且相關期望有定義,這才是一個可用的 distribution。現在還差一步:確認這個候選真的讓剛才的目標最大。
把 A、B 換回 U7.0 的雙峰連續資料。兩種 reward 可以偏右,也可以同時偏好左右兩側;先觀察樣本,再回來證明這個候選為何是最佳解。
先預測,再觀察分布
原本左右各半。乘上 reward 倍率後,只有兩群的份量改變,還是群內的形狀與位置也會改?
A 不加偏好(λ = 0);B 用你選的 reward 與 λ。直接從一維新權重的數值 CDF 各抽 1,000 個樣本。
灰線先畫出原本雙峰資料。執行後才會加上實際樣本;參考曲線不代表已經抽到了它。
用剛才的圖與數字說明
重新加權作用在每個 x₀,會改變群內形狀,不只改類別份量。右側 reward 提高右側與右尾的相對權重;對稱的兩側 reward 則可以保留兩個峰。這個小實驗能用網格正規化和抽樣,完整圖片仍需要後面的方法。
這是標準對照的機制說明;自由改條件或 Python 後,以你實際執行的設定與圖為準。
固定 p_base = ½N(−2,0.55²) + ½N(2,0.55²)。以 [−6,6]、Δx = 0.025 的網格正規化 p_base exp(λR),再反查 CDF 並在格內均勻抽樣。這是一維數值近似,並非 diffusion network。
可以改參數,也可以改抽樣規則。按執行時才載入 Python;運算在你的瀏覽器進行。每次執行從這段程式重新開始,文字不會存檔。
首次展開會帶入上方的控制項設定;之後重開會保留你改過的程式。帶入的是條件,不包含上方累積訓練的參數或生成樣本,因此兩邊的有限抽樣圖不必完全相同。
程式包含相同方法的完整計算與 Matplotlib 分布圖。首次展開套用目前控制項;每次執行重新抽樣。先改最上方一個參數,其他條件保持相同。原生圖不會假裝成你改過的 Python 結果。
import math
import numpy as np
import matplotlib.pyplot as plt

# 1. SETTINGS -- change one, run again, and explain the plotted evidence.
strength = 2
reward_kind = "right"  # "right" or "two"
rng = np.random.default_rng(42)
sigma = 0.55
grid = np.linspace(-6, 6, 481)
dx = grid[1] - grid[0]

# 2. FIXED MODEL -- analytic functions, no network training in this cell.
def pdf(x, mu=0.0, var=1.0):
    return np.exp(-0.5 * (x-mu)**2 / var) / np.sqrt(2*np.pi*var)
def R(x):
    return x if reward_kind == "right" else -(np.abs(x)-2.5)**2
base = 0.5*pdf(grid, -2, sigma**2)+0.5*pdf(grid, 2, sigma**2)
target = base*np.exp(strength*R(grid))
target /= target.sum()*dx  # finite-grid quadrature reference
reference = target
reference_label = "Tilt reference (quadrature on [-6,6])"
extra_figure = None

# 3. GENERATION -- directly invert the finite-grid target CDF.
# This is possible in one dimension; it does not solve high-dimensional sampling.
cdf = np.cumsum(target*dx)
indices = np.searchsorted(cdf, rng.random(1000)).clip(0, len(grid)-1)
samples = grid[indices]+rng.uniform(-dx/2, dx/2, 1000)
print("Reference mass:", target.sum()*dx)
print("Target mean reward:", np.sum(target*R(grid))*dx)

# 4. PLOT AND CHECK -- the histogram is from the samples above.
fig, ax = plt.subplots(figsize=(8, 3.6))
ax.plot(grid, base, "--", color="gray", label="Original base")
ax.plot(grid, reference, ":", color="black", label=reference_label)
ax.hist(samples, bins=np.linspace(-6,6,49), weights=np.ones(len(samples))/(len(samples)*0.25), alpha=0.5, label="Actual generated samples")
ax.set(xlabel="clean x0", ylabel="density", xlim=(-6,6))
ax.legend(fontsize=8)
fig.tight_layout()
print("Outputs:", len(samples), "mean:", np.mean(samples), "right share:", np.mean(samples > 0))
print("Outside the plotted window:", np.sum(np.abs(samples)>6))
plt.show()用 代回剛才的 log 比值。拆出不隨 改變的 ,剩下的是對 平均 ,即負的 KL:
KL 衡量這兩個分布的差異,非負,兩者相同時為零。固定 base、reward 與 ,怎麼選 ,才能讓目標最大?
目標扣掉一個非負量,當它為零時最大。改變的是新分布,不是固定的評分程式或 base。
KL 在目標中被減掉。越大,目標值反而越小。
這次固定 base、reward 與強度,Z_R 已由它們決定,不隨正在選的新分布改變。
「現在我們有一個新比例了。它偏向使用者喜歡的風格,也沒有完全忘記原本模型的分布。那『別偏離原本太遠』,能不能直接寫在目標裡?」
可以。把 entropy 和 log base 合起來,它們等於負的 KL。剛才的目標除以正的 ,不改變最佳解,就得到
因為展開 KL 的定義,
這次 KL 的方向和剛才訓練例子不同:平均的是正在選的 。
越大,這個寫法裡偏離 base 的懲罰係數越小。我們願意讓偏好有更大影響,但還不能因此說圖片更合理。
也可以考慮最大化 ,但要求 。 是容許的偏離程度。
用正的乘子 ,把限制放進 Lagrangian:
最後的 不隨 改變,所以固定乘子時,它和剛才的 KL 懲罰式有相同最佳解。可是不能隨便指定 ,就宣稱兩題相同。
例如若 的 KL 有限,取 。由 最佳可得,任何符合限制的 都滿足
因此這個配對的 下, 也解了限制版問題。這才是兩種寫法接起來的理由。
假設看到觀測 ,例如一張真的收到的模糊照片。用 描述某張原圖產生這個觀測的可能性,令 、。那
只要 ,正規化後就是 Bayes posterior 。這裡 是觀測,和「想要柯基」的 condition 不同;也別和稍後「給定 sampling 中的 」的 base posterior 混在一起。觀測只是在這個例子裡透過 log-likelihood 成為一種 reward。
固定同一個 prompt,把 看成回答、 看成原本的回答分布。常見的偏好目標是
控制保留 reference 的程度。對這個理想 distribution 問題,,最佳解的相對權重就是 。這和 RLHF 的 KL regularization 有相同結構。
真正訓練文字模型時通常更新 policy parameters,還有模型能力與最佳化的限制;一些完整訓練目標另有預訓練項。因此不能把這個理想最佳分布當成所有 RLHF 演算法的精確結果。這裡的工作則是保留生成模型參數,想辦法改 sampling。
回到兩張都合理的照片。 原本各占一半,reward 分別是 ;取 ,剛才算出的未正規化權重是 與 ,總量是 。
我們已經寫下希望的比例,你選的回傳規則真的會抽出它嗎? 先猜 會占多少,自己選擇照原本比例抽、每次取最高 reward,或按新權重抽。跑過一次後,換一條規則或改變原本的比例,再比較結果。
一組可對照的示範
A、B 原本各占一半,reward 分別為 0、1。取 λ = log 3,新權重是 1/2 與 3/2,目標比例為 A:25%、B:75%。原樣抽仍是各半,每次取最高 reward 則只回傳 B;依新權重抽,才在這個兩結果例子中得到目標比例。
這是只有 A、B 的離散模型,假設能直接按指定權重抽樣。選最高 reward 是在可出現的結果中取最大值,與有限候選的 Best-of-N 分開。
可以改參數,也可以改抽樣規則。按執行時才載入 Python;運算在你的瀏覽器進行。每次執行從這段程式重新開始,文字不會存檔。
首次展開會帶入上方的控制項設定;之後重開會保留你改過的程式。帶入的是條件,不包含上方累積訓練的參數或生成樣本,因此兩邊的有限抽樣圖不必完全相同。
import math
import random

base_b = 0.5
strength = 1.0986122886681096
rule = "tilt"  # "base", "best", or "tilt"
trials = 1000
rng = random.Random(42)

# Reward(A) = 0; Reward(B) = 1.
weights = [1 - base_b, base_b * math.exp(strength)]
target_b = weights[1] / sum(weights)
if rule == "base":
    return_b = base_b
elif rule == "best":
    return_b = float(base_b > 0)
else:
    return_b = target_b

samples = rng.choices(["A", "B"], weights=[1 - return_b, return_b], k=trials)
print(f"Target B: {target_b:.1%}")
print(f"Rule B: {return_b:.1%}")
print(f"Observed B: {samples.count('B') / trials:.1%}")這個比例同時使用 base 和 reward。若原本兩張不一樣常出現,得把各自的原本權重一起乘進去,不能只比較 reward 誰高。倍率差得很大時,也可能大幅放大原本 density 很低的區域;有 base 不等於每張結果都合理的保證。
這裡用理想的 說明目標。實際生成使用學到的模型,原本的 model error 也仍得考慮。接著回到途中提醒:評分程式只會看完成圖片,眼前卻還是 noisy image。
先假設在乾淨端,base 和 reward 都可微分。 取 log,再對乾淨圖片求 gradient,就得到
「原本方向加上 reward 的方向」,看起來很像 U7.1,對吧?若 reward 是 、,也的確接回乾淨端的 conditional score。
可是我們現在沒有完成的 ,只有 。把下標從 換成 ,就能拿同一個 reward 評 noisy image 嗎?先看看眼前這張模糊圖片,可能來自哪些乾淨照片。
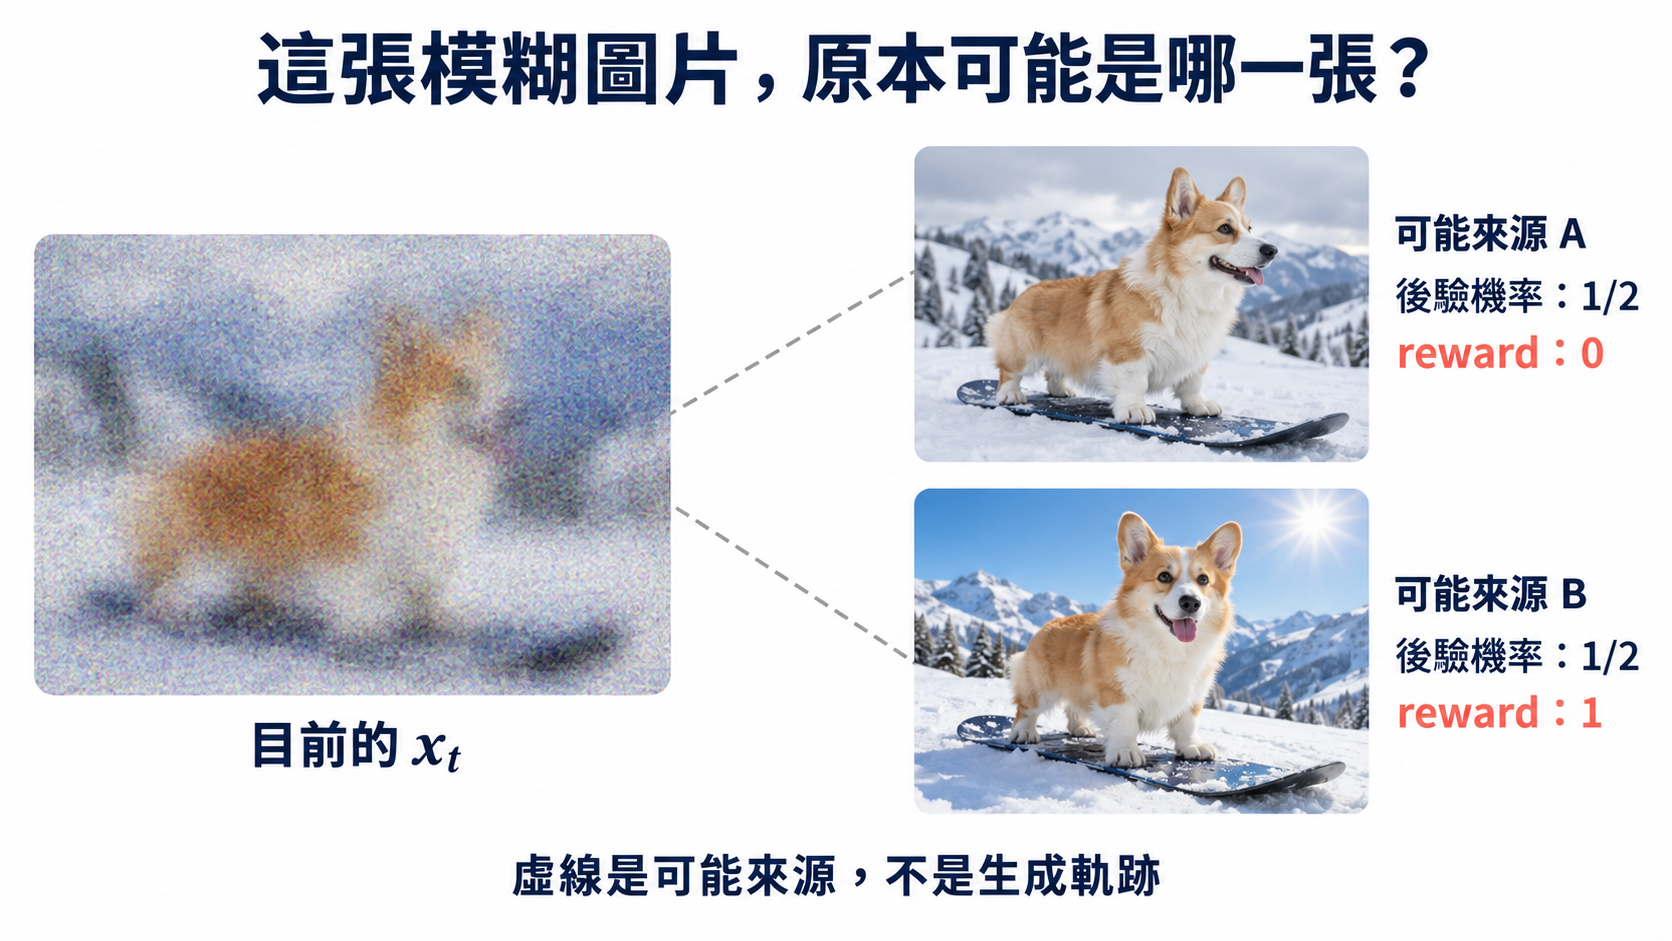
現在固定同一張 。看過它之後,A、B 各有一半可能,是另外給定的條件;不能只由前面 base 各半推出。
點圖可放大這張 原本可能來自 ,也可能來自 ,兩個乾淨來源的 reward 不同。要把完成圖片的新權重帶到這裡,你會先做什麼?
每個可能來源都有自己的機率和 reward 權重,不能在還不確定時只選定其中一個。
原本模型提供 base 的資訊,但新取得的評分程式沒有自動進入計算。途中忽略它,不會因此得到新的目標分布。
美感程式原本看的是完成照片的構圖與光線,現在卻收到模糊的噪聲。即使它輸出一個數字,也沒有保證是在衡量我們原本的要求。 定義在乾淨的 ,不表示也能直接判斷 。
同一個模糊輪廓可能來自不同的照片,reward 也可能不同。要把乾淨端的目標接到途中,就得處理這些可能來源。
想知道新 對應哪群 noisy images,可以先從它抽乾淨圖片,再用原本 forward process 加噪。沿用 conditional density ,它描述給定乾淨來源後,加噪的圖片如何分布。將所有來源的貢獻加起來:
這裡積分的是可能的乾淨來源 ,眼前的 固定。把 代入後,下一步就能把這些來源改寫成「看過目前圖片後的可能性」。
代入 後,積分裡有 。它們形成 base 的 joint density,Bayes 讓我們反過來寫:
固定眼前的 ,對所有來源 積分時,哪一項可以提出來?
積分變數是乾淨來源;base 在固定 noisy image 上的 density 不依賴這個來源變數。
不同乾淨來源有不同的可能性。這個 posterior 正是用來給來源加權的,不能整個提出積分。
A、B 的 reward 倍率就不同。它依賴我們正在積分的乾淨來源。
提出 後,剩下的平均權重記成 :
這個 expectation 可以讀成:「已經看到這張 ,它原本可能是哪張乾淨照片?先替每個來源算 reward 倍率,再按可能性加權平均。」用的是 base 的 posterior ,不是已經被 reward 改過的 posterior,也不是所有資料的平均。
圖中兩個來源在 base posterior 下各有一半可能,reward 是 、。仍取 ,倍率是 、。這張 的 應該怎麼算?
h_t 定義為 reward 倍率的條件平均,保留兩個來源的貢獻。
程式比較喜歡 ,但這張 不一定來自 。目前 base posterior 仍說兩個來源各有一半可能,直接取最大倍率,就拿掉了另一個來源的貢獻。
要算的是所有可能來源的平均權重,不是最好的一種可能有多高分。
先平均 reward,得到 ,再算 exponential 倍率,確實會得到 。但先算兩個倍率,再平均,得到的是 。
Exponential 是非線性的,這兩個順序不一定相同。這次 的定義先算各個來源的倍率,再用 posterior 平均;要保留這個順序。
「把所有可能來源都算進來,好像很難。我們不是已經有 denoiser 嗎?能不能先把目前的圖去噪,再交給美感程式?」
回頭看加噪規則 。若網路預測這次的 noise,把預測的 noise 扣掉,再除回訊號的縮放,就得到
這裡 、。在 squared-error noise training 的理想估計下,這是 base posterior mean ;真正網路還有估計誤差。它提供一張乾淨估計,不是已經找回唯一的真實來源。
Mugi 想用 ,替代我們需要的 。這會省去哪些計算,又可能省掉什麼資訊?
回想剛才的去噪估計 :理想上,它先平均了各個可能來源。Mugi 想只替這張估計評分,用 代替先算各個來源倍率再平均的 。一張平均估計,會保留所有可能來源的平均權重嗎? 可以從剛才平均與非線性操作的順序想起。
也可以先在心裡想,再看整理。文字只留在這個頁面,重新載入就會消失。
把高維圖片暫時換成一個數字: 是 、 是 ,看過 後仍各有一半可能。令 、,兩個來源的 reward 與倍率就和剛才相同。
先平均資料,得到 ;再計算它的倍率:
先替每個來源算倍率再平均,剛才得到的是 。即使這個 reward 是 linear function,外面的 exponential 也使兩種順序不同。真實圖片的 reward 通常還是 nonlinear 的,更不能預設相同。
只用一張 denoised prediction 代替所有來源的平均,稱為 plug-in approximation。它沒有保留來源的不確定性,省掉的不是只有正規化常數。
把目前的 xₜ 固定,看看可能的乾淨來源與它們的平均位置。下方另外畫出 hₜ 和 plug-in 隨 xₜ 改變的函數;先用圖理解丟掉了哪些不確定性,再求方向。
先預測,再觀察分布
固定眼前的 xₜ = 0,噪聲增加後,可能的乾淨來源如何改變?平均圖片的 reward 倍率,會等於所有來源倍率的平均嗎?
A 用較低 noise level t = 0.08;B 用你選的 t。兩次固定同一個 xₜ、reward 和 λ。
灰線先畫出原本雙峰資料。執行後才會加上實際樣本;參考曲線不代表已經抽到了它。
用剛才的圖與數字說明
Posterior 平均的是可能乾淨來源;hₜ 先對每個來源算 exponential 倍率再平均。Plug-in 先平均位置再評分。兩團資料的平均可以落在低 density 區,丟掉不確定性;非線性使兩種順序不同。下方是權重函數,不是 density,也沒有把它們當成已生成的分布。
這是標準對照的機制說明;自由改條件或 Python 後,以你實際執行的設定與圖為準。
用已知 Gaussian mixture 的 Bayes posterior,真的抽 1,000 個可能來源;hₜ 用解析 Gaussian 積分計算,plug-in 用解析 posterior mean。這裡觀察的是同一張 noisy state 的不確定性,沒有使用已被 reward 改過的 posterior。
可以改參數,也可以改抽樣規則。按執行時才載入 Python;運算在你的瀏覽器進行。每次執行從這段程式重新開始,文字不會存檔。
首次展開會帶入上方的控制項設定;之後重開會保留你改過的程式。帶入的是條件,不包含上方累積訓練的參數或生成樣本,因此兩邊的有限抽樣圖不必完全相同。
程式包含相同方法的完整計算與 Matplotlib 分布圖。首次展開套用目前控制項;每次執行重新抽樣。先改最上方一個參數,其他條件保持相同。原生圖不會假裝成你改過的 Python 結果。
import math
import numpy as np
import matplotlib.pyplot as plt

# 1. SETTINGS -- change one, run again, and explain the plotted evidence.
strength = 2
noise_time = 0.35
observed_x = 0
reward_kind = "two"  # "right" or "two"
rng = np.random.default_rng(42)
sigma = 0.55
grid = np.linspace(-6, 6, 481)
dx = grid[1] - grid[0]

# 2. FIXED MODEL -- analytic functions, no network training in this cell.
def pdf(x, mu=0.0, var=1.0):
    return np.exp(-0.5 * (x-mu)**2 / var) / np.sqrt(2*np.pi*var)
def Phi(x):
    return 0.5 * (1 + np.vectorize(math.erf)(np.asarray(x) / np.sqrt(2)))
def R(x):
    return x if reward_kind == "right" else -(np.abs(x)-2.5)**2
def moments(t):
    a = np.exp(-8*t)
    return np.sqrt(a), a*sigma**2 + 1-a
def sigmoid(v):
    return np.exp(-np.logaddexp(0, -v))
def post_params(x, t):
    signal, var = moments(t)
    right = sigmoid(4*signal*x/var)
    gain = signal*sigma**2/var
    left_mu = -2 + gain*(x + 2*signal)
    right_mu = 2 + gain*(x - 2*signal)
    variance = sigma**2*(1-np.exp(-8*t))/var
    return right, left_mu, right_mu, variance
def posterior_mean(x, t):
    w, m0, m1, v = post_params(x, t)
    return (1-w)*m0+w*m1
def h(x, t):
    if t == 0:
        return np.exp(strength*R(x))
    w, m0, m1, v = post_params(x, t)
    if reward_kind == "right":
        return (1-w)*np.exp(strength*m0+0.5*strength**2*v)+w*np.exp(strength*m1+0.5*strength**2*v)
    d = 1+2*strength*v
    def component(mu):
        result = 0.0
        for side in [-1, 1]:
            center = (mu+2*strength*v*side*2.5)/d
            factor = np.exp(-strength*(mu-side*2.5)**2/d)/np.sqrt(d)
            result += factor*Phi(side*center/np.sqrt(v/d))
        return result
    return (1-w)*component(m0)+w*component(m1)
base = 0.5*pdf(grid, -2, sigma**2)+0.5*pdf(grid, 2, sigma**2)
target = base*np.exp(strength*R(grid))
target /= target.sum()*dx  # finite-grid quadrature reference
reference = target
reference_label = "Tilt reference (quadrature on [-6,6])"
extra_figure = None

# 3. POSTERIOR -- sample possible clean sources of this fixed noisy observation.
w, m0, m1, v = post_params(observed_x, noise_time)
samples = np.where(rng.random(1000) < w, m1, m0)+np.sqrt(v)*rng.normal(size=1000)
reference = (1-w)*pdf(grid, m0, v)+w*pdf(grid, m1, v)
reference_label = "Base posterior p(x0 | xt)"
mean = posterior_mean(observed_x, noise_time)
exact = h(observed_x, noise_time)
plugin = np.exp(strength*R(mean))
print("Posterior mean:", mean, "h_t:", exact, "plug-in:", plugin)
extra_figure, ax = plt.subplots(figsize=(8, 3.2))
ax.plot(grid, h(grid, noise_time), label="h_t: average the reward MULTIPLIERS")
ax.plot(grid, np.exp(strength*R(posterior_mean(grid, noise_time))), label="plug-in: score the posterior MEAN")
ax.axvline(observed_x, color="gray", linestyle=":")
ax.set(xlabel="noisy observation x_t", ylabel="weight (not density)")
ax.legend(fontsize=8)
extra_figure.tight_layout()

# 4. PLOT AND CHECK -- the histogram is from the samples above.
fig, ax = plt.subplots(figsize=(8, 3.6))
ax.plot(grid, base, "--", color="gray", label="Original base")
ax.plot(grid, reference, ":", color="black", label=reference_label)
ax.hist(samples, bins=np.linspace(-6,6,49), weights=np.ones(len(samples))/(len(samples)*0.25), alpha=0.5, label="Actual generated samples")
ax.set(xlabel="clean x0", ylabel="density", xlim=(-6,6))
ax.legend(fontsize=8)
fig.tight_layout()
print("Outputs:", len(samples), "mean:", np.mean(samples), "right share:", np.mean(samples > 0))
print("Outside the plotted window:", np.sum(np.abs(samples)>6))
plt.show()現在得到的關係是 。沿用 U7.1 的做法,先取 log,再對目前圖片 求 gradient。
不隨圖片改變,base 那一項給出原本的 score。這次額外的方向應該來自哪一項? 先試著寫出新目標的 score。
也可以先在心裡想,再看整理。文字只留在這個頁面,重新載入就會消失。
逐項微分後得到
額外方向來自 的 log-gradient:改動目前圖片時,它相容來源的平均權重如何變化。真正的 很難算,所以常見做法還會把它換成剛才的 plug-in。
假設 reward 和去噪估計都可以微分。現在用 取得修改線索,但兩個網路的參數保持固定。哪個計算會提供目前圖片的方向?
Input gradient 可以穿過固定的網路。參數不更新,不表示輸出對輸入的導數是零。
那會改變生成模型本身,沒有保留這次固定參數的限制。
如果固定去噪估計,不讓它隨目前圖片改變,就省掉了這段輸入依賴。還需要去噪估計對目前圖片的導數。
因為 plug-in 的 log 是 ,我們把額外方向近似成
現在把「沿著整段依賴求導」寫清楚。Chain rule 給出
右邊 reward 的 gradient,描述乾淨估計怎麼改會提高分數;Jacobian 則描述目前 noisy image 改動時,乾淨估計怎麼跟著變。乘起來,才轉回我們現在能改動的 。固定 ,仍能計算這個 input gradient。
剛才的例子已經顯示兩種權重不同,所以不能把這個近似直接當成 exact tilt。即使取得精確 score,真正抽樣也要配合目標的起始 noisy distribution 與 reverse dynamics;模型估計、有限 noise 與有限步 sampler 的近似仍需要檢查。
同一個重新加權關係在起點 也成立:
若 forward process 已完全忘記乾淨來源, 和 獨立,則
於是 ,可用同一個 base 起點。但有限的 noise 未必達到完全獨立;即使每一步的 score 很準,從不相符的起始分布出發,仍不能只靠「方向對了」宣稱 exact sampling。
一條常見的實用路線,是把 noisy image 轉成 denoised prediction,再讓外部可微分的要求提供方向;Universal Guidance 討論了這類使用方式。我們剛才把它和 exact posterior average 分開,是為了看清楚省掉來源不確定性這一步。
例如 Calibrated Test-Time Guidance 分析常見近似如何使 Bayesian posterior sampling 出現偏差,並提出在其條件下的一致估計;Are We Really Tilting? 則在 Gaussian/mixture 的例子中,分開分析選到哪些 modes、mode 內是否過度追求 reward,並研究 reward damping。這些結論要連同各自的假設讀,不能擴大成任意 reward 與 sampler 都有相同保證。
後續可以改善 posterior 的近似、調整方向的強度或限制更新,讓結果更符合需求。但「平均 reward 變高」只檢查一個量;偏好方向可能過強,原本合理但分數較低的模式也可能變少。判斷方法時,仍要分開看 reward、合理性、多樣性,以及它是否真的抽到定義的 target。
我們用 plug-in guidance 生成一批圖片,平均 reward 比以前高。只靠這個數字,就能證明 sampler 抽到剛才定義的 嗎?
回到你剛才的實驗,選一組 λ 和 reward。引用目標曲線、生成直方圖,以及 posterior mean 或 hₜ 的一個數字,說明「分數較高」「權重定義正確」「實際抽到目標分布」各需要什麼證據。
也可以先在心裡想,再看整理。文字只留在這個頁面,重新載入就會消失。
平均 reward 只回答評分指標。曲線的正規化與推導回答目標如何定義。要檢查抽樣,還得對照整個分布的比例、形狀與被漏掉的區域;一維直方圖有有限樣本波動,也不能替真實圖片提供同樣的精確檢查。
原本 的機率現在改成 、,reward 仍是 、,,倍率仍是 、。重新加權後,哪個比例才符合我們的目標?
A 原本比 B 常見三倍,B 的 reward 倍率又是 A 的三倍,乘起來得到相等的權重。
這是忘了乘原本機率、只看 1:3 倍率時的答案。現在的 base 比例已經不同了。
這保留了原本比例,卻沒有把 B 的三倍倍率算進去。
回到兩張都合理的照片,我們想讓喜歡的結果更常出現,也保留其他答案與 base 的影響。Reward tilting 定義了新的比例;生成途中則得把相容的乾淨來源一起考慮。用一張去噪估計代替這個平均,可以比較容易計算,但要記得它是近似。
那如果程式只肯回傳分數,不能對輸入微分,剛才的方向就不能直接算。能不能先生成幾張候選,只靠比較分數,改變最後回傳的比例? 這個問題留到 U7.3,再一起看候選數量與計算成本。
本篇的目標、posterior average 和 plug-in 推導,可以在 U7.2 既要像資料,又要 reward 高:我們真正想抽哪個 distribution? 連著讀。