U7.0 約 55 分鐘 2026年10月

模型訓練好了,使用者才說要戴紅帽的狗

先在三條方法路徑預測、畫分布與判讀證據,再完整推導。讀完各路才標記,最後統整並處理跨方法的需求。

想連著讀? 技能書 連續閱讀版 · U7.0 →

收到一個新要求
Nori 戴 orca 帽的北極熊

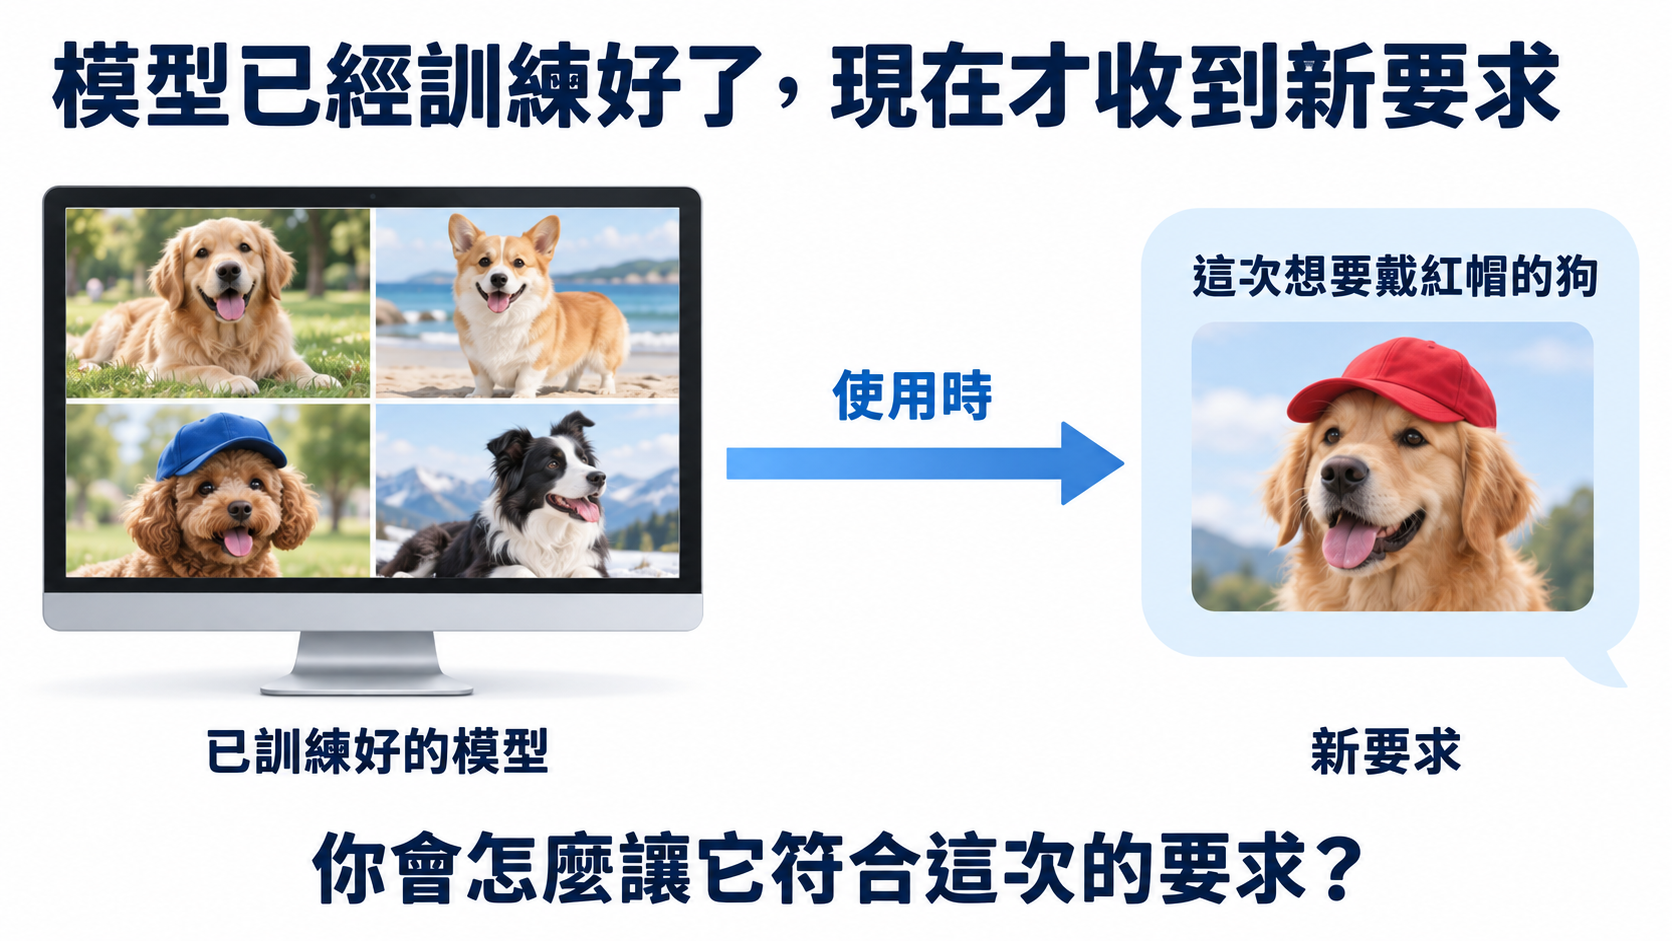
假設我們花了兩週,訓練好一個會生成狗照片的 diffusion model。它能畫出不同毛色、姿勢與背景的狗,偶爾也會畫出戴帽子的狗。使用者看了看結果,這時才說:「這一次,我想要一隻戴紅帽的狗。」

左邊是已訓練模型生成的不同狗照片,右邊是使用時才收到的紅帽狗要求;右圖是要求示意,不是已生成的答案。

模型可能畫出紅帽狗,但這次的要求還沒有交給它。手上這個模型沒有接收文字或類別的輸入,不能直接把「戴紅帽」當成 prompt。

點圖可放大

你把幾張結果攤在工作桌上,請三位學習夥伴一起想辦法:有翅膀的鹿 Lumi、有柴犬臉的柯基 Mugi,以及戴著 orca 帽的北極熊 Nori。他們各有一個提案。

如果是你,會先怎麼讓紅帽狗更常出現? 先把手上的資料說清楚,再選你想完整探索的做法。每條路都會走到訓練或生成的實作,畫出分布後,再回來比較其他做法。

先看資料,再決定從哪條路探索
Nori 戴 orca 帽的北極熊

把兩種可區分的外觀先換成一維資料 x0x_0:左群中心是 −2-2,右群中心是 22,每群標準差都是 σ=0.55\sigma=0.55。右群代表這次偏好的類別;同一群內仍有不同樣本,不把 x0x_0 定義成越大就越好。

-4-2024 左群 · c = 0 右群 · c = 1 density
曲線是已知的資料生成分布;點是實際抽出的訓練資料(每類顯示 32/256 個)。右群作為這次偏好的外觀類別;x₀ 只是教學座標,並非從狗照片量出的特徵。

原本兩群各占一半,這個已知的資料生成分布記成

pbase(x0)=12N(x0;−2,σ2)+12N(x0;2,σ2).p_{\mathrm{base}}(x_0)=\tfrac12\mathcal N(x_0;-2,\sigma^2)+\tfrac12\mathcal N(x_0;2,\sigma^2).

N(x0;μ,σ2)\mathcal N(x_0;\mu,\sigma^2) 是中心為 μ\mu、散布程度由 σ\sigma 決定的 Gaussian density。灰色虛線始終是這個參考 base;實線才是每條路目前的模型或回傳密度。

我們要追蹤的是資料、輸入 cc、模型參數 θ\theta 和回傳規則:這次改動了誰? 先操作可以直接抽樣的 toy generator,再把觀察帶回 diffusion/Flow Matching 的完整訓練式。每條路都會讀完推導並檢查觀察,才回來標記。

選一條路,完整探索它怎麼做

選你想先研究的做法。每條路都有必要的定義、訓練或生成步驟,以及會畫出分布的實作;走到結尾回來,才會標記「已完整探索」。也可以先回列表,稍後接著讀。

條件訓練:先學會使用描述

先讓模型學會看描述
Lumi 有翅膀的鹿

「我們可以整理一批照片,每張都附上描述。像這張狗戴著紅帽,就把『戴紅帽的狗』和照片一起交給模型。讓它練習時就看描述,以後生成也能告訴它這次要什麼。」

Lumi 想增加的是模型的輸入:除了圖片,還要能看一般的 condition,例如類別或文字 prompt,記成 cc。把乾淨圖片記成 x0x_0,訓練資料便是一組組 (x0,c)(x_0,c);模型學的是給定描述後,圖片如何分布:

pθ(x0∣c).p_\theta(x_0\mid c).

其中 θ\theta 是生成模型的參數。對連續圖片,這個 pθp_\theta 表示 probability density,不是抽到某一張精確圖片的機率。給定「戴紅帽的狗」,符合描述的圖片應該得到較大的 density。

在 training 時就把 condition 交給模型,讓它學會依描述生成,稱為「條件訓練」(conditional training)。 它不是每換一句 prompt 就重訓:已學會文字輸入的模型,也可能組合出沒見過的描述。不過我們手上原本的模型還沒有這個輸入,需要先準備這種能力。

先在圖上試這個動作:左右各有 256256 個帶類別的樣本。這個 toy model 收到 cc 後,以對應的平均值 μc\mu_c 抽 Gaussian;可學參數是 (μ0,μ1)(\mu_0,\mu_1),一開始都為 00,標準差固定。先讓它學平均值,再只換 cc,看圖與參數如何回應。

條件訓練:用同一組參數回答兩個類別
Lumi 有翅膀的鹿

先寫下預測,再執行 A/B。看圖上哪條密度換了位置,也看 μ₀、μ₁ 是否真的更新;之後可以用下方控制項只訓練一步,檢查學習尚未完成時的樣子。

資料
帶類別的左右兩群樣本
輸入 c
生成時指定 0 或 1
模型參數 θ
此 toy 學 μ₀、μ₁;換 c 不更新它們
回傳規則
直接從目前模型抽樣

先預測,再做一組對照

兩個平均值學好後,只把 c 從 1 換成 0,密度與參數各會怎麼變?

一維 toy distribution 的密度與生成樣本 灰色虛線是原本左右各半的雙峰分布,細點線是訓練資料的目標分布,實線是目前模型或回傳結果的密度。執行後會加上生成樣本的直方圖。 0.00 0.45 0.90 -4-2024 x₀ density
原本的雙峰分布 資料的目標分布 目前模型/回傳密度 實際生成的直方圖

μ₀ = 0 · μ₁ = 0 · σ = 0.55

先比較圖中的曲線,再試著訓練或生成,觀察直方圖落在哪裡。

標準 A/B 對照的解釋

A、B 用的是同一組已學的 μ₀、μ₁,累計更新都是 60。A 用 c = 1,B 用 c = 0,因此曲線從右移到左;更新紀錄不變才是沒有重訓的證據。若只學一步,兩個均值仍靠近零,切換 c 也不表示已經學好。

示範:用左右各 256 個帶類別的樣本更新兩個平均值後,μ₀ 會接近 −2、μ₁ 接近 2。生成時只換 c,就能選擇左峰或右峰,不必重新更新平均值。

若已自由改動條件或 Python,以你的實際圖與參數為準,不能把這組標準對照當成你的執行紀錄。

這裡真的從 Gaussian mixture 取資料、更新可學參數或選候選,並畫出 density 與 1,000 個生成樣本的直方圖。Toy generator 可以直接抽樣,沒有把它當成訓練完成的 diffusion network。

換你改程式,執行同一個實驗

可以改參數,也可以改抽樣規則。按執行時才載入 Python;運算在你的瀏覽器進行。每次執行從這段程式重新開始,文字不會存檔。

首次展開會帶入上方的控制項設定;之後重開會保留你改過的程式。帶入的是條件,不包含上方累積訓練的參數或生成樣本,因此兩邊的有限抽樣圖不必完全相同。

先只改開頭的 c,再執行。程式分為資料、訓練、生成、畫圖四段;生成段使用訓練段剛學好的參數。整份重跑仍會從初始模型重新訓練。

import math
import numpy as np
import matplotlib.pyplot as plt

# 1. DATA AND SETTINGS -- edit one setting above the model code.
c = 1  # EDIT: 0 = left, 1 = right
steps = 60
rng = np.random.default_rng(42)
sigma = 0.55
grid = np.linspace(-5, 5, 500)
def pdf(x, mu):
    return np.exp(-0.5 * ((x - mu) / sigma) ** 2) / (sigma * np.sqrt(2 * np.pi))
def sample_mixture(n, right=0.5):
    mu = np.where(rng.random(n) < right, 2.0, -2.0)
    return rng.normal(mu, sigma)
base = 0.5 * pdf(grid, -2) + 0.5 * pdf(grid, 2)

data = [rng.normal(mu, sigma, 256) for mu in [-2.0, 2.0]]

# 2. TRAINING -- each full Run starts from these initial means.
means = np.zeros(2)
for _ in range(steps):
    gradient = 0.5 * np.array([means[label] - data[label].mean() for label in [0, 1]])
    means -= 0.15 * gradient

# 3. GENERATION -- both inputs below use the SAME trained means.
for label in [0, 1]:
    print("same trained parameters, c =", label, "uses mean", means[label])
samples = rng.normal(means[c], sigma, 1000)
target = pdf(grid, [-2.0, 2.0][c])
after = pdf(grid, means[c])
print("Trained means:", means)

# 4. PLOTTING -- density curves and the actual returned samples.
plt.figure(figsize=(7, 3.8))
plt.plot(grid, base, color="gray", linestyle="--", label="original base")
plt.plot(grid, target, color="teal", linestyle=":", label="training-data target")
plt.plot(grid, after, color="darkorange", label="model / returned density")
plt.hist(samples, bins=np.linspace(-5, 5, 41), density=True, alpha=0.25, color="darkorange", label="1000 generated outputs")
plt.xlabel("x0")
plt.ylabel("density")
plt.xlim(-5, 5)
plt.legend(fontsize=8)
plt.tight_layout()
plt.show()

兩張圖不同,哪個觀察才能支持沒有重訓?
Lumi 有翅膀的鹿

A/B 對照先學好兩個平均值,再只換 cc。兩次密度中心不同。哪個證據支持這是同一個模型回答不同輸入?

兩個均值與更新次數都沒有改;不同的 c 選用不同的已學均值。

生成出的樣本不同,本來就可能來自同一組固定參數;要直接檢查參數與更新紀錄。

即使只換輸入、不更新,生成分布也可能改變;不能只看最後曲線就斷定被更新的是誰。

真的讓一個模型學會看類別
Lumi 有翅膀的鹿

把左群標成 c=0c=0、右群標成 c=1c=1,每類各抽 m=256m=256 個帶標註的訓練樣本。Toy conditional generator 使用 pθ(x0∣c)=N(x0;μc,σ2)p_\theta(x_0\mid c)=\mathcal N(x_0;\mu_c,\sigma^2),可學參數是 θ=(μ0,μ1)\theta=(\mu_0,\mu_1);一開始兩個平均值都是 00,所以光是提供 cc,還不會讓輸出自動分開。

剛才的更新使用每類已知樣本學平均值。因為 variance 固定,最大化 Gaussian likelihood 等價於最小化平方誤差:

Ltoy=12m∑c=01∑i=1m12(x0(i,c)−μc)2.\mathcal L_{\mathrm{toy}}=\frac{1}{2m}\sum_{c=0}^{1}\sum_{i=1}^{m}\frac12(x_0^{(i,c)}-\mu_c)^2.

對 μc\mu_c 微分,得到 12(μc−xˉc)\tfrac12(\mu_c-\bar x_c);xˉc\bar x_c 是該類資料的平均。程式用這個 gradient 更新兩個平均值,生成時再由 cc 決定用哪一個。這裡訓練的是能直接抽樣的 Gaussian model。接著換回 diffusion/Flow Matching,檢查讓網路多看 cc 時,noise/velocity regression 要改什麼。

多看描述,答案也要換嗎?
Lumi 有翅膀的鹿

Lumi 想沿用 U1 預測 noise 的練習。從一對圖片與描述抽出 x0,cx_0,c,選 noise level tt,加入已知的 noise ϵ\epsilon 得到 xtx_t。網路這次多看 cc。原本拿來對答案的量,應該保留哪一個?

沿用 noise prediction 的 regression,就保留實際加入的 noise 作為 label;condition 是新增的輸入。

描述是希望網路多看的資訊,不是這個 noise prediction 練習的答案。

本來在做 noise prediction,label 是 noise。也可以另外設計預測乾淨圖片的模型,但不是這次只增加 condition 輸入的修改。

描述加入了,原本的答案要換嗎?
Lumi 有翅膀的鹿

「它原本是在練習預測 noise。我們可以保留這個練習,只讓它多看描述嗎?」

可以。從一對 (x0,c)(x_0,c) 抽出圖片與描述,選一個 noise level tt,把已知的 noise ϵ\epsilon 加進圖片,得到 xtx_t。網路現在看 xt,t,cx_t,t,c,輸出 noise prediction ϵθ(xt,t,c)\epsilon_\theta(x_t,t,c);拿來對答案的仍是實際加入的 ϵ\epsilon。

於是要降低的預測誤差是

Ldiff,cond(θ)=Ex0,c,t,ϵ[∥ϵ−ϵθ(xt,t,c)∥2].\begin{gathered} \mathcal L_{\mathrm{diff,cond}}(\theta)\\ =\mathbb E_{x_0,c,t,\epsilon}\Big[\\ \|\epsilon-\epsilon_\theta(x_t,t,c)\|^2\Big]. \end{gathered}

Expectation 平均訓練的圖片與描述、抽到的時間,以及加入的 noise。平方誤差衡量「預測和已知 noise 差多少」;用它更新 θ\theta,模型就有機會學會在不同描述下做不同預測。

這裡沿用 diffusion 的時間:tt 越大,圖片的 noise 越多;生成則往 t=0t=0 的乾淨端走。新增的是網路可以看的 cc,regression label 沒有換成文字,也仍不是完成的圖片。

換成預測 velocity,也能多看描述嗎?
Lumi 有翅膀的鹿

若手上是 Flow Matching,原本練習預測的答案是 reference path 的 velocity。先把 noise 端點記成 X0X_0、資料端點記成 X1X_1,condition cc 跟著資料端點;這裡沿用它從 t=0t=0 的 source 走向 t=1t=1 的 data 的時間,和剛才 diffusion 的方向分開。

例如選一條直線 reference path:

It=(1−t)X0+tX1,∂tIt=X1−X0.\begin{gathered} I_t=(1-t)X_0+tX_1,\\ \partial_t I_t=X_1-X_0. \end{gathered}

訓練時端點已知,所以能算出這個 velocity label。把 It,t,cI_t,t,c 一起交給 velocity network,它的預測是 vθ(It,t,c)v_\theta(I_t,t,c);仍和原本的 label 比較:

LFM,cond(θ)=Et,(X0,X1,c)[∥vθ(It,t,c)−∂tIt∥2].\begin{gathered} \mathcal L_{\mathrm{FM,cond}}(\theta)\\ =\mathbb E_{t,(X_0,X_1,c)}\Big[\\ \|v_\theta(I_t,t,c)-\partial_t I_t\|^2\Big]. \end{gathered}

這個 expectation 平均抽到的端點、condition 和路徑上的時間。生成時還不知道資料端點,要用學到的 velocity 逐步走;reference path 用來造訓練例子,不是先替每個生成樣本指定好終點或路線。

Lumi 的提案對兩種模型做了同一個修改:保留原本的 regression label,讓網路多看 cc。 Condition 在訓練中影響 θ\theta,這就是 conditional training。

兩種模型,多看描述時保留什麼?
Lumi 有翅膀的鹿

Diffusion 的網路練習預測 noise,Flow Matching 的網路練習預測 reference velocity。Lumi 對兩種模型做的是同一種修改嗎?

兩種網路原本預測的量不同,但都能在保留原本答案時多看 condition。

Flow Matching 的 label 是 reference velocity,不是 diffusion 加入的 noise;不能因為都加了 condition 就把兩個答案混在一起。

訓練時已知端點,才造得出 reference velocity。生成時終點尚未知,也不會因此先知道整條生成路線。

這條路走完了:學到的能力與生成時的輸入
Lumi 有翅膀的鹿

現在模型的兩個平均值已經從帶類別的資料學習。固定 θ\theta 後,生成時換 cc,就能使用另一個條件分布;可以回到圖上,只換輸入再觀察一次。

條件訓練要先準備圖片與 condition 的關聯,訓練時更新參數,生成時才有這個輸入可用。對已學會文字輸入的模型,換一句可理解的 prompt 不等於重訓;對我們原本沒有這個輸入的模型,則要先建立這種能力。

這次學平均值是 toy model 的設計。條件訓練的核心是讓模型學會使用 cc,並不限定參數只能是平均值。

微調:用新資料更新原模型

用喜歡的圖片,讓原本模型繼續學
Mugi 有柴犬臉的柯基

「我們已經有會畫狗的模型了,先讓它畫一批,再挑出喜歡的紅帽狗照片。拿這些照片繼續練習,會不會就更常畫出我們喜歡的樣子?」

Mugi 想改的是拿來學習的資料:保留已有的模型,用新收集的偏好圖片繼續訓練。這稱為 「微調」(fine-tuning)。原本模型不接收描述,這條路也不必先替它增加文字輸入。

要求雖然在原本模型訓練完後才出現,偏好仍會透過訓練被寫進 θ\theta。下次使用的是更新後的模型。至於原本的練習保留什麼、參數怎麼更新,等一下再一起把它寫出來。

先用原本左右各半的 toy model 做一次對照。這個版本先把中心與標準差固定,只讓參數 θ\theta 決定右峰的混合權重;後面會把權重和 loss 寫清楚。讓模型從偏好資料學過一次,再只換資料、不更新,看看它會不會自己忘掉剛才學到的偏好。

微調:只換資料,模型會自動改變嗎?
Mugi 有柴犬臉的柯基

先預測模型與資料分開改動的結果,再執行 A/B。圖下的 loss 用目前資料評估模型;先觀察它和參數的變化,後面完整推導計算方式。

資料
新取得的偏好樣本
輸入 c
這個模型沒有 c 輸入
模型參數 θ
此 toy 只學混合權重的 logit
回傳規則
直接從目前模型抽樣

先預測,再做一組對照

把偏好資料從右群 90% 換成 10%,但不更新模型:右峰權重、生成分布與目前資料的 loss,哪些會變?

一維 toy distribution 的密度與生成樣本 灰色虛線是原本左右各半的雙峰分布,細點線是訓練資料的目標分布,實線是目前模型或回傳結果的密度。執行後會加上生成樣本的直方圖。 0.00 0.45 0.90 -4-2024 x₀ density
原本的雙峰分布 資料的目標分布 目前模型/回傳密度 實際生成的直方圖

原本模型:左右各半 · μ = −2, 2 · σ = 0.55

先比較圖中的曲線,再試著訓練或生成,觀察直方圖落在哪裡。

標準 A/B 對照的解釋

A 更新模型後,B 只把評估資料換成左群較多,θ、模型右峰權重與更新次數都保留。所以兩條模型密度重疊;loss 卻還依賴評估資料,換了資料可以變高。Loss 改變本身不能證明 θ 改變。

示範:原本的右峰權重是 0.5。換成約 90% 在右峰的偏好資料,以 likelihood 更新混合權重後,生成的質量會往右峰集中。停止訓練後再生成,仍會使用更新後的權重。

若已自由改動條件或 Python,以你的實際圖與參數為準,不能把這組標準對照當成你的執行紀錄。

這裡真的從 Gaussian mixture 取資料、更新可學參數或選候選,並畫出 density 與 1,000 個生成樣本的直方圖。Toy generator 可以直接抽樣,沒有把它當成訓練完成的 diffusion network。

換你改程式,執行同一個實驗

可以改參數,也可以改抽樣規則。按執行時才載入 Python;運算在你的瀏覽器進行。每次執行從這段程式重新開始,文字不會存檔。

首次展開會帶入上方的控制項設定;之後重開會保留你改過的程式。帶入的是條件,不包含上方累積訓練的參數或生成樣本,因此兩邊的有限抽樣圖不必完全相同。

先只改開頭的 preferred_right,再重跑,觀察新偏好經過訓練後是否留在模型權重。每次整份重跑都從 logit = 0 開始;上方已訓練的參數不會帶入。

import math
import numpy as np
import matplotlib.pyplot as plt

# 1. DATA AND SETTINGS -- edit one setting above the model code.
preferred_right = 0.9  # EDIT: share in the new DATA
steps = 60
rng = np.random.default_rng(42)
sigma = 0.55
grid = np.linspace(-5, 5, 500)
def pdf(x, mu):
    return np.exp(-0.5 * ((x - mu) / sigma) ** 2) / (sigma * np.sqrt(2 * np.pi))
def sample_mixture(n, right=0.5):
    mu = np.where(rng.random(n) < right, 2.0, -2.0)
    return rng.normal(mu, sigma)
base = 0.5 * pdf(grid, -2) + 0.5 * pdf(grid, 2)

data = sample_mixture(512, preferred_right)

# 2. TRAINING -- update the original model on the preferred DATA.
logit = 0.0
for _ in range(steps):
    right = 1 / (1 + np.exp(-logit))
    density = (1 - right) * pdf(data, -2) + right * pdf(data, 2)
    responsibility = right * pdf(data, 2) / density
    gradient = right - responsibility.mean()
    logit -= 0.3 * gradient

# 3. GENERATION -- retain the learned weight; no new update here.
right = 1 / (1 + np.exp(-logit))
samples = sample_mixture(1000, right)
target = (1 - preferred_right) * pdf(grid, -2) + preferred_right * pdf(grid, 2)
after = (1 - right) * pdf(grid, -2) + right * pdf(grid, 2)
print("Updated logit:", logit, "right-mode probability:", right)

# 4. PLOTTING -- density curves and the actual returned samples.
plt.figure(figsize=(7, 3.8))
plt.plot(grid, base, color="gray", linestyle="--", label="original base")
plt.plot(grid, target, color="teal", linestyle=":", label="training-data target")
plt.plot(grid, after, color="darkorange", label="model / returned density")
plt.hist(samples, bins=np.linspace(-5, 5, 41), density=True, alpha=0.25, color="darkorange", label="1000 generated outputs")
plt.xlabel("x0")
plt.ylabel("density")
plt.xlim(-5, 5)
plt.legend(fontsize=8)
plt.tight_layout()
plt.show()

模型曲線重疊,loss 為什麼仍會變?
Mugi 有柴犬臉的柯基

A/B 對照中,右群資料從約 90%90\% 換成 10%10\%,θ\theta、模型右峰權重和累計更新次數都相同,B 的 loss 卻較高。這和哪個解釋一致?

Loss 也依賴拿來評估的資料。模型保留右群偏好,換成左群較多的資料後,負 log-likelihood 可以變高。

A、B 的參數與更新次數明明相同。只看 loss 變化,不能推論程式偷偷訓練。

兩組有限抽樣的直方圖不會完全相同,但確切模型密度與權重保留;抽樣差異不等於忘掉偏好。

沿用原本雙峰模型,真的更新它的權重
Mugi 有柴犬臉的柯基

這次保留兩個 Gaussian component 的中心與標準差,只讓原本模型的混合權重可學。用一個參數 θ\theta 表示右峰權重 wθ=1/(1+e−θ)w_\theta=1/(1+e^{-\theta}):

pθ(x0)=(1−wθ)N(x0;−2,σ2)+wθN(x0;2,σ2).p_\theta(x_0)=(1-w_\theta)\mathcal N(x_0;-2,\sigma^2)+w_\theta\mathcal N(x_0;2,\sigma^2).

原本 θ=0\theta=0,左右各半。我們新收集 512512 個偏好樣本,先讓右群約占 90%90\%。這次不提供 cc;用新資料的 negative log-likelihood 更新同一個參數:

Ltoy,FT(θ)=−1m∑i=1mlog⁡pθ(x0(i)).\mathcal L_{\mathrm{toy,FT}}(\theta)=-\frac1m\sum_{i=1}^m\log p_\theta(x_0^{(i)}).

程式先算 ri=wθN(x0(i);2,σ2)/pθ(x0(i))r_i=w_\theta\mathcal N(x_0^{(i)};2,\sigma^2)/p_\theta(x_0^{(i)}),也就是目前模型判斷該樣本來自右群的比例;gradient 是 wθ−1m∑iriw_\theta-\frac1m\sum_i r_i。用它更新 θ\theta 後,我們再從新的 pθp_\theta 生成,檢查質量有沒有往偏好資料移動。

這個例子固定中心,只學權重,是為了讓圖容易比較。一般微調也可以更新中心、其他網路權重或整個參數集合;判斷仍要看原模型是否繼續從新資料學習。

挑好的圖片,怎麼拿來繼續練習?
Mugi 有柴犬臉的柯基

把 Mugi 挑出的偏好資料記成 Dpref\mathcal D_{\mathrm{pref}}。原本模型不接收 cc,所以這批資料先包含乾淨圖片 x0(i)x_0^{(i)},不替它硬加描述。

從這批圖片抽出 x0x_0,選時間 tt、加入 noise ϵ\epsilon 得到 xtx_t。我們仍比較預測的 noise 與實際加入的 noise,只是圖片換成偏好資料:

Lalign(θ;Dpref)=Ex0∼Dpreft,ϵ[∥ϵ−ϵθ(xt,t)∥2].\begin{gathered} \mathcal L_{\mathrm{align}} (\theta;\mathcal D_{\mathrm{pref}})\\ =\mathbb E_{\substack{x_0\sim\mathcal D_{\mathrm{pref}}\\t,\epsilon}}\Big[\\ \|\epsilon-\epsilon_\theta(x_t,t)\|^2\Big]. \end{gathered}

這個 loss 衡量模型在偏好圖片上的 noise prediction 誤差,平均的是從這批資料抽出的圖片、時間與 noise。偏好資料改變了,但仍沿用原本的 regression 練習。

如果原本已是 conditional model,就收集 (x0,c)(x_0,c),讓 prediction 也使用 cc;Flow Matching 則可以沿用 velocity regression,改在偏好資料上練習。共同點是拿來更新模型的資料分布改了。

晚收到要求,也可能更新參數
Mugi 有柴犬臉的柯基

有了剛才的 loss,就可以用 gradient descent 讓模型繼續學:

θ←θ−η∇θLalign(θ;Dpref).\begin{gathered} \theta\leftarrow\theta\\ -\eta\nabla_\theta \mathcal L_{\mathrm{align}} (\theta;\mathcal D_{\mathrm{pref}}). \end{gathered}

這次對 θ\theta 求 gradient,因為想改的是模型裡學到的參數。Gradient 指向 loss 上升的方向,所以前面的負號讓它往降低誤差的方向更新;learning rate η\eta 決定一次改多少。

Mugi 的要求在原本模型訓練完後才出現,但它仍透過這個更新被寫進 θ\theta。明天即使不提供挑圖的程式,使用的也已是更新後的模型。

其他 alignment 方法也可能使用成對比較或 reward weighting;這裡選的是可以直接算的偏好資料 regression。判斷界線時,要看原本的 θ\theta 有沒有更新,不能只看要求來得早或晚。

Mugi 這次想改動的是誰?
Mugi 有柴犬臉的柯基

剛才的更新式有 ∇θLalign\nabla_\theta\mathcal L_{\mathrm{align}}。這個 gradient 是在提供什麼的修改方向?

微分的下標是 θ,對應網路裡會被學習的參數。

這次對 θ 微分,不是對正在生成的圖片輸入微分。兩個改動對象需要分開。

偏好圖片用來造訓練例子;這個更新式改的是網路參數,不是把既有照片改畫一遍。

微調一定只能改左右比例嗎?
Mugi 有柴犬臉的柯基

這個 toy 為了容易看圖,只開放混合權重學習。現在把兩個 Gaussian 的平均值也設成可學,繼續用偏好資料更新原模型。這還是微調嗎?

微調的判斷依據是原模型從新資料繼續更新參數,不是指定只能學某一種參數。

條件訓練建立的是使用 c 的能力;參數剛好是平均值,不能決定它是不是條件訓練。

Steering 保留生成模型參數。這裡已明說更新平均值,因此不符合固定參數的操作。

這條路走完了:偏好寫進了原本參數
Mugi 有柴犬臉的柯基

微調後,即使不再提供偏好資料、不再打分,只按生成,也會使用更新後的混合權重。改變的已經是模型的 pθp_\theta;要適應另一批資料,還得再執行參數更新。

這個 toy 實作直接使用 density likelihood,前面對 diffusion 示範的是偏好資料上的 noise regression。兩者共同的界線是:原本模型繼續從新資料學習,θ\theta 會變。

生成時引導:保留模型,改這次的計算

保留模型,請幫手參與這次生成
Nori 戴 orca 帽的北極熊

「原本會畫狗的模型先保留。這次想要紅帽,我們另外找一個會判斷紅帽的幫手。它可以幫忙挑結果;如果也看得懂未完成的圖片,就試著在途中提醒。」

Nori 想讓這次要求影響生成或挑選的計算,同時保留生成模型的參數 θ\theta。這稱為 「生成時引導」(test-time steering)。幫手可能有自己的準備與訓練成本,但這次沒有因此覆寫原本生成模型。

Steering 包含途中調整與最後挑選;在每一步額外加入方向的做法,也常稱為 guidance。今天用紅帽的判斷,明天可以換另一個任務的訊號,原本的 θ\theta 都能保留。

只在最後挑,也能引導嗎?
Nori 戴 orca 帽的北極熊

「回到紅帽狗。如果幫手只會看完成的照片,那先讓模型畫好幾張,最後留分數最高的,行不行?」

可以。從原本模型獨立生成 NN 張候選,評分後只回傳最高者,稱為 Best-of-NN。候選各自的生成過程沒變,但最後挑選會改變回傳結果的 distribution,也屬於 steering。

它不需要 reward 的 gradient,也不必改模型內部。可是如果模型原本很少畫出紅帽狗,只靠最後挑,會花多少生成計算呢?

先讓 R(x0)=x0R(x_0)=x_0,也就是這次偏好較大的座標。原本模型始終左右各半;每組候選生成完才挑一個。觀察這個評分是否也保留我們想要的群內差異。

Steering:候選更多,回傳分布如何改變?
Nori 戴 orca 帽的北極熊

先預測 N 從 1 換成 32 的結果,再執行 A/B。直方圖畫每組最後回傳的樣本;請同時看右群比例、峰的位置,以及完整候選的成本。

資料
固定模型生成的候選
輸入 c
這個模型沒有 c 輸入
模型參數 θ
中心、標準差、權重全部固定
回傳規則
每組 N 個,按 reward 留一個

先預測,再做一組對照

固定模型、用 R(x₀) = x₀ 挑選,N 從 1 增到 32:只是右群變多,還是右群內的位置與形狀也改了?

一維 toy distribution 的密度與生成樣本 灰色虛線是原本左右各半的雙峰分布,實線是目前模型或回傳結果的密度。執行後會加上生成樣本的直方圖。 0.00 0.45 0.90 -4-2024 x₀ density
原本的雙峰分布 目前模型/回傳密度 實際生成的直方圖

原本模型:左右各半 · μ = −2, 2 · σ = 0.55

先比較圖中的曲線,再試著訓練或生成,觀察直方圖落在哪裡。

標準 A/B 對照的解釋

兩次候選都來自權重 0.5 的同一個模型;N = 32 多做了候選與挑選,沒有多做訓練。取最大值偏好右尾,峰的位置與形狀因而改變。這不保證保留原右群形狀,也不保證 reward 已代表完整需求。

示範:固定左右各半的模型,獨立畫 8 個候選,只回傳 x₀ 最大的樣本。右側與右尾會更常被回傳;改成取最小值則偏向左側。原本模型的兩個平均值與混合權重都沒有更新。

若已自由改動條件或 Python,以你的實際圖與參數為準,不能把這組標準對照當成你的執行紀錄。

這裡真的從 Gaussian mixture 取資料、更新可學參數或選候選,並畫出 density 與 1,000 個生成樣本的直方圖。Toy generator 可以直接抽樣,沒有把它當成訓練完成的 diffusion network。

換你改程式,執行同一個實驗

可以改參數,也可以改抽樣規則。按執行時才載入 Python;運算在你的瀏覽器進行。每次執行從這段程式重新開始,文字不會存檔。

首次展開會帶入上方的控制項設定;之後重開會保留你改過的程式。帶入的是條件,不包含上方累積訓練的參數或生成樣本,因此兩邊的有限抽樣圖不必完全相同。

先只改開頭的 N,對照候選成本與回傳密度;再改 direction 反轉 reward。模型權重始終固定。

import math
import numpy as np
import matplotlib.pyplot as plt

# 1. DATA AND SETTINGS -- edit one setting above the model code.
N = 8
direction = 1  # EDIT: R(x0) = direction * x0
rng = np.random.default_rng(42)
sigma = 0.55
grid = np.linspace(-5, 5, 500)
def pdf(x, mu):
    return np.exp(-0.5 * ((x - mu) / sigma) ** 2) / (sigma * np.sqrt(2 * np.pi))
def sample_mixture(n, right=0.5):
    mu = np.where(rng.random(n) < right, 2.0, -2.0)
    return rng.normal(mu, sigma)
base = 0.5 * pdf(grid, -2) + 0.5 * pdf(grid, 2)

# 2. FIXED MODEL -- no training or parameter update.
# 3. GENERATION AND SELECTION -- create actual candidates, then compare rewards.
batch = sample_mixture(1000 * N).reshape(1000, N)
indices = np.argmax(direction * batch, axis=1)
samples = batch[np.arange(1000), indices]
def cdf(x, mu):
    return np.array([0.5 * (1 + math.erf((v - mu) / (sigma * np.sqrt(2)))) for v in x])
F = 0.5 * cdf(grid, -2) + 0.5 * cdf(grid, 2)
after = N * base * (F if direction > 0 else 1 - F) ** (N - 1)
print("Base right-mode probability is still 0.5; complete generations:", 1000 * N)

# 4. PLOTTING -- density curves and the actual returned samples.
plt.figure(figsize=(7, 3.8))
plt.plot(grid, base, color="gray", linestyle="--", label="original base")
plt.plot(grid, after, color="darkorange", label="model / returned density")
plt.hist(samples, bins=np.linspace(-5, 5, 41), density=True, alpha=0.25, color="darkorange", label="1000 generated outputs")
plt.xlabel("x0")
plt.ylabel("density")
plt.xlim(-5, 5)
plt.legend(fontsize=8)
plt.tight_layout()
plt.show()

峰向右移,代表原模型學會新偏好了嗎?
Nori 戴 orca 帽的北極熊

A/B 中,原模型的右峰權重都是 0.50.5。N=32N=32 的回傳峰卻比原本右峰中心更靠右。哪個判讀同時符合參數與圖?

候選仍來自同一個模型,取最大值偏好右尾,所以回傳分布改了。

參數紀錄與候選模型都固定。回傳峰改變,不等於模型接受了訓練。

圖上的峰已向右尾移動。只選高分結果,不會自動保留原本右群的形狀。

把剛才挑選的動作寫清楚
Nori 戴 orca 帽的北極熊

剛才每組先獨立生成 x0(1),…,x0(N)∼pbasex_0^{(1)},\ldots,x_0^{(N)}\sim p_{\mathrm{base}},再算

i∗=arg⁡max⁡i=1,…,NR(x0(i)),xreturn=x0(i∗).i^*=\arg\max_{i=1,\ldots,N}R(x_0^{(i)}),\qquad x_{\mathrm{return}}=x_0^{(i^*)}.

R(x0)=x0R(x_0)=x_0 時,這就是挑最大值;換成 −x0-x_0 則挑最小值。程式把這個動作做 1,0001,000 組,每組回傳一個,直方圖因此有 1,0001,000 個結果;成本卻是 1,000N1,000N 個完整候選。原模型的中心、標準差與權重都不更新。

回傳密度為什麼能和候選密度不同?先從「最大值不超過某個位置」這件事算起。

挑最大值,為什麼會往尾端集中?
Nori 戴 orca 帽的北極熊

把原本樣本的累積分布記成 F(x)=P(X≤x)F(x)=P(X\le x),density 記成 f(x)f(x)。若挑最大的那個,回傳值不超過 xx,就表示 NN 個候選全都不超過 xx;獨立生成讓這個機率相乘:

P(Xmax⁡≤x)=F(x)N,fmax⁡(x)=Nf(x)F(x)N−1.P(X_{\max}\le x)=F(x)^N,\qquad f_{\max}(x)=Nf(x)F(x)^{N-1}.

圖中的回傳密度就是把這個式子數值算出來,再和真正抽出的直方圖對照。增加 NN 會改變最後回傳的分布,也可能讓結果集中到尾端;這和單純抽取原本某一群,是不同的操作。

多一個幫手,原本模型仍保留嗎?
Nori 戴 orca 帽的北極熊

Nori 找來一個已經會判斷紅帽的網路,生成時固定兩個網路的參數,只用它的評分挑選結果。這仍符合保留生成模型參數的 test-time steering 嗎?

Nori 可以改用什麼方向?
Nori 戴 orca 帽的北極熊

如果想保留 θ\theta,可以改這次 sampler 使用的計算。例如 score-based sampler 原本使用 sθ(xt,t)s_\theta(x_t,t),也就是對圖片 density 取 log,再對目前圖片 xtx_t 求 gradient 的估計。

假設能取得這次要求的額外方向 gt(xt)g_t(x_t),sampling 可以暫時使用

s~t(xt)=sθ(xt,t)+gt(xt),θ fixed.\begin{gathered} \widetilde s_t(x_t)\\ =s_\theta(x_t,t)+g_t(x_t),\\ \theta\ \text{fixed}. \end{gathered}

第一項保留模型原本的資訊,第二項希望讓結果更符合這次要求。這裡只是描述可以改用的方向;gtg_t 要怎麼取得、相加是否對應我們想抽的分布,還得接著檢查,不能只把要求的名字寫進公式就算完成。

原本網路沒有重新學,sampler 這次改用合成的 prediction。生成圖片的 xtx_t 仍會改變,但生成模型的 θ\theta 可以固定。

換一種要求,幫手要回答什麼?
Nori 戴 orca 帽的北極熊

「紅帽可以請幫手辨認。可是使用者給一張模糊照片、希望還原它,或只說比較喜歡某種構圖,幫手還是在回答同一個問題嗎?」

這些要求提供的資訊不同。Condition 是希望指定的內容,例如「戴紅帽的狗」;observation 是這次已經取得的量測,例如要還原的模糊照片;reward 則是一個打分標準,告訴我們哪種結果比較符合這次偏好。

模糊照片的量測可以用來檢查生成結果是否符合觀測,評分程式可以比較不同構圖。原本模型不會自動知道這次新取得的資訊;得先讓它進入生成或挑選的計算,才有機會影響結果。

新障礙物,會自己進入計算嗎?
Nori 戴 orca 帽的北極熊
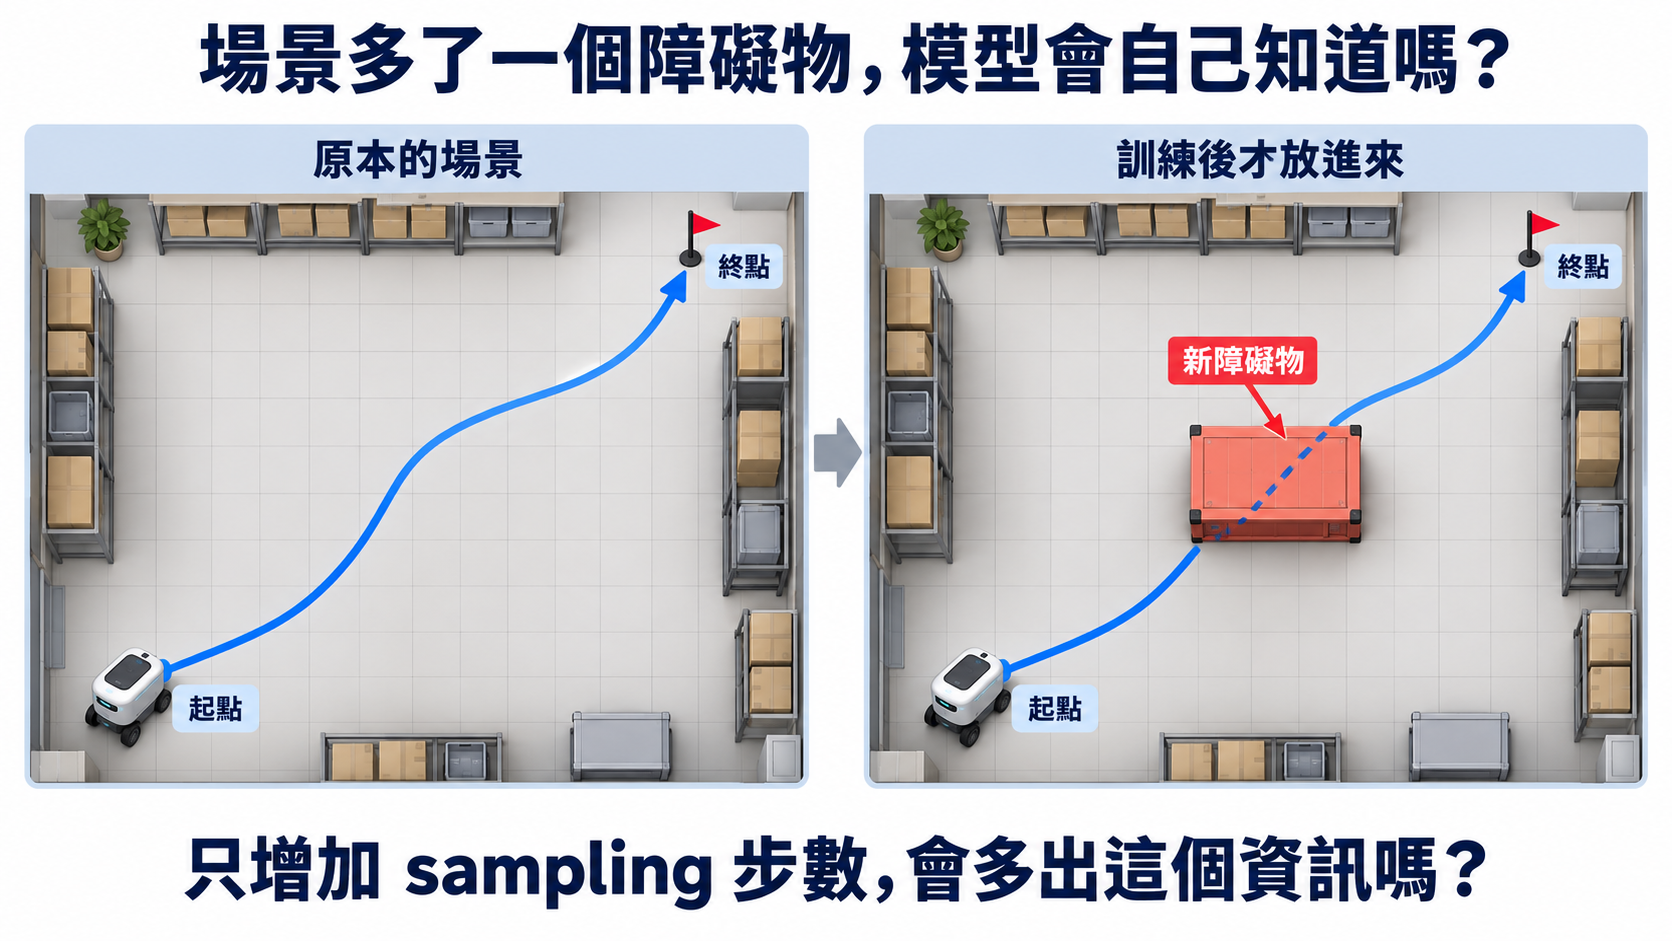
兩張倉庫圖保持相同起點、終點與藍色路線;右圖新增紅色障礙物,舊路線仍穿過它。

藍線是機器人在倉庫裡走的路線;diffusion 在生成這整條路線,兩種時間要分開。

點圖可放大

路線模型訓練好時,走道還是空的;今天多了一個箱子,原本路線會撞上它。我們沒有提供新場景,也沒有碰撞評分,只把 sampling 步數加倍。這會把箱子的位置當成新資訊,加入生成計算嗎?

兩次都沒畫對,有多常發生?
Nori 戴 orca 帽的北極熊

假設每次從 base model 獨立生成,畫出符合要求的紅帽狗的機率是 pp;一次沒畫對的機率就是 1−p1-p。

現在生成兩張。兩張都沒畫對的機率是多少? 接著試著推到 NN 張:先算全部失敗,再用 11 減掉它,就能得到至少成功一次的機率。

也可以先在心裡想,再看整理。文字只留在這個頁面,重新載入就會消失。

候選變多,成功率與花費都變了
Nori 戴 orca 帽的北極熊

獨立生成讓「每次都沒成功」的機率相乘,所以 NN 張都失敗是 (1−p)N(1-p)^N;至少命中一次則是它的補事件:

P(至少命中一次)=1−(1−p)N.\begin{gathered} P(\text{至少命中一次})\\ =1-(1-p)^N. \end{gathered}

例如 p=0.01p=0.01,生成 1010 張至少命中的機率約 9.6%9.6\%,生成 100100 張約 63.4%63.4\%。即使候選有一百張,也沒有保證一定命中。

固定想達到的成功率 0<a<10<a<1,並假設 0<p<10<p<1。要讓 (1−p)N≤1−a(1-p)^N\le 1-a,因此

N≥log⁡(1−a)log⁡(1−p).N\ge\frac{\log(1-a)}{\log(1-p)}.

當 pp 很小,log⁡(1−p)≈−p\log(1-p)\approx-p,所需的 NN 就和 1/p1/p 同一個量級。成功比較容易,代價是多生成完整候選;幫手只在結尾評分,還沒替那些差一點成功的圖片在途中修正方向。

這條路走完了:改的是回傳規則與生成計算
Nori 戴 orca 帽的北極熊

我們真的從同一個 base 生成候選、算分數、挑結果,沒有更新生成模型的參數。圖上改變的是最後回傳結果的分布;成本則隨每次完整生成的候選數增加。

Steering 也可以嘗試在途中加入方向,前面已把這個位置寫清楚;下一篇才檢查幫手如何看懂 noisy image。對這條路,目前能確認的是:保留 θ\theta,仍能讓這次的訊號影響結果;分數較高的分布,也未必等於使用者完整想要的分布。

模型沒變,圖片怎麼還在變?
Nori 戴 orca 帽的北極熊

三位夥伴的提案都能嘗試。Lumi 讓模型學會看描述,Mugi 拿偏好圖片繼續學,Nori 則請幫手參與這次的生成或挑選。

可是模型明明一直把 noise 改成圖片,為什麼 Nori 還能說「參數沒變」?因為模型裡學到的參數 θ\theta,和生成途中正在改變的圖片 xtx_t,是不同的東西。改動這次如何生成 xtx_t,不一定要更新 θ\theta。

三條路都已完整讀過,也看過實作的分布。現在才用比較表複習:要求在哪個階段加入、參數有沒有更新,以及生成時多做了什麼。

最後統整:把做過的操作放回三種方法
Nori 戴 orca 帽的北極熊

把剛才親手操作的動作放回對應的方法。這是複習;需要時可以回上方的方法列表重看完整內容。

Lumi · 要求加入的階段 訓練時,把圖片和描述一起交給網路。
Mugi · 要求加入的階段 模型已存在,再挑出偏好圖片讓它繼續學。
Nori · 要求加入的階段 生成或挑選時,請幫手提供這次的判斷。
Lumi · 是否更新參數 會,根據有描述的訓練例子更新參數。
Mugi · 是否更新參數 會,用新的偏好資料更新原本參數。
Nori · 是否更新參數 不會,保留原本參數,調整這次生成或挑選。
Lumi · 生成時的操作 把描述交給已經學會看描述的模型。
Mugi · 生成時的操作 使用已在偏好圖片上更新過的模型。
Nori · 生成時的操作 用幫手的訊號調整 sampling 或挑選結果。

換個需求:以後每次都要能指定類別
Lumi 有翅膀的鹿

我們可以重新準備帶類別的訓練資料,希望部署後直接給 cc 就能指定左群或右群;每次生成不另外評分或挑候選。哪個提案直接建立這種能力?

帶類別資料參與訓練,模型學會使用 c;部署後換輸入即可。

只用一批偏好資料更新無條件模型,會改整體分布,沒有因此增加可切換的 c 輸入。

這個提案要在生成後另外評分與挑選,和部署後直接給 c 的限制不同。

再換個需求:讓原模型長期偏向新資料
Mugi 有柴犬臉的柯基

這次可以改原本的 θ\theta,手上只有新收集的偏好資料,要沿用原模型結構;部署時不另外給描述,也不執行評分與挑選。哪個操作符合?

這會新增輸入與配對資料的準備,不是題目要沿用原結構、直接用現有偏好資料更新的操作。

新偏好透過訓練寫入 θ,之後直接使用更新後的模型。

最後挑選保留 θ,而且部署時仍要執行評分與挑選,與這次要求不同。

現在加上這次的限制
Nori 戴 orca 帽的北極熊

使用者希望今天試紅帽、明天試圍巾,而且原本生成模型的參數保持不變。三位夥伴剛才的提案,哪一個符合這次限制?

Lumi 的方法讓 condition 參與訓練,會改變學到的參數。這次想保留的是原本那套 θ。

Mugi 雖然比較晚才拿到要求,仍用偏好資料更新了原本模型。

多做評估或調整 sampler,不一定需要更新生成模型參數。

模型本來就會看描述,換 prompt 還要重訓嗎?
Lumi 有翅膀的鹿

這次換了一個前提:模型早已透過配對資料學會文字輸入。今天只換一個它有能力處理的描述組合,直接用同一組 θ\theta 生成,沒有外部評分或額外 guidance。哪個說明最符合?

已建立的條件輸入可以在生成時重複使用。新描述組合不等於新增模型從未學過的輸入類型。

條件訓練是建立使用 c 的能力,不是每次提供新的 c 都再更新 θ。

模型原本就能直接接收 c,且題目沒有增加評分或額外引導。固定 θ 本身不能證明另外用了 Best-of-N。

一個流程可以同時使用兩種方法嗎?
Mugi 有柴犬臉的柯基

上午先用偏好資料更新原模型;下午固定更新後的參數,每次生成 1616 個候選,只回傳 reward 最高的那個。請按計算先後判斷這條流程。

上午的新資料更新 θ 是微調;下午固定那組 θ,只改最後回傳規則,是 Best-of-N steering。

下午確實固定參數,但上午明確執行了原模型更新,不能把整段都當成沒有訓練。

下午沒有再更新參數,只按 reward 挑結果;候選較多本身不會把挑選變成微調。

需求不只要高分:用剛才的圖提出證據
Nori 戴 orca 帽的北極熊

使用者現在說:「我想讓右群更常出現,但右群內仍保留原本的分布形狀。」你手上只能用剛才的 R(x0)=x0R(x_0)=x_0,有人提議把 NN 一直加大。

回想 N=1N=1 與 N=32N=32 的對照。你會直接接受嗎?請指出圖上的一個證據,再說明需要重新檢查哪個假設。若要重看,可以回上方的 steering 路徑。

也可以先在心裡想,再看整理。文字只留在這個頁面,重新載入就會消失。

高 reward 和指定分布,要分別檢查
Nori 戴 orca 帽的北極熊

不能只因右群變多就直接接受。N=32N=32 的回傳峰向原右峰的尾端移動,群內形狀也改了;但原本生成模型的右峰權重仍是 0.50.5。這是挑最大值造成的回傳分布,不是把原右群照原比例直接抽出來。

因此要重新檢查 「R(x0)=x0R(x_0)=x_0 是否代表完整需求」,以及這個挑選規則會產生什麼分布。增加候選能提高最大 reward,卻沒有保證保留使用者要的群內形狀。之後需要設計並檢查目標分布;不能只拿較高的平均分數當作證據。

同樣先挑圖片,後面做了什麼?
Mugi 有柴犬臉的柯基

Mugi 和 Nori 都可能先生成一批紅帽狗照片。哪個操作,才是這次保留原本參數的最後挑選?

同樣有挑圖片這個動作,要看挑完是直接回傳,還是拿它們更新模型。

把選出的圖片拿來繼續訓練,會更新原本模型參數;這是微調。

獨立生成更多候選增加的是生成與評估的成本,本身不是模型參數更新。

幫手喜歡,圖片就一定好嗎?
Lumi 有翅膀的鹿

紅帽評分程式很喜歡一大片紅色:一張不像狗的紅色圖案也拿到高分;另一批結果都是同一隻狗、同一個姿勢。只看平均 reward 變高,夠判斷 steering 的效果嗎?

高分可以和不合理的圖片、過度集中同時發生。需要一起看 data fidelity 與 diversity。

這個紅色圖案已經展示,程式可能給不像資料的輸入高分。

每次同一張即使看起來合理,也沒有保留使用者可能想要的不同結果。

能不能在途中就提醒?
Nori 戴 orca 帽的北極熊

現在我們能分清三位夥伴的提案:訓練時學會使用描述、拿新資料微調,或保留參數、用這次訊號引導生成與挑選。要求來得晚,仍然來得及加入;關鍵是它透過哪個計算影響結果。

最後挑選可行,但目標很少見時要多生成許多候選,也沒幫差一點成功的圖片途中改方向。能不能在圖片還只有模糊輪廓時,就判斷它有沒有朝紅帽或柯基的要求前進? 接著要檢查幫手能看什麼、方向怎麼取得。

本篇的同一批概念、loss 與比較,也可以在 U7.0 模型已經訓練好,現在才知道想要什麼,還來得及嗎? 連著讀。